
爬虫---Beautiful Soup 通过添加不同的IP请求
上一篇爬虫写了如何应付反爬的一些策略也简单的举了根据UA的例子,今天写一篇如何根据不同IP进行访问豆瓣网获取排行版
requests添加IP代理
如果使用代理的话可以通过requests中的方法proxies
def request(method, url, **kwargs):

    """Constructs and sends a :class:`Request <Request>`.

    :param proxies: (optional) Dictionary mapping protocol to the URL of the proxy.

太多了,删除了一些留下了主要
会有人问,这么多代理去哪里找?小编百度了找了一些发现西刺代理挺好用的。
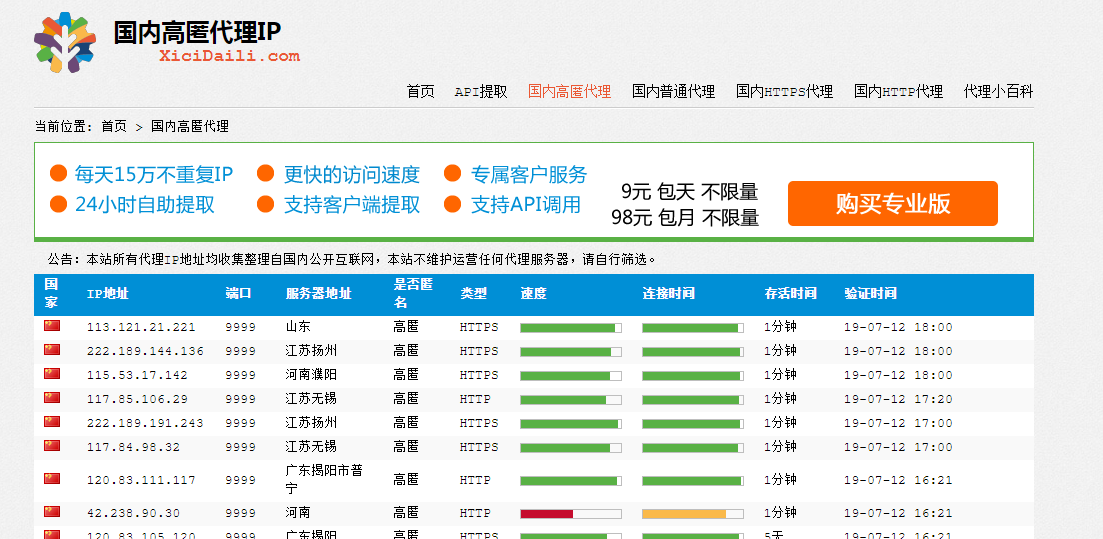
随便从里面找1个进行发请求
# coding:utf-8

import requests

url ="http://httpbin.org/get"

proxy = '117.191.11.73:80'

proxies = {

    'http':'http://'+proxy,

    'https':'https://'+ proxy

           }

r  =requests.get(url,proxies=proxies)

print(r.text)

代码结果:

{

  "args": {},

  "headers": {

    "Accept": "*/*",

    "Accept-Encoding": "gzip, deflate",

    "Host": "httpbin.org",

    "User-Agent": "python-requests/2.21.0",

    "X-Via": "Cache-363"

  },

  "origin": "117.191.11.73, 117.191.11.73",

  "url": "https://httpbin.org/get"

}
通过代理抓取豆瓣网
1.通过requests请求地址:https://movie.douban.com/top250
2.添加代理IP
3.通过Beautiful Soup获取Html页面
4.进行分析Html页面,完成对导演,电影名称,评分的抓取
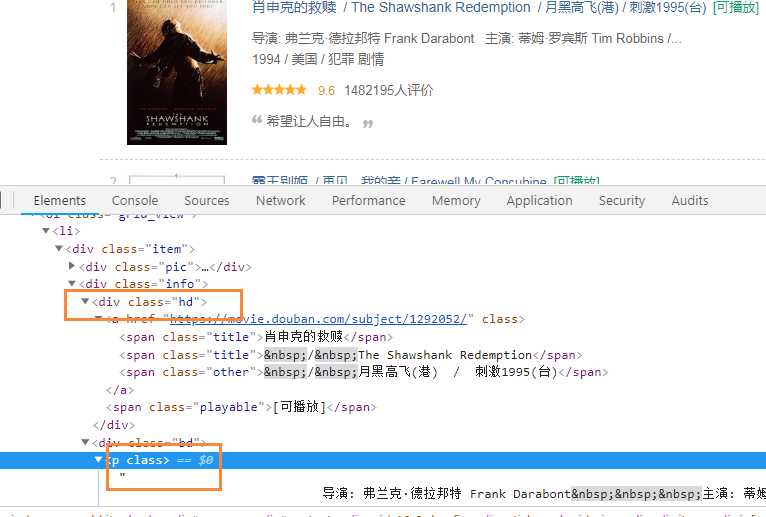
代码结果:
import requests

from  bs4 import BeautifulSoup

import re

# 请求头

headers = {

'user-agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit'

              '/537.36 (KHTML, like Gecko) Chrome/53.0.2785.104 Safari/537.36 Core/1.53.2372.400 QQBrowser/9.5.10548.400'

}

# 添加代理

proxies = {

'http':'http://113.121.22.92:808',}

r = requests.get(url,headers=headers,proxies=proxies)

html = r.content.decode('utf-8')

blog = BeautifulSoup(html,'html.parser')

daoyan = blog.find_all('p',class_='')   # 导演

titles  = blog.find_all('div',class_='hd')    # 电影名称

pingfen = blog.find_all('span',class_='rating_num')    # 评分

for title,daoya, pingfe in zip(titles,daoyan,pingfen):

    m = title.get_text().split('\n')[2]

    x = daoya.get_text().strip()

    x1 = re.findall(r'导演: (.*?)\xa0',x)

    cc = pingfe.get_text()

    print(m)

    print(x1)

    print(cc)
代码执行完后发现只抓取了第一页的数据,而我们想要的时候全部数据,那么我们就继续分析URL路径
# 第一页的URL地址

https://movie.douban.com/top250

# 第二页的URL地址

https://movie.douban.com/top250?start=25&filter=

# 第三页的URL地址

https://movie.douban.com/top250?start=50&filter=
经过观察我们可以发现后面唯一变得数据就是start,那么我们可以通过拼接URL获取全部数据,并且把这么数据写入到TXT文件中
import requests

from  bs4 import BeautifulSoup

import re

page = 0

base_url = 'https://movie.douban.com/top250?start='

# 通过循环拼接URL

while page<10:

    url = base_url + str(25*page)

    page += 1

# 请求头

    headers = {

    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) '
'/Chrome/53.0.2785.104 Safari/537.36 Core/1.53.2372.400 QQBrowser/9.5.10548.400'

    }

# IP代理

    proxies = {

    'http':'http://113.121.22.92:808',}

    r = requests.get(url,headers=headers,proxies=proxies)

    html = r.content.decode('utf-8')

    blog = BeautifulSoup(html,'html.parser')

    daoyan = blog.find_all('p',class_='')   # 导演

    titles  = blog.find_all('div',class_='hd')    # 电影名称

    pingfen = blog.find_all('span',class_='rating_num')    # 评分

    for title,daoya, pingfe in zip(titles,daoyan,pingfen):

        m = title.get_text().split('\n')[2]

        x = daoya.get_text().strip()

        x1 = re.findall(r'导演: (.*?)\xa0',x)

        cc = pingfe.get_text()

# 写入到txt文件中

        with open('123.txt','a+',encoding='utf-8')as f :

            f.write('{m}\t{x1}\t{cc}\n'.format(m=m,x1=x1,cc=cc))
通过查看TXT文件,发现已经成功的获取到了豆瓣网的电影信息。
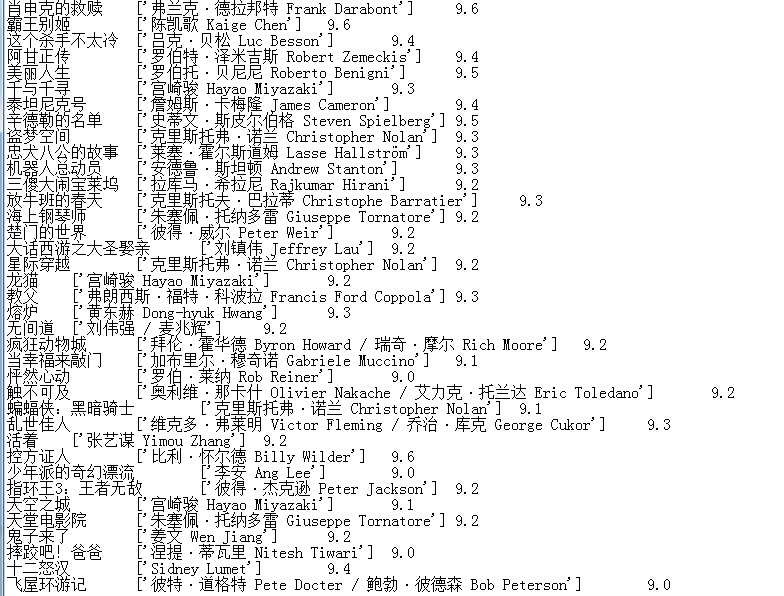
这个案例只是简单的表达我们可以通过IP代理的方式进行来完成爬虫(当然不用代理一样可以请求成功,只是简单的表达下思想,思想学会了,其他的都是简单的问题了)
以后我们如果遇到了封IP的网站都可以通过添加IP代理的方式进行爬取数据;
如果感觉安静写的内容对你有帮助,请点击个关注,内容持续更新中~~~~~
爬虫---Beautiful Soup 通过添加不同的IP请求的更多相关文章
- 爬虫---Beautiful Soup 反反爬虫事例
前两章简单的讲了Beautiful Soup的用法,在爬虫的过程中相信都遇到过一些反爬虫,如何跳过这些反爬虫呢?今天通过知乎网写一个简单的反爬中 什么是反爬虫 简单的说就是使用任何技术手段,阻止别人批 ...
- 爬虫---Beautiful Soup 初始
我们在工作中,都会听说过爬虫,那么什么是爬虫呢? 什么是网络爬虫 爬虫基本原理 所谓网络爬虫就是一个自动化数据采集工具,你只要告诉它要采集哪些数据,丢给它一个 URL,就能自动地抓取数据了.其背后的基 ...
- 爬虫-Beautiful Soup模块
阅读目录 一 介绍 二 基本使用 三 遍历文档树 四 搜索文档树 五 修改文档树 六 总结 一 介绍 Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通 ...
- 爬虫---Beautiful Soup 爬取图片
上一篇简单的介绍Beautiful Soup 的基本用法,这一篇写下如何爬取网站上的图片,并保存下来 爬取图片 1.找到一个福利网站:http://www.xiaohuar.com/list-1-1. ...
- Python爬虫利器:Beautiful Soup
Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.使用它来处理HTML页面就像JavaScript代码操作HTML DOM树一样方便.官方中文文档地址 1. 安 ...
- python爬虫之解析库Beautiful Soup
为何要用Beautiful Soup Beautiful Soup是一个可以从HTML或XML文件中提取数据的Python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文档的方式, 是一个 ...
- python 爬虫利器 Beautiful Soup
python 爬虫利器 Beautiful Soup Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文 ...
- 使用Beautiful Soup编写一个爬虫 系列随笔汇总
这几篇博文只是为了记录学习Beautiful Soup的过程,不仅方便自己以后查看,也许能帮到同样在学习这个技术的朋友.通过学习Beautiful Soup基础知识 完成了一个简单的爬虫服务:从all ...
- 网络爬虫: 从allitebooks.com抓取书籍信息并从amazon.com抓取价格(1): 基础知识Beautiful Soup
开始学习网络数据挖掘方面的知识,首先从Beautiful Soup入手(Beautiful Soup是一个Python库,功能是从HTML和XML中解析数据),打算以三篇博文纪录学习Beautiful ...
随机推荐
- 21.Java基础_String类
String类构造方法 package pack1; //推荐使用直接赋值的方式得到字符串 public class test { public static void main(String[] a ...
- gn gen ninja
- TeamyinyinFish-> 测试报告
测试人员 1. 姓名:鱼嘤嘤 2. 年龄: 21 3. 职业: 大三学生 4. 感情状况: 单身 用户故事 软件工程课上,老师想要他们组实现一个小组项目,鱼嘤嘤原本想摸鱼,但是转念一想觉得 还是需要好 ...
- 计算多个点中距离最远的两个点 python
import numpy as npfrom scipy import spatial print("hello")# test pointspts = np.random.ran ...
- layui教程---table
layui.config({ base: "${ctx}/static/js/" }).use(['form', 'layer', 'jquery', 'common','elem ...
- Paper | Quality assessment of deblocked images
目录 1. 故事 2. 失真变化 3. 方法(PSNR-B) 4. 实验 这篇文章提出了一个PSNR-B指标,旨在衡量 压缩图像的块效应强度 或 去块效应后的残留块效应强度(比较去块效应算法的优劣). ...
- MyBatis 获取插入记录的 id
现在的项目改用 Guns 了,也是一个很不错的框架,用起来也感觉很不错,上手也挺方便的.毕竟对于只是应用层面的知识,也基本上就是看看手册,熟悉熟悉就可以轻松上手了.如果是想要深入,或者刨根问底,那么就 ...
- Vue.js 源码分析(三十二) 总结
第一次写博客,坚持了一个多月时间,Vue源码分析基本分析完了,回过头也看也漏了一些地方,比如双向绑定里的观察者模式,也可以说是订阅者模式,也就是Vue里的Dep.Watcher等这些函数的作用,网上搜 ...
- Vue.js 源码分析(三十一) 高级应用 keep-alive 组件 详解
当使用is特性切换不同的组件时,每次都会重新生成组件Vue实例并生成对应的VNode进行渲染,这样是比较花费性能的,而且切换重新显示时数据又会初始化,例如: <!DOCTYPE html> ...
- .Net轻松处理亿级数据--clickhouse及可视化界面安装介绍
该篇内容由个人博客点击跳转同步更新!转载请注明出处! 前言 我是在17年就听说过Clickhouse,那时还未接触过亿数据的运算,那时我在的小公司对于千万数据的解决方案还停留在分库分表,最好的也是使用 ...