
python3网络爬虫(2.1):爬取堆糖美女
额,明明记得昨晚存了草稿箱,一觉醒来没了,那就简写点(其实是具体怎么解释我也不太懂/xk,纯属个人理解,有错误还望指正)
环境:
版本:python3
IDE:pycharm2017.3.3
浏览器:火狐(浏览器建议火狐,Chrome)
爬取网站:堆糖
选堆糖是因为比较好爬取(除了img文件就是xhr文件),别网站的反爬取对我这个水平来说都太心机了
安装配置什么的之前都写过,这里就不提了,直接开始
1.先来浏览一下这个网站,打开堆糖官网,搜索校花,他就会给我们推荐一些图片,当我们滚动到页面底部时,他又会加载新的一些图片,再滚到底,再加载,这样加载了五次,才把第一页的所有图片加载出来(这里体现了这个网站的防爬,不过也好破)
我们的目标就是把这19页,每页的图片都爬下来
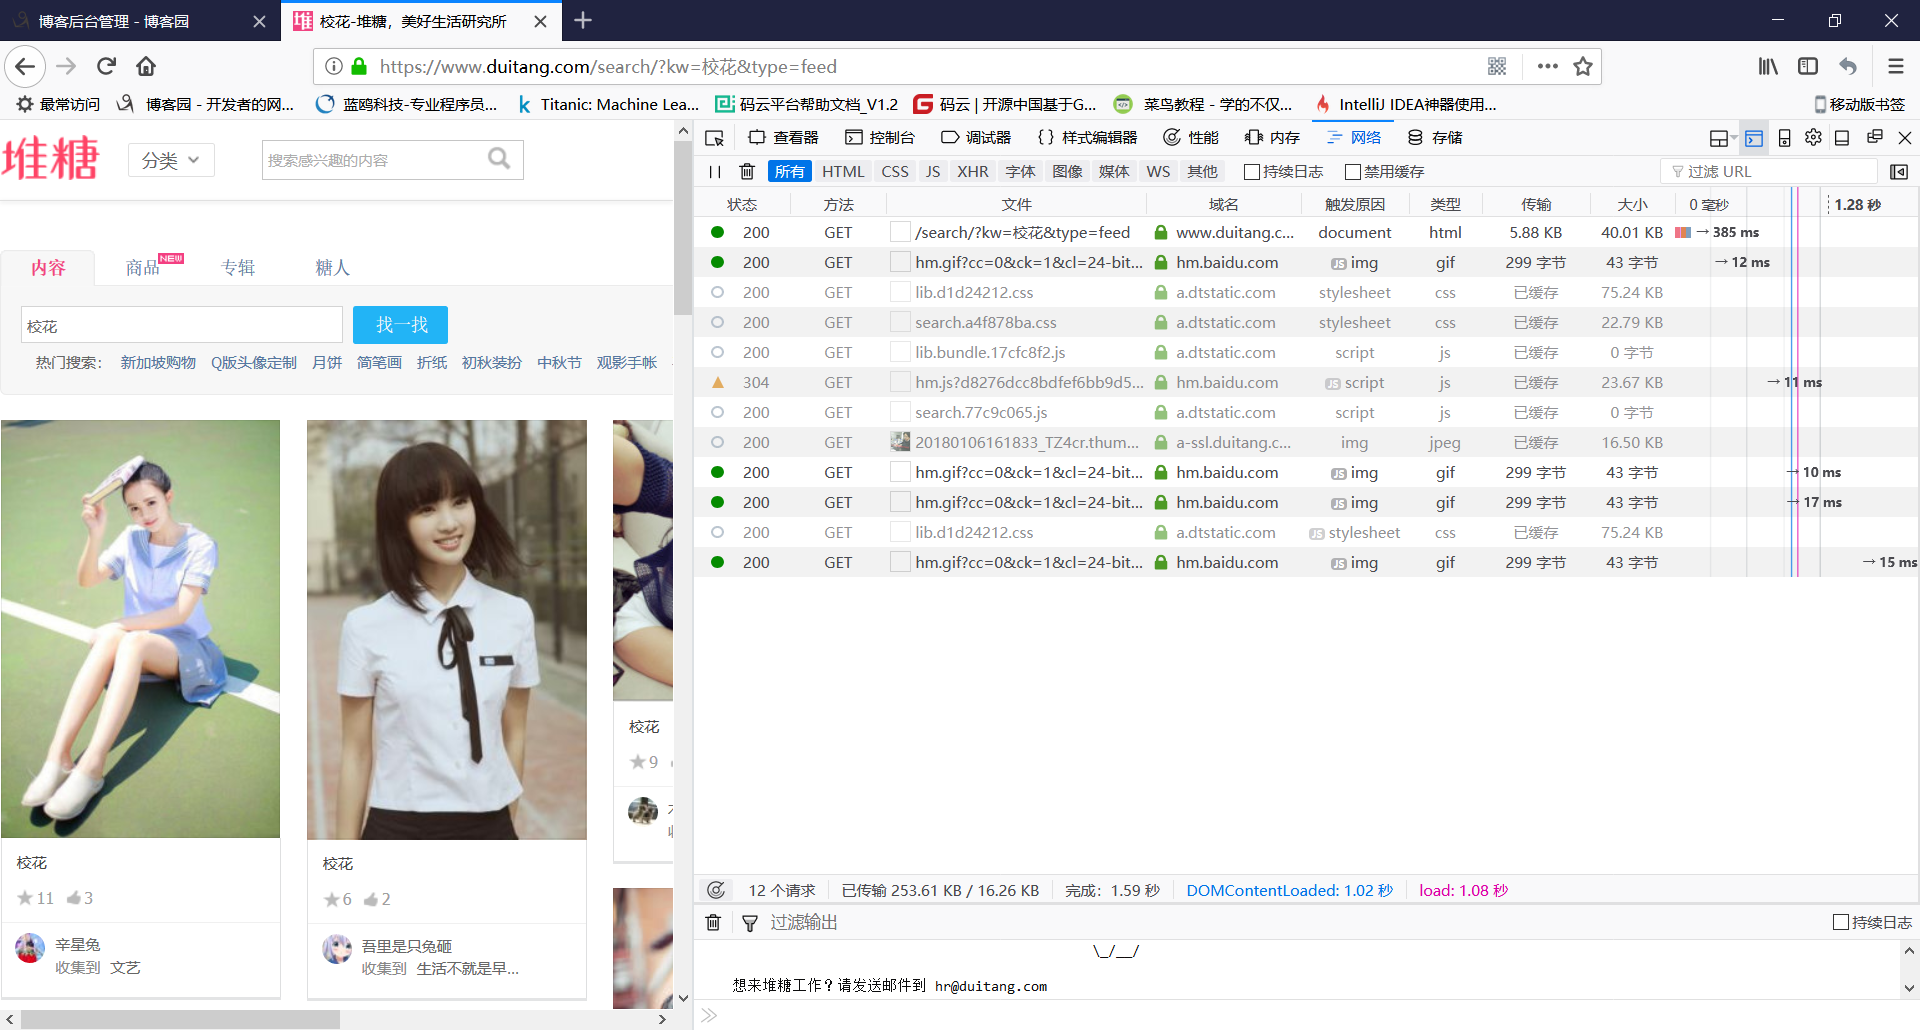
2.重新搜索一下关键字,我们先不往下滚动,右键查看元素,选择网络,可以看到目前这一页中加载的图片,
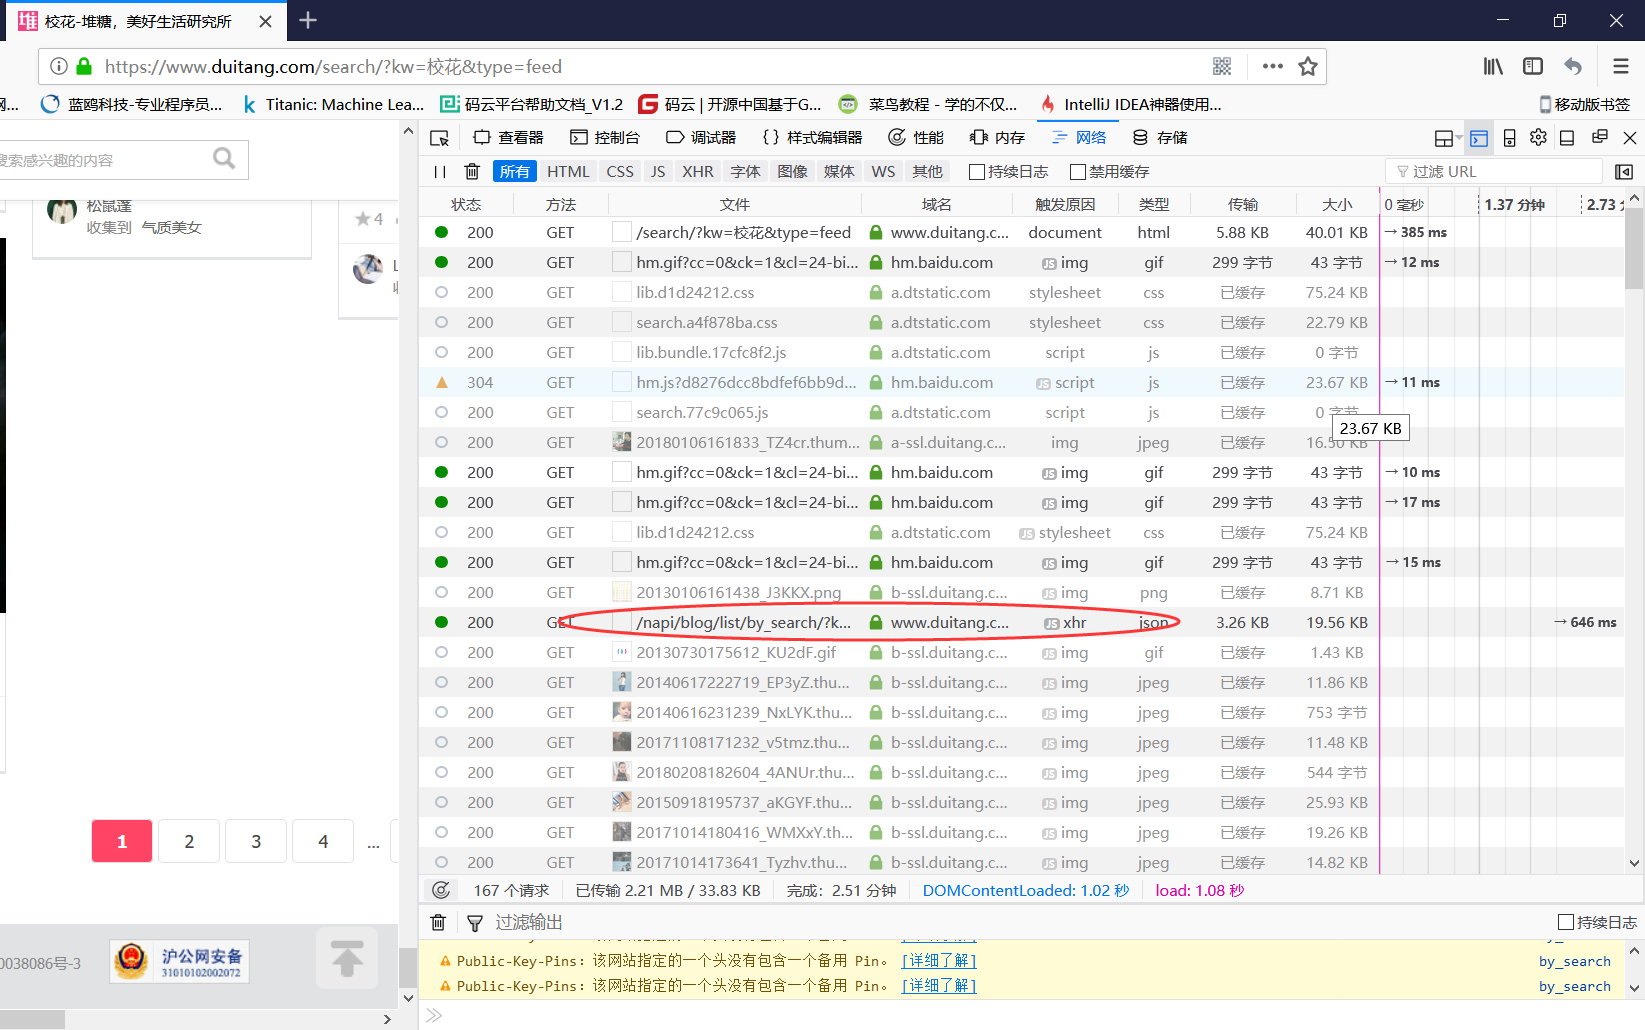
3.然后我们把页面往下滚动,让他继续加载,同时我们观察者网络这个窗口,所有请求的图片也都显示在这里,这时发现xhr类型的文件,这样的文件一共有五个,也就是同一页面中每次滚动到页面底部,新加载图片时就会出现这样的文件
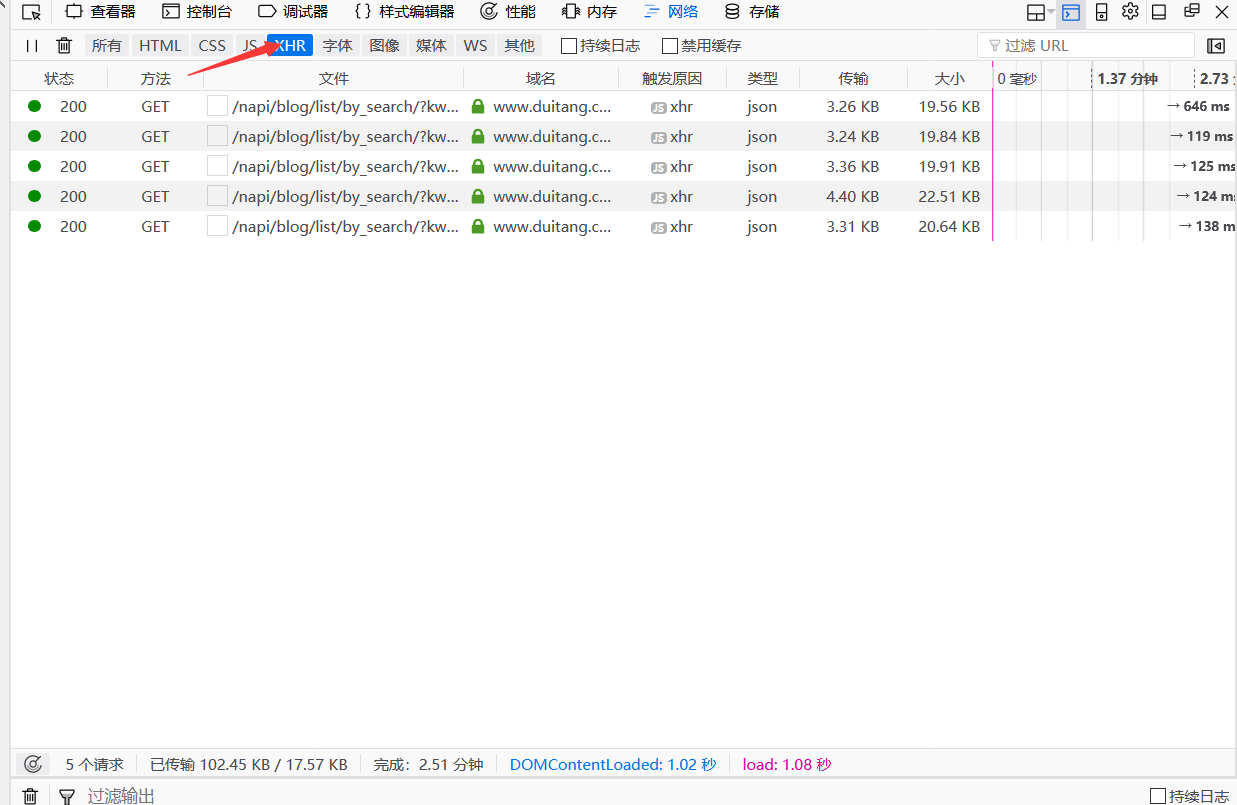
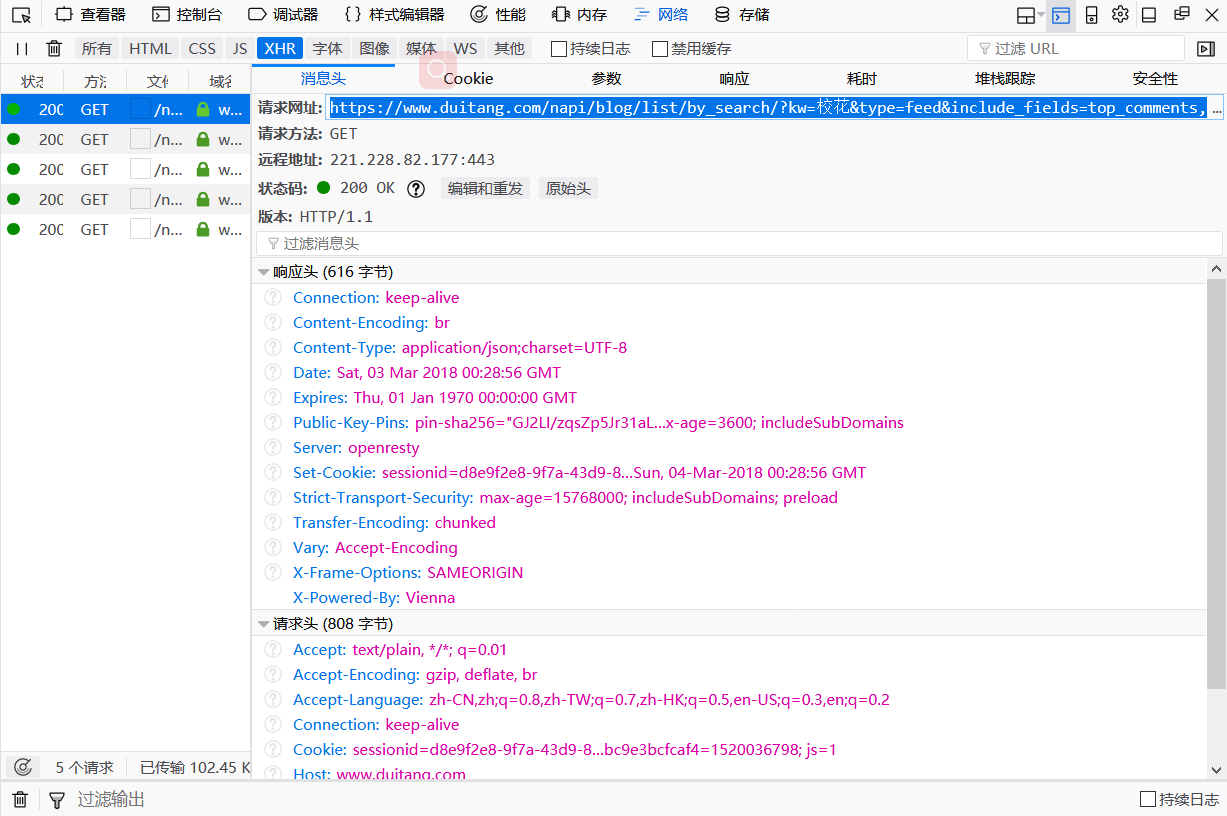
4.主要关注一下这个文件,把窗口切换到xhr类型下,双击打开其中的一个
5.这个请求网址使我们需要的,复制到地址栏中
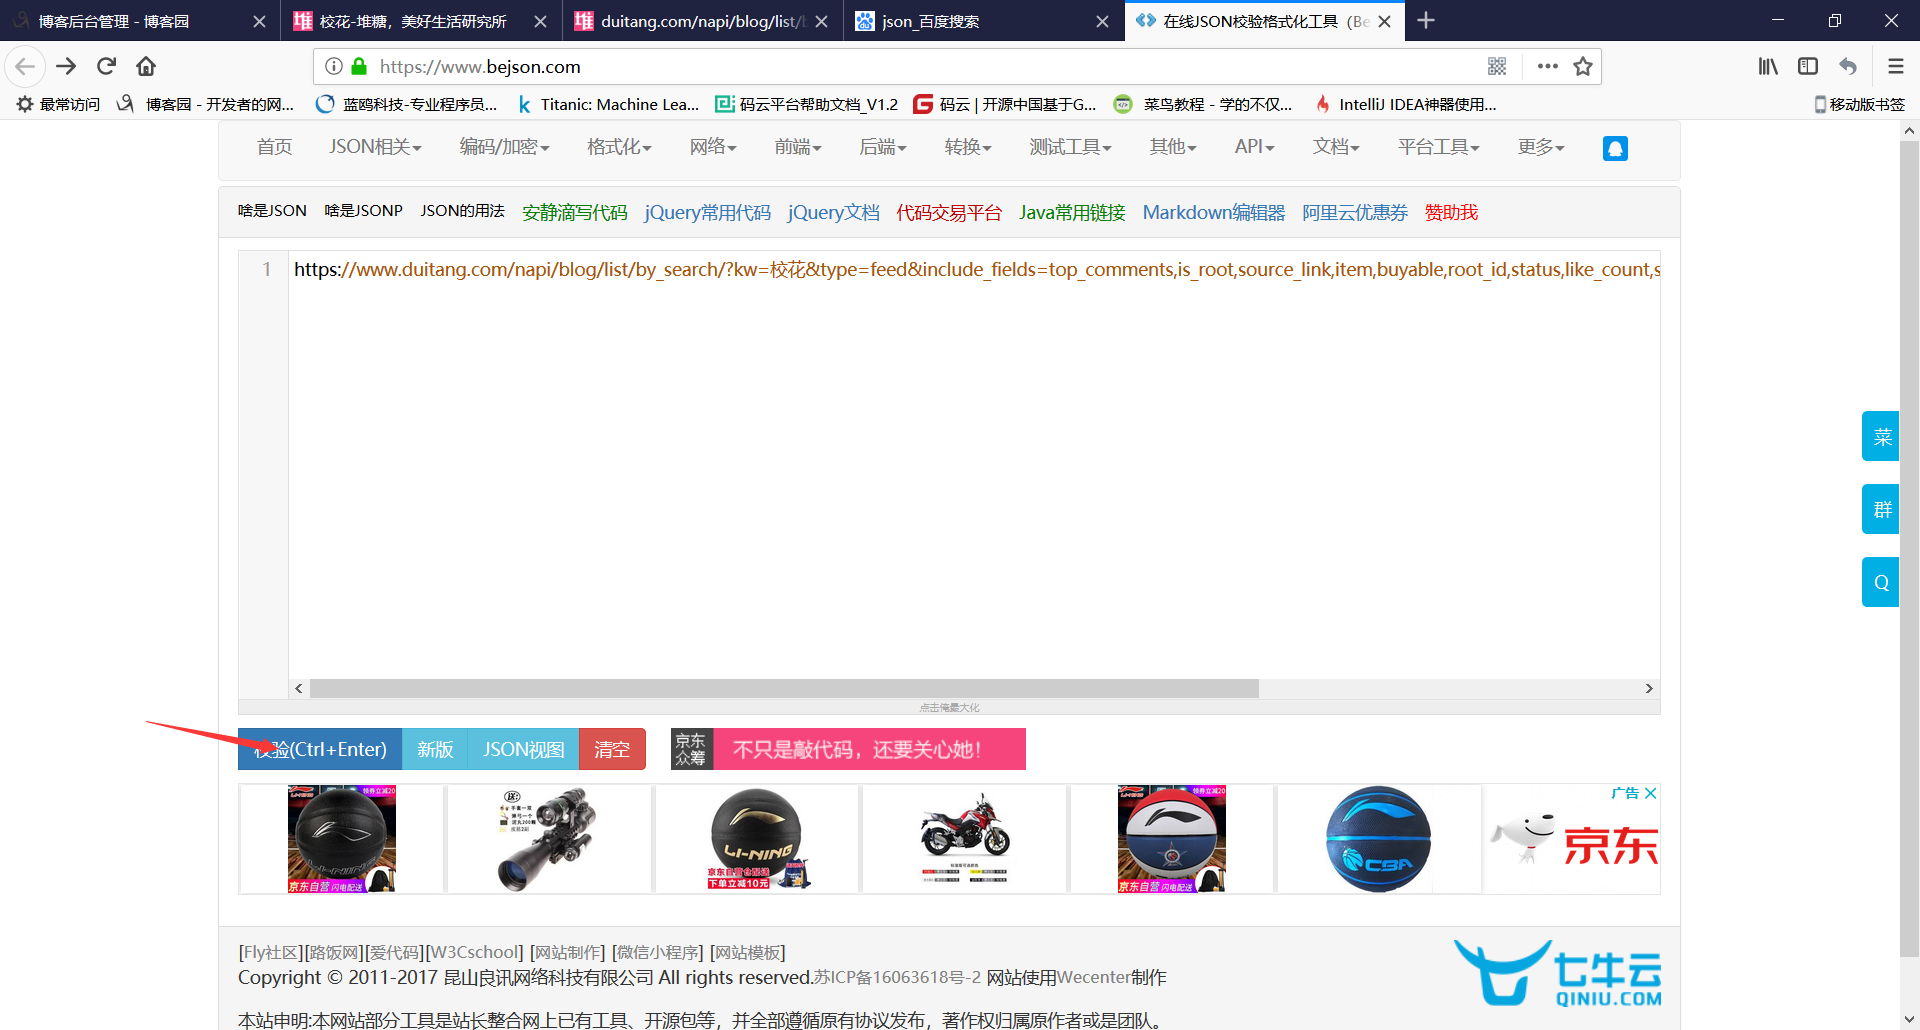
6.这里打开如果是所有代码堆在一起的那样,就需要在线解析一下,解析工具将地址复制进去进行校验
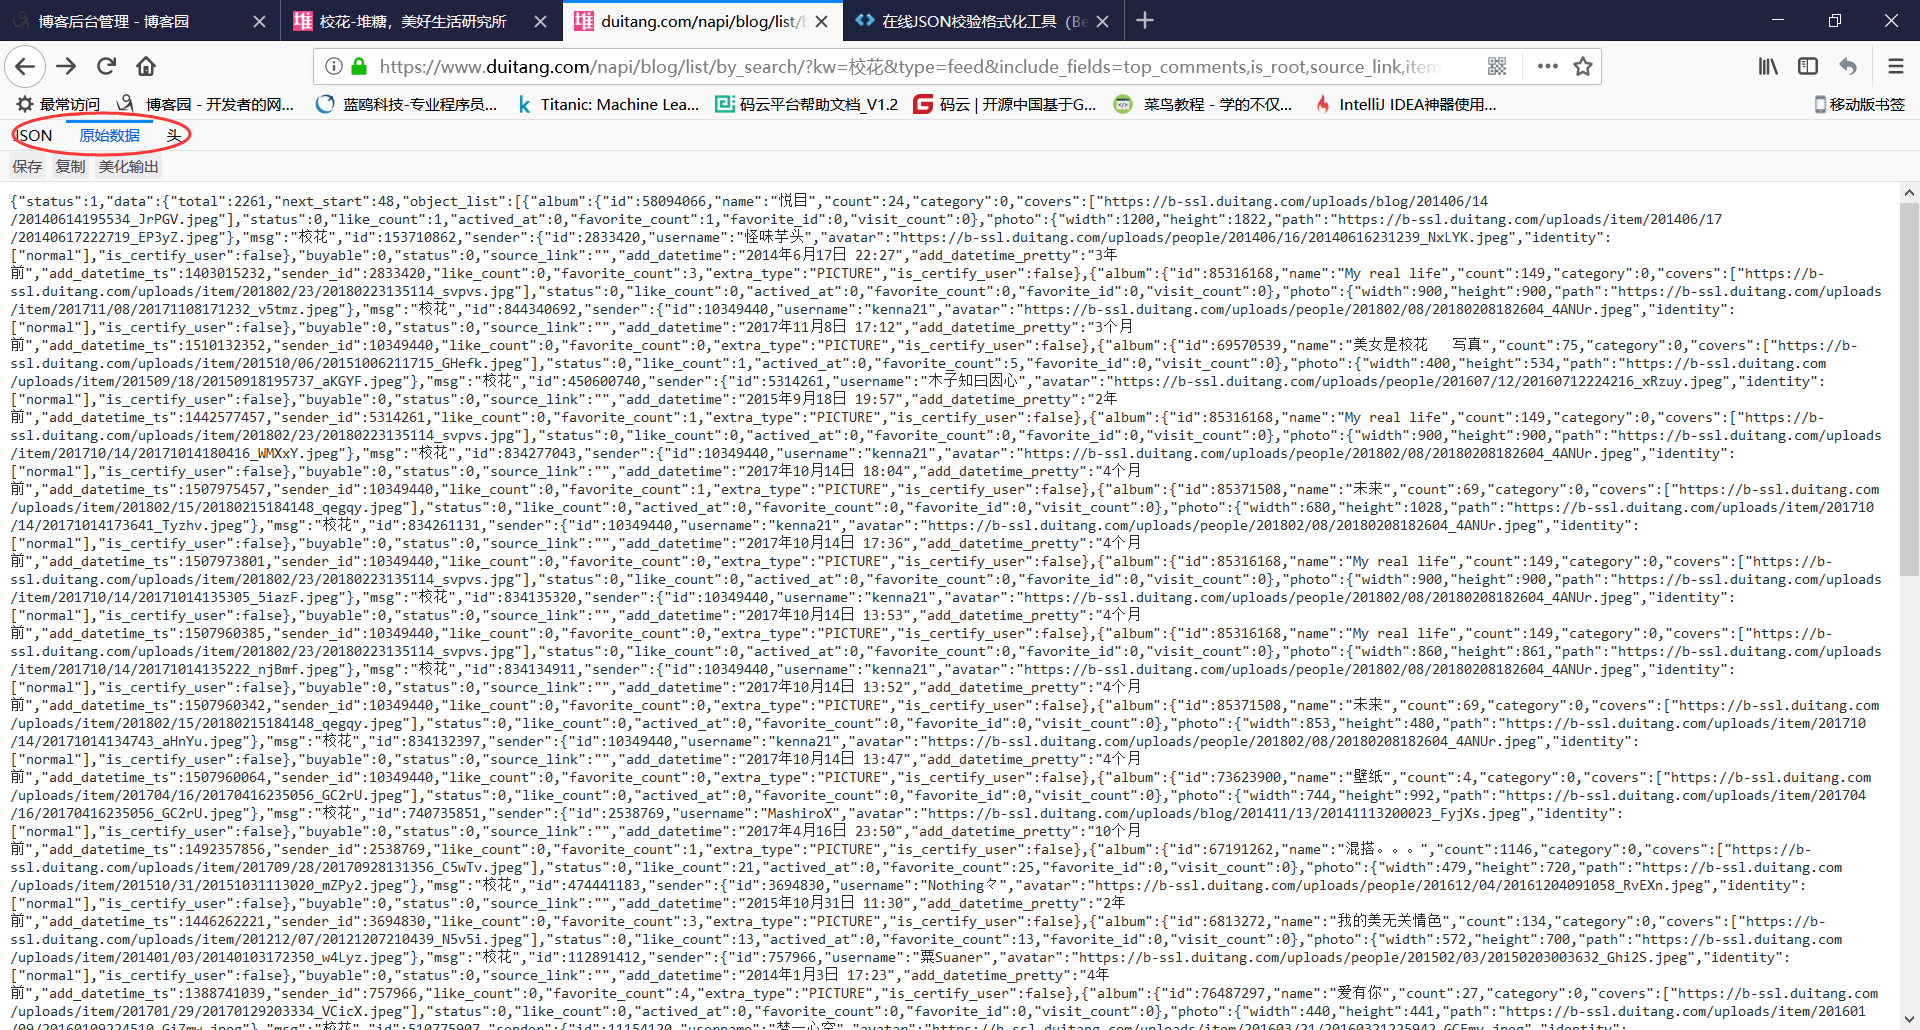
而我这里的火狐浏览器打开直接就是转换好的
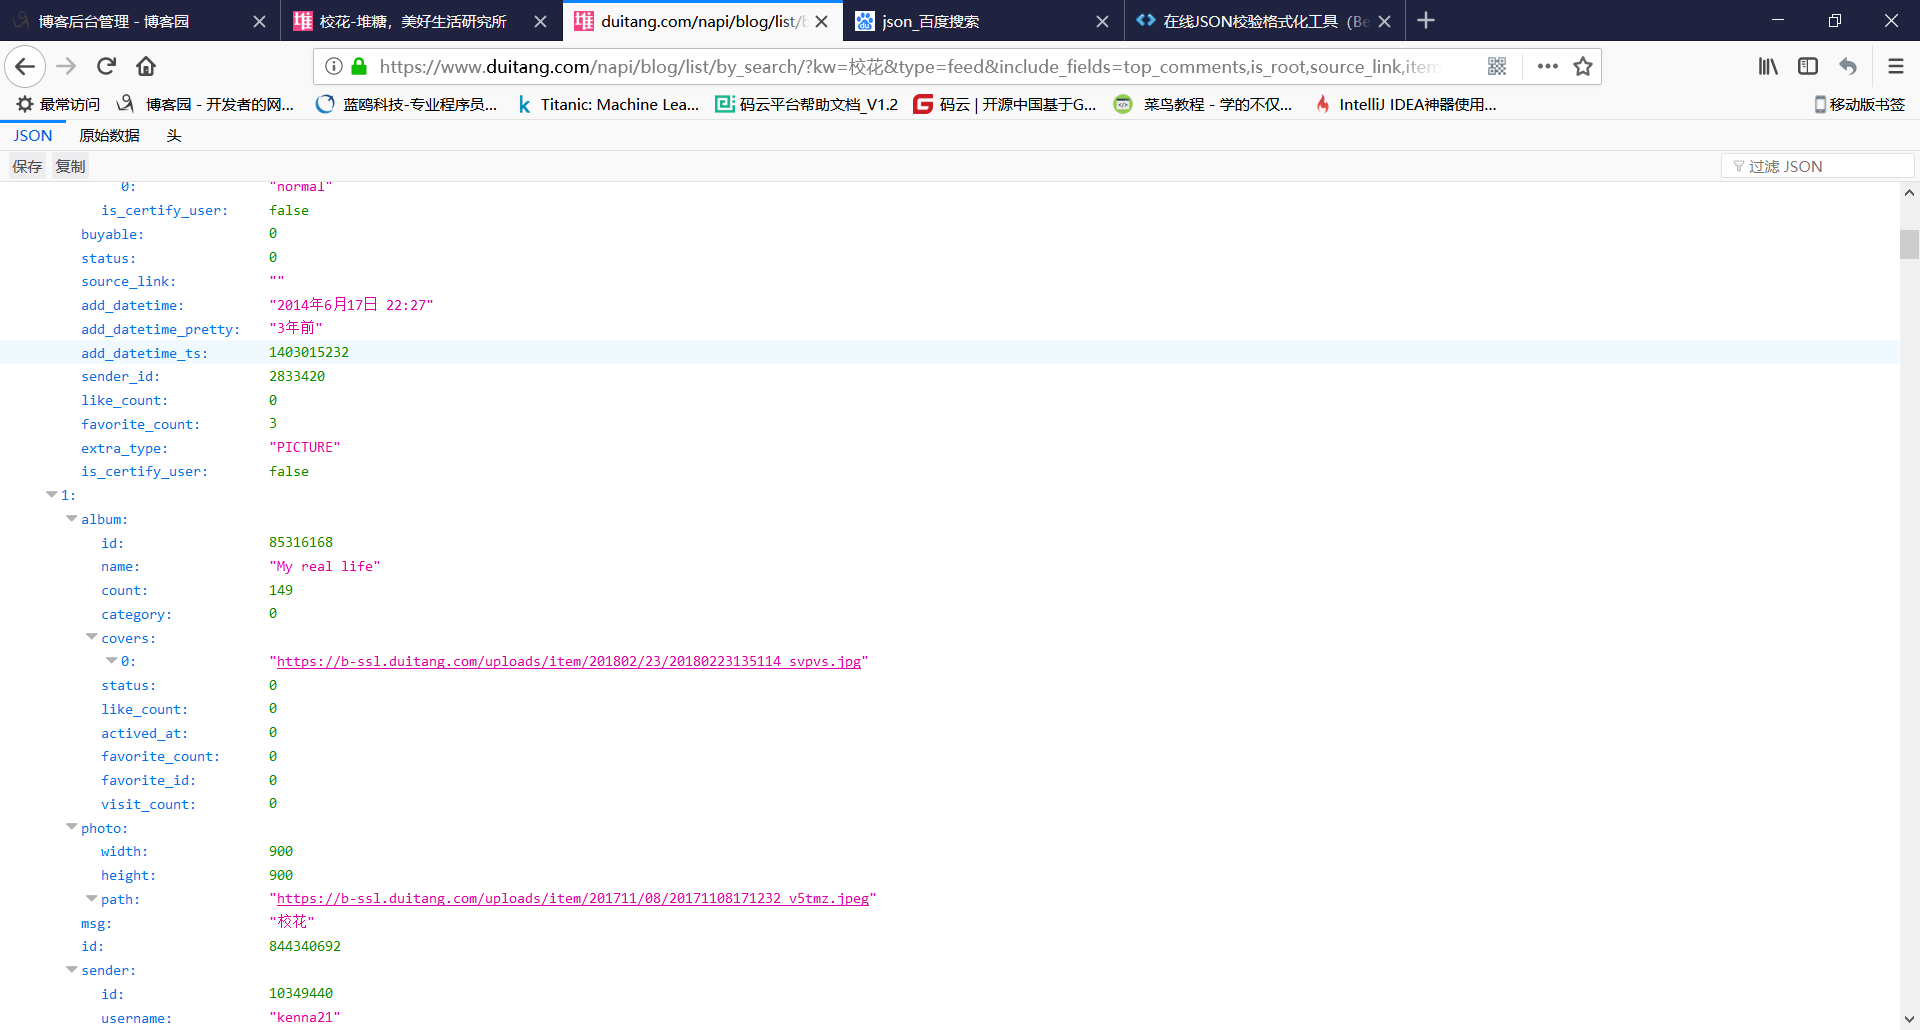
其中的path就是我们需要的

而这个limit就是限制我们爬取数量的参数,后面需要修改这个参数来爬取全部图片
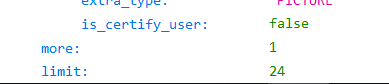
7.对请求地址进行分析
https://www.duitang.com/napi/blog/list/by_search/?kw=校花&type=feed&include_fields=top_comments,is_root,source_link,item,buyable,root_id,status,like_count,sender,album&_type=&start=24&_=1520036797589
将没用的删掉
https://www.duitang.com/napi/blog/list/by_search/?kw=校花&start=24
修改参数start(从0开始爬取),添加参数limit(上限),格式都是&开头
https://www.duitang.com/napi/blog/list/by_search/?kw=校花&start=0&limit=1000
以上就是爬取的分析过程,代码如下
 import requests

 import threading

 import urllib.parse

 #设置最大线程 开启10个线程就锁住

 thread_lock = threading.BoundedSemaphore(value=10)

 'https://www.duitang.com/napi/blog/list/by_search/?kw=%E6%A0%A1%E8%8A%B1&start=0&limt=1000'

 #通过url 获取数据

 #单个页面

 def get_page(url):

     #requests.get 自带了json.loads

     page = requests.get(url)

     #提取需要的content

     page = page.content

     # 将bytes转成 字符串

     page = page.decode('utf-8')

     return page

 #label为关键字

 #取所有页面pages的链接

 def pages_from_duitang(label):

     pages = []

     url = 'https://www.duitang.com/napi/blog/list/by_search/?kw={}&start={}&limt=1000'

     #将中文转成url编码

     label = urllib.parse.quote(label)

     for index in range(0, 3600, 50):

         #将这两个变量替换占位符{}

         u = url.format(label,index)

         page = get_page(u)

         pages.append(page)

     return pages

 # print(get_page('https://www.duitang.com/napi/blog/list/by_search/?kw=%E6%A0%A1%E8%8A%B1&start=0&limt=1000'))

 #page是get_page()返回的页面信息

 #startpart和endpart是边界条件,两个给定的字符串

 # 单个页面的对象,startpart 所要匹配字符1,匹配的字符2

 def findall_in_page(page,startpart,endpart):

     all_strings = []

     end = 0

     # 从end这个字符串开始找,找startpart

     # .find()!=-1说明找到该字符串,返回的是该字符串的起始下标

     while page.find(startpart,end) != -1:

         # 需要的图片的链接的起始位置start

         start = page.find(startpart, end)+len(startpart)

         # 从起始字符串开始找结束字符串

         end = page.find(endpart,start)

         #切片 取两个所要匹配字符 之间的部分也就是图片url

         string = page[start:end]

         #存入列表

         all_strings.append(string)

     return all_strings

 # "path": "https://b-ssl.duitang.com/uploads/item/201708/20/20170820215827_fa483.jpeg"

 def pic_urls_from_pages(pages):

     pic_urls = []

     for page in pages:

         # 处理一个页面

         urls = findall_in_page(page,'path":"','"')

         pic_urls.extend(urls) # 合并列表

     return pic_urls

 def download_pics(url, n):

     r = requests.get(url)

     path = '../pics' + str(n) + '.jpg'

     with open(path,'wb') as f:

         f.write(r.content)

     #下载完了,解锁

     thread_lock.release()

 def main(label):

      pages = pages_from_duitang(label)

      pic_urls = pic_urls_from_pages(pages)

      n = 0

      for url in pic_urls:

         n += 1

         print('正在下载第{}张图片'.format(n))

         #上锁

         thread_lock.acquire()

         #下载 这个方法丢进线程池

         t = threading.Thread(target=download_pics,args=(url,n))

         t.start()

 main('校花')
运行结果
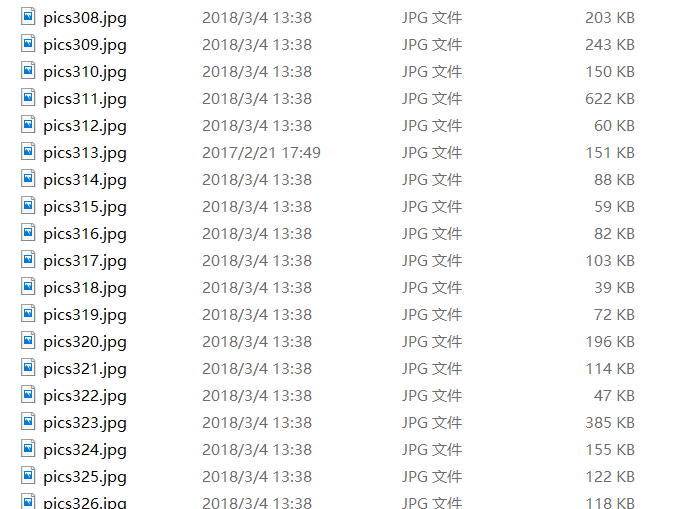
不同的网站防爬不一样,但思路应该都差不多
python3网络爬虫(2.1):爬取堆糖美女的更多相关文章
- Python 网络爬虫 002 (入门) 爬取一个网站之前,要了解的知识
网站站点的背景调研 1. 检查 robots.txt 网站都会定义robots.txt 文件,这个文件就是给 网络爬虫 来了解爬取该网站时存在哪些限制.当然了,这个限制仅仅只是一个建议,你可以遵守,也 ...
- Python网络爬虫与如何爬取段子的项目实例
一.网络爬虫 Python爬虫开发工程师,从网站某一个页面(通常是首页)开始,读取网页的内容,找到在网页中的其它链接地址,然后通过这些链接地址寻找下一个网页,这样一直循环下去,直到把这个网站所有的网页 ...
- 网络爬虫之scrapy爬取某招聘网手机APP发布信息
1 引言 过段时间要开始找新工作了,爬取一些岗位信息来分析一下吧.目前主流的招聘网站包括前程无忧.智联.BOSS直聘.拉勾等等.有段时间时间没爬取手机APP了,这次写一个爬虫爬取前程无忧手机APP岗位 ...
- python3编写网络爬虫13-Ajax数据爬取
一.Ajax数据爬取 1. 简介:Ajax 全称Asynchronous JavaScript and XML 异步的Javascript和XML. 它不是一门编程语言,而是利用JavaScript在 ...
- Python——初识网络爬虫(网页爬取)
网络爬虫(又称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本.另外一些不常使用的名字还有蚂蚁.自动索引.模拟程序或者蠕虫 ...
- 精通python网络爬虫之自动爬取网页的爬虫 代码记录
items的编写 # -*- coding: utf-8 -*- # Define here the models for your scraped items # # See documentati ...
- python网络爬虫之四简单爬取豆瓣图书项目
一.爬虫项目一: 豆瓣图书网站图书的爬取: import requests import re content = requests.get("https://book.douban.com ...
- 【Python网络爬虫三】 爬取网页新闻
学弟又一个自然语言处理的项目,需要在网上爬一些文章,然后进行分词,刚好牛客这周的是从一个html中找到正文,就实践了一下.写了一个爬门户网站新闻的程序 需求: 从门户网站爬取新闻,将新闻标题,作者,时 ...
- Python 网络爬虫实战:爬取 B站《全职高手》20万条评论数据
本周我们的目标是:B站(哔哩哔哩弹幕网 https://www.bilibili.com )视频评论数据. 我们都知道,B站有很多号称“镇站之宝”的视频,拥有着数量极其恐怖的评论和弹幕.所以这次我们的 ...
随机推荐
- LInq之Take Skip TakeWhile SkipWhile Reverse Union Concat 用法
废话不多说,直接上代码,代码有注释!自行运行测试! class Program { static void Main(string[] args) { string[] names = { " ...
- bash处理一条命令的步骤
Shell执行一条命令步骤 参考链接: <Learning the bash Shell, 3rd Edition -- 7.3. Command-Line Processing> &l ...
- jenkins 上命令各种找不到问题
代码: 兵马未动,粮草先行 作者: 传说中的汽水枪 如有错误,请留言指正,欢迎一起探讨. 转载请注明出处. 在使用jenkins的时候,会使用一些命令行,有的时候明明在电脑的命令行(终端)可以执行 ...
- Beta版测试报告
Beta版测试报告 测试中发现的Bug: Version 2.0 Bug List 1. 在动态监测界面,若随便点击“开始”.“关闭”.“结束”.红叉,会出现不定式崩溃现象. 2. 处理空数据时可能会 ...
- linux内核设计第七周——可执行程序的装载
- 小学四则运算APP 第三阶段冲刺-第一天
团队成员:陈淑筠.杨家安.陈曦 团队选题:小学四则运算APP 第三次冲刺阶段时间:12.12~12.19 本次发布的是音乐播放功能,可以根据用户需求一边播放音乐一边做题,也拥有暂停播放音乐的功能,增强 ...
- 在web.xml中配置监听器来控制ioc容器生命周期
5.整合关键-在web.xml中配置监听器来控制ioc容器生命周期 原因: 1.配置的组件太多,需保障单实例 2.项目停止后,ioc容器也需要关掉,降低对内存资源的占用. 项目启动创建容器,项目停止销 ...
- Use curl with uuid(uuidgen) under shell
#!set uuidtmp = uuid.tmp #!uuidgen > $uuidtmp #!set uuid=<$uuidtmp #!rm $uuidtmp #!echo $uuid ...
- PowerShell一例
(Get-WmiObject -query ‘select * from SoftwareLicensingService’).OA3xOriginalProductKey
- [转帖]什么是Asp.net Core?和 .net core有什么区别?
什么是Asp.net Core?和 .net core有什么区别? https://www.cnblogs.com/itzhangxp/p/8322364.html 知道微软开始用 kestrel了 ...