
scrapy的CrawlSpider类
了解CrawlSpider
踏实爬取一般网站的常用spider,其中定义了一些规则(rule)来提供跟进link的方便机制,也许该spider不适合你的目标网站,但是对于大多数情况是可以使用的。因此,可以以此为七点,根据需求修改部分方法,当然也可以实现自己的spider。
官方文档:http://scrapy-chs.readthedocs.io/zh_CN/0.24/topics/spiders.html#crawlspider
CrawlSpider的使用
简单使用
创建爬虫文件:scrapy genspider -t crawl "spider_name" "url"
得到如下目录:
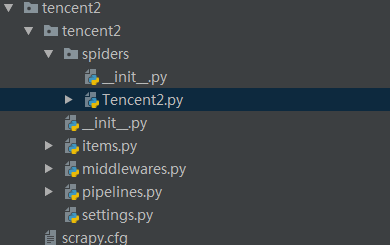
其中spider文件夹中的爬虫文件下的内容如下所示:
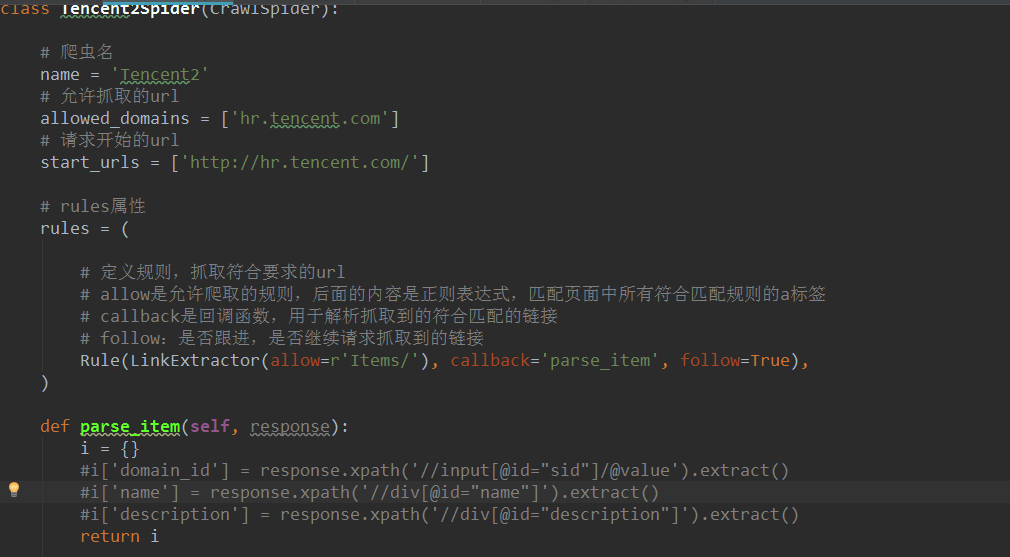
CrawlSpider是Spider的派生类,Spider类的设计原则是只爬取start_url列表中的网页,而CrawlSpider类中定义了一些规则(rule)来提取跟进link的方便机制,从而爬取的网页中获取link并继续爬取。
方法属性
Name:定义spider的名字
allow_domains:包含了spider允许抓起去的域名列表。
start_url:初始化url列表,当没有指定的url时,spider将从该列表中开始进行爬取。
start_requests(self):该方法返回一个可迭代对象,该对象包含了spider用于抓取的第一个request。
parse(self, resposne):默认的Request对象回调函数,用来处理返回的response,以及生成Items或者Request对象。
使用CralwSpider抓取数据
编写CrawlSpider,抓取腾讯招聘的信息,具体网页分析,见:
http://www.cnblogs.com/pythoner6833/p/9018782.html
具体代码如下:
# -*- coding: utf-8 -*-

import scrapy

from scrapy.linkextractors import LinkExtractor

from scrapy.spiders import CrawlSpider, Rule

from tencent2.items import Tencent2Item, DetailsItem

class Tencent2Spider(CrawlSpider):

    # 爬虫名

    name = 'Tencent2'

    # 允许抓取的url

    allowed_domains = ['hr.tencent.com']

    # 请求开始的url

    start_urls = ['https://hr.tencent.com/position.php?']

    # rules属性

    rules = (

        # 定义规则,抓取符合要求的url

        # allow是允许爬取的规则,后面的内容是正则表达式,匹配页面中所有符合匹配规则的a标签

        # callback是回调函数,用于解析抓取到的符合匹配的链接

        # follow:是否跟进,是否继续请求抓取到的链接

        Rule(LinkExtractor(allow=r'start=\d+'), callback='parse_tencent', follow=True),

        #编写匹配详情页的规则,抓取到详情页的链接后不用跟进

        Rule(LinkExtractor(allow=r'position_detail\.php\?id=\d+'), callback='parse_detail', follow=False),

    )

    def parse_tencent(self, response):

        # 获取页面中招聘信息在网页中位置节点

        node_list = response.xpath('//tr[@class="even"] | //tr[@class="odd"]')

        # 遍历节点,进入详情页,获取其他信息

        for node in node_list:

            # 实例化,填写数据

            item = Tencent2Item()

            item['position_name'] = node.xpath('./td[1]/a/text()').extract_first()

            item['position_link'] = node.xpath('./td[1]/a/@href').extract_first()

            item['position_type'] = node.xpath('./td[2]/text()').extract_first()

            item['wanted_number'] = node.xpath('./td[3]/text()').extract_first()

            item['work_location'] = node.xpath('./td[4]/text()').extract_first()

            item['publish_time'] = node.xpath('./td[5]/text()').extract_first()

            yield item

    def parse_detail(self, response):

        """

        解析详情页数据

        :param response:

        :return:

        """

        item = DetailsItem()

        # 从详情页获取工作责任和工作技能两个字段名

        item['work_duties'] = ''.join(response.xpath('//ul[@class="squareli"]')[0].xpath('./li/text()').extract())

        item['work_skills'] = ''.join(response.xpath('//ul[@class="squareli"]')[1].xpath('./li/text()').extract())

        yield item
其他部分,包括items.py和数据保存的pipelines.py里的代码编写和上文中链接里的已解释。
scrapy的CrawlSpider类的更多相关文章
- Scrapy框架——CrawlSpider类爬虫案例
Scrapy--CrawlSpider Scrapy框架中分两类爬虫,Spider类和CrawlSpider类. 此案例采用的是CrawlSpider类实现爬虫. 它是Spider的派生类,Spide ...
- python爬虫入门(八)Scrapy框架之CrawlSpider类
CrawlSpider类 通过下面的命令可以快速创建 CrawlSpider模板 的代码: scrapy genspider -t crawl tencent tencent.com CrawSpid ...
- Scrapy的Spider类和CrawlSpider类
Scrapy shell 用来调试Scrapy 项目代码的 命令行工具,启动的时候预定义了Scrapy的一些对象 设置 shell Scrapy 的shell是基于运行环境中的python 解释器sh ...
- scrapy项目4:爬取当当网中机器学习的数据及价格(CrawlSpider类)
scrapy项目3中已经对网页规律作出解析,这里用crawlspider类对其内容进行爬取: 项目结构与项目3中相同如下图,唯一不同的为book.py文件 crawlspider类的爬虫文件book的 ...
- Scrapy框架-CrawlSpider
目录 1.CrawlSpider介绍 2.CrawlSpider源代码 3. LinkExtractors:提取Response中的链接 4. Rules 5.重写Tencent爬虫 6. Spide ...
- 13.CrawlSpider类爬虫
1.CrawlSpider介绍 Scrapy框架中分两类爬虫,Spider类和CrawlSpider类. 此案例采用的是CrawlSpider类实现爬虫. 它是Spider的派生类,Spider类的设 ...
- 全栈爬取-Scrapy框架(CrawlSpider)
引入 提问:如果想要通过爬虫程序去爬取”糗百“全站数据新闻数据的话,有几种实现方法? 方法一:基于Scrapy框架中的Spider的递归爬取进行实现(Request模块递归回调parse方法). 方法 ...
- Scrapy框架——CrawlSpider爬取某招聘信息网站
CrawlSpider Scrapy框架中分两类爬虫,Spider类和CrawlSpider类. 它是Spider的派生类,Spider类的设计原则是只爬取start_url列表中的网页, 而Craw ...
- python爬虫之Scrapy框架(CrawlSpider)
提问:如果想要通过爬虫程序去爬取”糗百“全站数据新闻数据的话,有几种实现方法? 方法一:基于Scrapy框架中的Spider的递归爬去进行实现的(Request模块回调) 方法二:基于CrawlSpi ...
随机推荐
- vue 2.0 点击添加class,同时删除同级class
<template> <div class="n-header"> <ul class="title-wrapper"> & ...
- Office 2019 Word表格无法跨页重复标题行
Office 2019 Word表格无法跨页重复标题行 今天使用Word设置表格枫叶重复标题行,死活无法实现 右键属性设置还是直接点击重复标题行设置,表格整个跳转到下一页去了 然后百度了解决方案是在[ ...
- 学习笔记26_MVC前台强类型参数
*一般在MVC中,aspx后台要往前台传递参数,使用ViewData["Key"] = obj; 前台就要 <%=(ViewData["key"] as ...
- Java虚拟机之垃圾回收
简述 Java与那些较传统的语言比如C++有个很大不同就是垃圾回收策略了.前者通常是虚拟机自动帮我们做了,而后者就需要我们手动来完成. Java虚拟机帮我们完成了垃圾回收,是不是意味着我们就不用完全去 ...
- T7
#include<iostream> #include<cstring> #include<cstdio> #include<algorithm> us ...
- 大数据之路day01_1--Java下载、安装等配置
从今天开始,我就正式的走上大数据的道路了,如果说我为啥要去学习大数据,可能我的初衷是以后可以接触到人工智能方面的技术,后来在自学的过程中发现,学习人工智能,需要扎实的算法,以及对大量数据的处理,再者, ...
- win10系统任务栏点击没有反应
今天碰到了一个神奇的bug任务栏上的图标怎么也没反应,鼠标点击不了,win+R命令行也出来不了. 经过一番研究,发现CTRL+ALT+DEL,可以打开任务管理器.所以来了一番操作: 1.先打开任务管理 ...
- Python开发【第十三篇】高阶函数、递归函数、闭包
函数式编程是指用一系列函数解决问题 好处:用每个函数完成每个细小的功能,一系列函数任意组合能够解决大问题 函数仅仅接收输入并产生输出,不包含任何能影响输出的内部状态 函数之间的可重入性 当一个函数的输 ...
- mjpg-stream 视频服务 (1)| 简介与配置树莓派使用
源码地址为:https://github.com/jacksonliam/mjpg-streamer Mjpg简介: (1)mjpg-streamer是一个命令行应用程序,它将JPEG帧从一个或多个输 ...
- 使用 vue-element-admin 动态路由渲染
附上:vue-element-admin 官方文档 vue-element-admin https://panjiachen.github.io/vue-element-admin-site/zh/g ...