
机器学习:集成学习(Soft Voting Classifier)
一、Hard Voting 与 Soft Voting 的对比
1)使用方式
- voting = 'hard':表示最终决策方式为 Hard Voting Classifier;
- voting = 'soft':表示最终决策方式为 Soft Voting Classifier;
2)思想
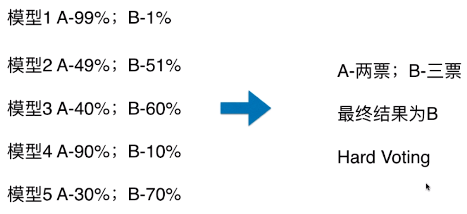
- Hard Voting Classifier:根据少数服从多数来定最终结果;
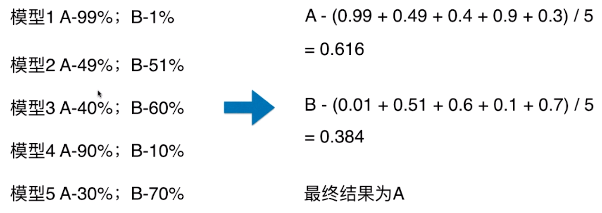
- Soft Voting Classifier:将所有模型预测样本为某一类别的概率的平均值作为标准,概率最高的对应的类型为最终的预测结果;
Hard Voting
- 模型 1:A - 99%、B - 1%,表示模型 1 认为该样本是 A 类型的概率为 99%,为 B 类型的概率为 1%;
Soft Voting
- 将所有模型预测样本为某一类别的概率的平均值作为标准;
- Hard Voting 投票方式的弊端:
- 如上图,最终的分类结果不是由概率值更大的模型 1 和模型 4 决定,而是由概率值相对较低的模型 2/3/5 来决定的;
二、各分类算法的概率计算
- Soft Voting 的决策方式,要求集合的每一个模型都能估计概率;
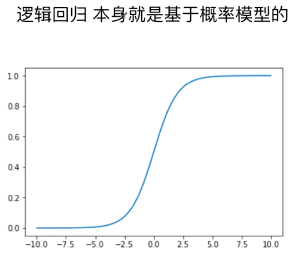
1)逻辑回归算法
- P = σ( y_predict )
2)kNN 算法
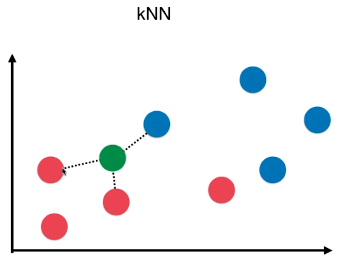
- k 个样本点中,数量最多的样本所对应的类别作为最终的预测结果;
- kNN 算法也可以考虑权值,根据选中的 k 个点距离待预测点的距离不同,k 个点的权值也不同;
- P = n / k
- n:k 个样本中,最终确定的类型的个数;如下图,最终判断为 红色类型,概率:p = n/k = 2 / 3;
3)决策树算法
- 通常在“叶子”节点处的信息熵或者基尼系数不为 0,数据集中包含多种类别的数据,以数量最多的样本对应的类别作为最终的预测结果;(和 kNN 算法类似)
- P = n / N
- n:“叶子”中数量最多的样本的类型对应的样本数量;
- N:“叶子”中样本总量;
4)SVM 算法
- 在 scikit-learn 中的 SVC() 中的一个参数:probability
- probability = True:SVC() 返回样本为各个类别的概率;(默认为 False)
from sklearn.svm import SVC

svc = SVC(probability=True) - 计算样本为各个类别的概率需要花费较多时间;
三、scikit-learn 中使用集成分类器:VotingClassifier
1)模拟数据集
import numpy as np

import matplotlib.pyplot as plt

from sklearn import datasets

from sklearn.model_selection import train_test_split

X, y = datasets.make_moons(n_samples=500, noise=0.3, random_state=42)

X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42)
2)voting = 'hard':使用 Hard Voting 做决策
from sklearn.linear_model import LogisticRegression

from sklearn.svm import SVC

from sklearn.tree import DecisionTreeClassifier

from sklearn.ensemble import VotingClassifier

# 实例化

voting_clf = VotingClassifier(estimators=[

    ('log_clf', LogisticRegression()),

    ('svm_clf', SVC()),

    ('dt_clf', DecisionTreeClassifier(random_state=666))

], voting='hard')

voting_clf.fit(X_train, y_train)

voting_clf.score(X_test, y_test)

# 准确率:0.896
3)voting = 'soft':使用 Soft Voting 做决策
voting_clf = VotingClassifier(estimators=[

    ('log_clf', LogisticRegression()),

    ('svm_clf', SVC(probability=True)),

    ('dt_clf', DecisionTreeClassifier(random_state=666))

], voting='soft')

voting_clf.fit(X_train, y_train)

voting_clf.score(X_test, y_test)

# 准确率:0.912- 使用 Soft Voting 时,SVC() 算法的参数:probability=True
机器学习:集成学习(Soft Voting Classifier)的更多相关文章
- 【笔记】集成学习入门之soft voting classifier和hard voting classifier
集成学习入门之soft voting classifier和hard voting classifier 集成学习 通过构建并结合多个学习器来完成学习任务,一般是先产生一组"个体学习器&qu ...
- [机器学习]集成学习--bagging、boosting、stacking
集成学习简介 集成学习(ensemble learning)通过构建并结合多个学习器来完成学习任务. 如何产生"好而不同"的个体学习器,是集成学习研究的核心. 集成学习的思路是通过 ...
- 集成学习-Majority Voting
认识 集成学习(Ensemble Methods), 首先是一种思想, 而非某种模型, 是一种 "群体决策" 的思想, 即对某一特定问题, 用多个模型来进行训练. 像常见的单个模型 ...
- 机器学习--集成学习(Ensemble Learning)
一.集成学习法 在机器学习的有监督学习算法中,我们的目标是学习出一个稳定的且在各个方面表现都较好的模型,但实际情况往往不这么理想,有时我们只能得到多个有偏好的模型(弱监督模型,在某些方面表现的比较好) ...
- 机器学习:集成学习:随机森林.GBDT
集成学习(Ensemble Learning) 集成学习的思想是将若干个学习器(分类器&回归器)组合之后产生一个新学习器.弱分类器(weak learner)指那些分类准确率只稍微好于随机猜测 ...
- 机器学习——集成学习(Bagging、Boosting、Stacking)
1 前言 集成学习的思想是将若干个学习器(分类器&回归器)组合之后产生一个新学习器.弱分类器(weak learner)指那些分类准确率只稍微好于随机猜测的分类器(errorrate < ...
- python大战机器学习——集成学习
集成学习是通过构建并结合多个学习器来完成学习任务.其工作流程为: 1)先产生一组“个体学习器”.在分类问题中,个体学习器也称为基类分类器 2)再使用某种策略将它们结合起来. 通常使用一种或者多种已有的 ...
- 吴裕雄 python 机器学习——集成学习随机森林RandomForestRegressor回归模型
import numpy as np import matplotlib.pyplot as plt from sklearn import datasets,ensemble from sklear ...
- 吴裕雄 python 机器学习——集成学习随机森林RandomForestClassifier分类模型
import numpy as np import matplotlib.pyplot as plt from sklearn import datasets,ensemble from sklear ...
随机推荐
- 【转】linux驱动开发
转自:http://www.cnblogs.com/heat-man/articles/4174899.html 首先理一理驱动/内核/应用程序的一些概念,以前总没有具体的去关注过! 我们的pc直观来 ...
- CCNA 课程 三
交换机的MAC地址学习情况: 1.从一个接口收到数据帧,根据数据帧的原mac地址查找交换机的mac地址表,如果没有找到,将会添加数据帧的原mac地址和收到数据帧接口的对应条目,放进交换机的mac地址表 ...
- centos下无法使用lsof命令"-bash: lsof: command not found"
1.问题描述 : 在CentOS下,使用lsof命令,报错如下: 2.解决方法: #yum install lsof 若输入y不能安装成功,通过yum install 包 -y 进行安装: # yum ...
- HDFS-查看文件属性+文件名称过滤
package com.zhen.hdfs; import java.io.IOException; import java.io.OutputStream; import java.net.URI; ...
- JSON解析字符串
JSON解析字符串 JSON 解析字符串时,应按严格的标准,否则无法解析: str1 = '{"str":"string","number" ...
- pandas读取Excel
time31 = pd.read_excel('F:/save_file/3问出车表.xlsx', sheetname='Sheet1') # 读取‘3问出车表.xlsx’中的Sheet1表单, ti ...
- ActiveMQ消费者接收消息的过程
[http://manzhizhen.iteye.com/blog/2094130] org.apache.activemq.ActiveMQMessageConsumer同步接收
- UGUI加载图片优化方法之一:打包成图集
打包后的: 直接改变sprite中的packing tag,相同的packing tag就是同一张图集中的.改完运行会自动帮你打包
- 冒泡排序的PHP实现 Bubble Sort
冒泡排序Bubble Sort的PHP实现.代码中函数说明: out_arr,用于将数组输出成一个字符串,以便查看 bubblesort,第一种实现方案,从后往前依次选出需要的值,这里是较大的 bub ...
- file.seek()方法引出的文本文件和二进制文件问题
问题的起因 菜鸟教程上有一段关于file.seek()方法的讲解,先简短描述一下seek()方法: seek(offset, whence)方法用于移动文件读取指针到指定位置 参数offset--开始 ...