
假期学习【十一】Python爬取百度词条写入csv格式 python 2020.2.10
今天主要完成了根据爬取的txt文档,从百度分类从信息科学类爬取百度词条信息,并写入CSV格式文件。
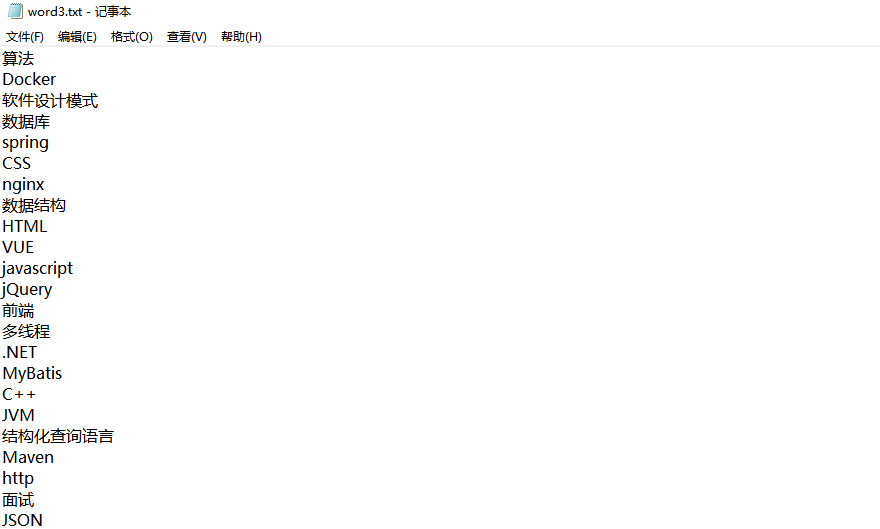
txt格式文件如图: 为自己爬取内容分词后的结果。
代码如下:
 import requests

 from bs4 import BeautifulSoup

 import csv

 import io

 import re

 url="https://baike.baidu.com/item/"

 id=1

 patton=re.compile(r'.*信息科学分类.*|.*软件.*|.*科技产品.*|.*公司.*|.*互联网人物.*|.*互联网.*|.*科技术语.*|.*技术.*|.*网站.*')

 #写入表头

 def Head():

     with open('E:/bdbk2.csv', 'w', encoding='utf-8', newline='') as csvfile:

         writer = csv.writer(csvfile)

         writer.writerow(["序号", "名称", "属性", "内容", "网址"])

 def read():

     f = open('E:/bdbk2.csv', 'a+', encoding='utf-8', newline='')

     csv_writer = csv.writer(f)

     global url

     f=open("E:/word5.txt",'r+',encoding="utf-8")

     for line in f:

         url=url+line.rstrip("\n")

         try:

             global id, name, nature, content, tag

             kv = {'user-agent': 'Mozilla/5.0'}

             r = requests.get(url, headers=kv)

             r.encoding = "utf-8"

             demo = r.text

             soup = BeautifulSoup(demo, "html.parser")

             print(url)

             # print(soup.prettify())

             tag = soup.find_all("dd", {"id": "open-tag-item"})[0].get_text().replace("(", "").replace(")",

                                                                                                       "").strip().replace(

                 "\n", "")

             name = soup.find_all("h1")[0].get_text().strip()

             nature = soup.find_all("h2")[0].get_text().replace("(", "").replace(")", "").strip()

             if nature == '目录':

                 nature = tag

             content = soup.find_all("div", {"class": "lemma-summary"})[0].get_text().strip().rstrip("]").lstrip("[")

             if name != "百度百科错误页" and nature != "目录" and len(patton.findall(tag)) != 0:

                 print("序号:" + str(id))

                 print("名称:" + name)

                 print("属性:" + nature)

                 print("内容:" + content)

                 print("网址:" + url)

                 csv_writer.writerow([str(id), name, nature, content, url])

                 id += 1

         except:

             print("出错!")

         url = "https://baike.baidu.com/item/"

     f.close()

 if __name__=="__main__":

     Head()

     read()
假期学习【十一】Python爬取百度词条写入csv格式 python 2020.2.10的更多相关文章
- 爬虫实战(一) 用Python爬取百度百科
最近博主遇到这样一个需求:当用户输入一个词语时,返回这个词语的解释 我的第一个想法是做一个数据库,把常用的词语和词语的解释放到数据库里面,当用户查询时直接读取数据库结果 但是自己又没有心思做这样一个数 ...
- Python——爬取百度百科关键词1000个相关网页
Python简单爬虫——爬取百度百科关键词1000个相关网页——标题和简介 网站爬虫由浅入深:慢慢来 分析: 链接的URL分析: 数据格式: 爬虫基本架构模型: 本爬虫架构: 源代码: # codin ...
- python 爬取百度url
#!/usr/bin/env python # -*- coding: utf-8 -*- # @Date : 2017-08-29 18:38:23 # @Author : EnderZhou (z ...
- java 如何爬取百度百科词条内容(java如何使用webmagic爬取百度词条)
这是老师所布置的作业 说一下我这里的爬去并非能把百度词条上的内容一字不漏的取下来(而是它分享链接的一个主要内容概括...)(他的主要内容我爬不到 也不想去研究大家有好办法可以call me) 例如 互 ...
- python爬取百度贴吧帖子
最近偶尔学下爬虫,放上第二个demo吧 #-*- coding: utf-8 -*- import urllib import urllib2 import re #处理页面标签类 class Too ...
- python爬取百度搜索结果ur汇总
写了两篇之后,我觉得关于爬虫,重点还是分析过程 分析些什么呢: 1)首先明确自己要爬取的目标 比如这次我们需要爬取的是使用百度搜索之后所有出来的url结果 2)分析手动进行的获取目标的过程,以便以程序 ...
- 使用python爬取百度贴吧内的图片
1. 首先通过urllib获取网页的源码 # 定义一个getHtml()函数 def getHtml(url): try: page = urllib.urlopen(url) # urllib.ur ...
- python 爬取百度云资源
pan1 1 import urllib.request 2 import re 3 import random 4 5 def get_source(key): 6 7 print('请稍等,爬取中 ...
- python爬取百度翻译返回:{'error': 997, 'from': 'zh', 'to': 'en', 'query 问题
解决办法: 修改url为手机版的地址:http://fanyi.baidu.com/basetrans User-Agent也用手机版的 测试代码: # -*- coding: utf-8 -*- & ...
随机推荐
- EF CORE中复杂类型的映射
实体映射时,遇到复杂类型,可选择下述方法处理: NotMapped,跳过映射 在复杂类型上声明 [Owned],但仅限该复杂类型是全部由简单值类型组成的 自定义序列化方法 示例: IPInfo使用 ...
- docker配置仓库源
1 修改docker配置文件 下面的内网ip改成公司的私有仓库地址 后面两个建议保留(一个是国内加速源,一个是国外仓库.这两个删了也是可以的) 2 重启docker服务 # vim /etc/dock ...
- spark 报错 InvalidClassException: no valid constructor
2019-03-19 02:50:24 WARN TaskSetManager:66 - Lost task 1.0 in stage 0.0 (TID 1, 1.2.3.4, executor 1) ...
- Jenkins集成jacoco收集集成测试覆盖率
Jenkins集成jacoco收集集成测试覆盖率 2020-02-28 目录 0 整体思路1 安装版本2 全局工具配置3 Jenkins创建JacocoIntegrateTestDemo项目 3.1 ...
- 安装ubuntu到移动硬盘(UEFI+GPT),实现在别的电脑也可以使用(详细教程)
前置说明:博主小白,第一次安装ubuntu,参考了网上很多人的教程,发博记录一下自己的安装过程.由于有些地方博主理解较浅或者因为机器硬件等各方面原因,本教程适用有限,仅供参考. 1.准备工作 win系 ...
- opencv —— createTrackbar、getTrackbarPos 滑动条的创建和使用
创建滑动条:createTrackbar 函数 createTrackbar 函数用于创建一个可以调整数值的滑动条,并将滑动条附加在指定的窗口上. int createTrackbar(const s ...
- Wannafly Winter Camp 2020 Day 6A Convolution - NTT
求 \(\sum_{i=1}^n \sum_{j=1}^n 2^{a_ia_j}\) Solution 化简一下 \[ 2^{a_ia_j} = p^{(a_i+a_j)^2-a_i^2-a_j^2} ...
- 极其实用的JS单行代码
个人博客 地址:https://www.wenhaofan.com/a/20190629211647 1.强制布尔值 要将变量强制转换为布尔值而不更改其值: const myBoolean = !! ...
- Lodash是什么?
lodash:是一个一致性.模块化.高性能的 JavaScript 实用工具库.(也就是相当于自己封装的私有方法) node里引入 // Load the full build. var _ = re ...
- PHP0009:PHP基础-mysql
以管理员省份启动记事本 修改host文件 插入外部sql数据