
爬虫(八):分析Ajax请求抓取今日头条街拍美图
(1):分析网页
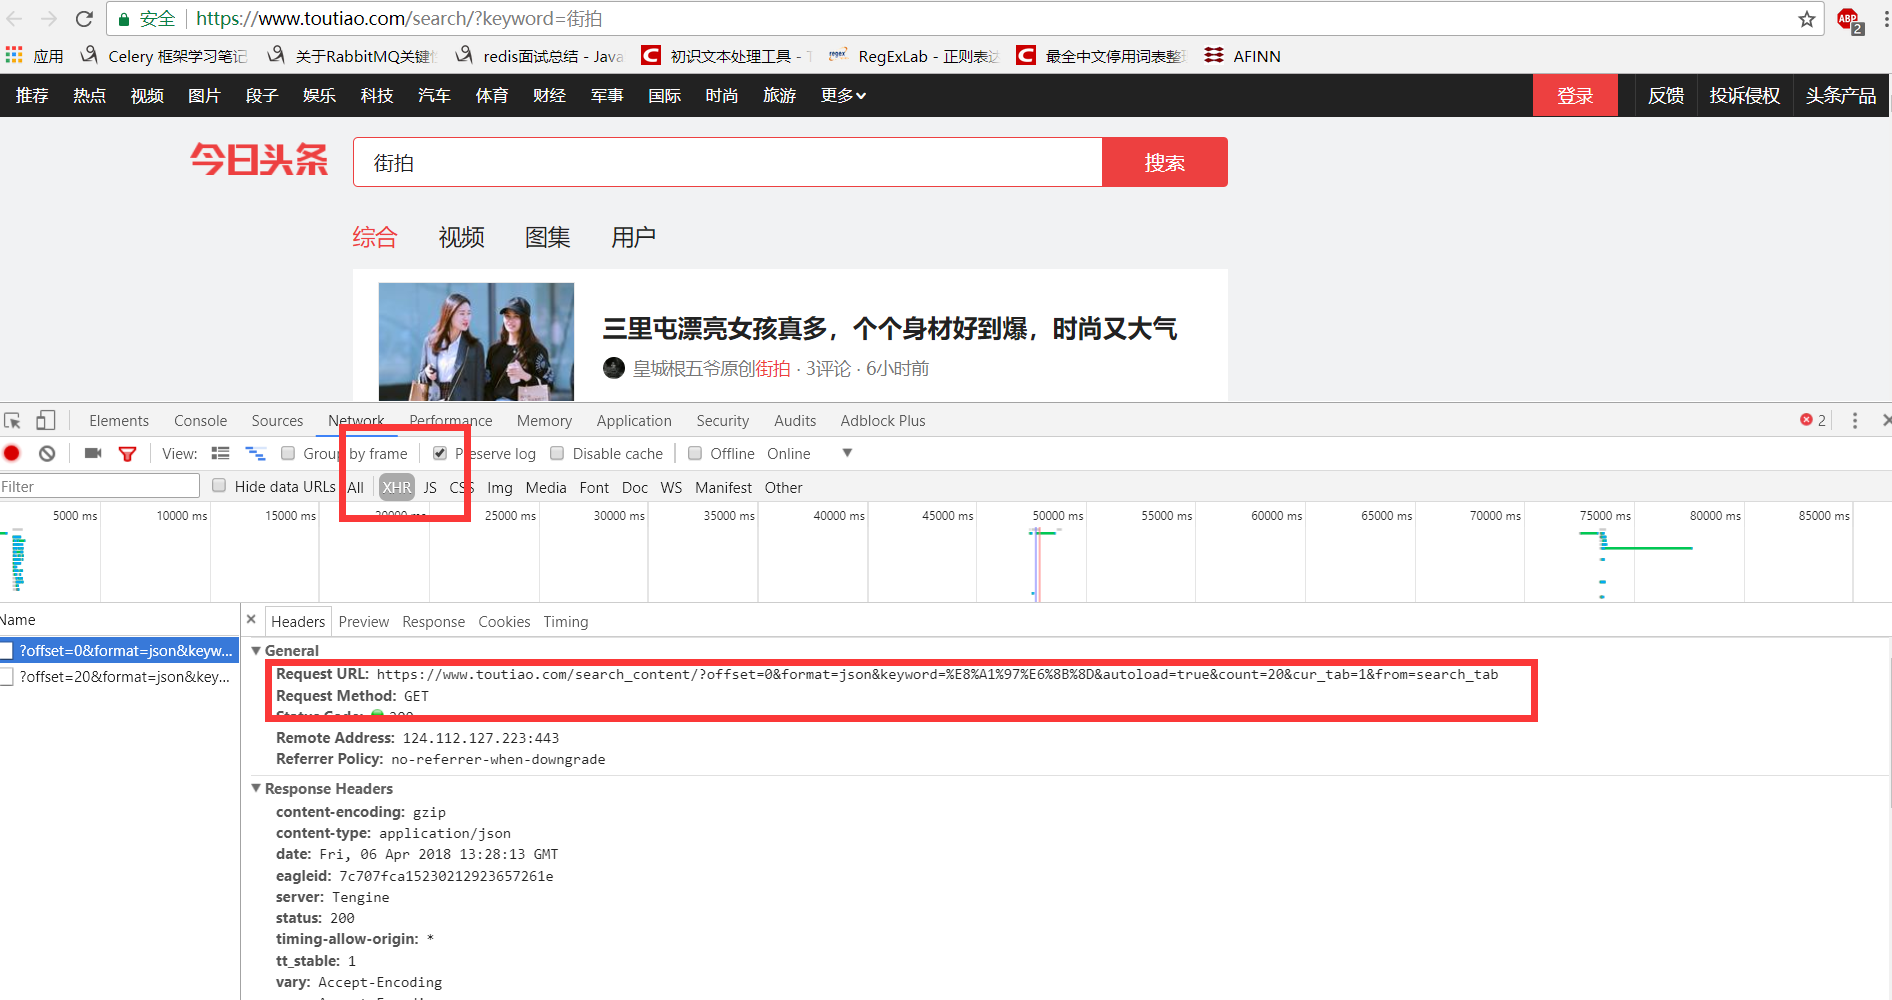
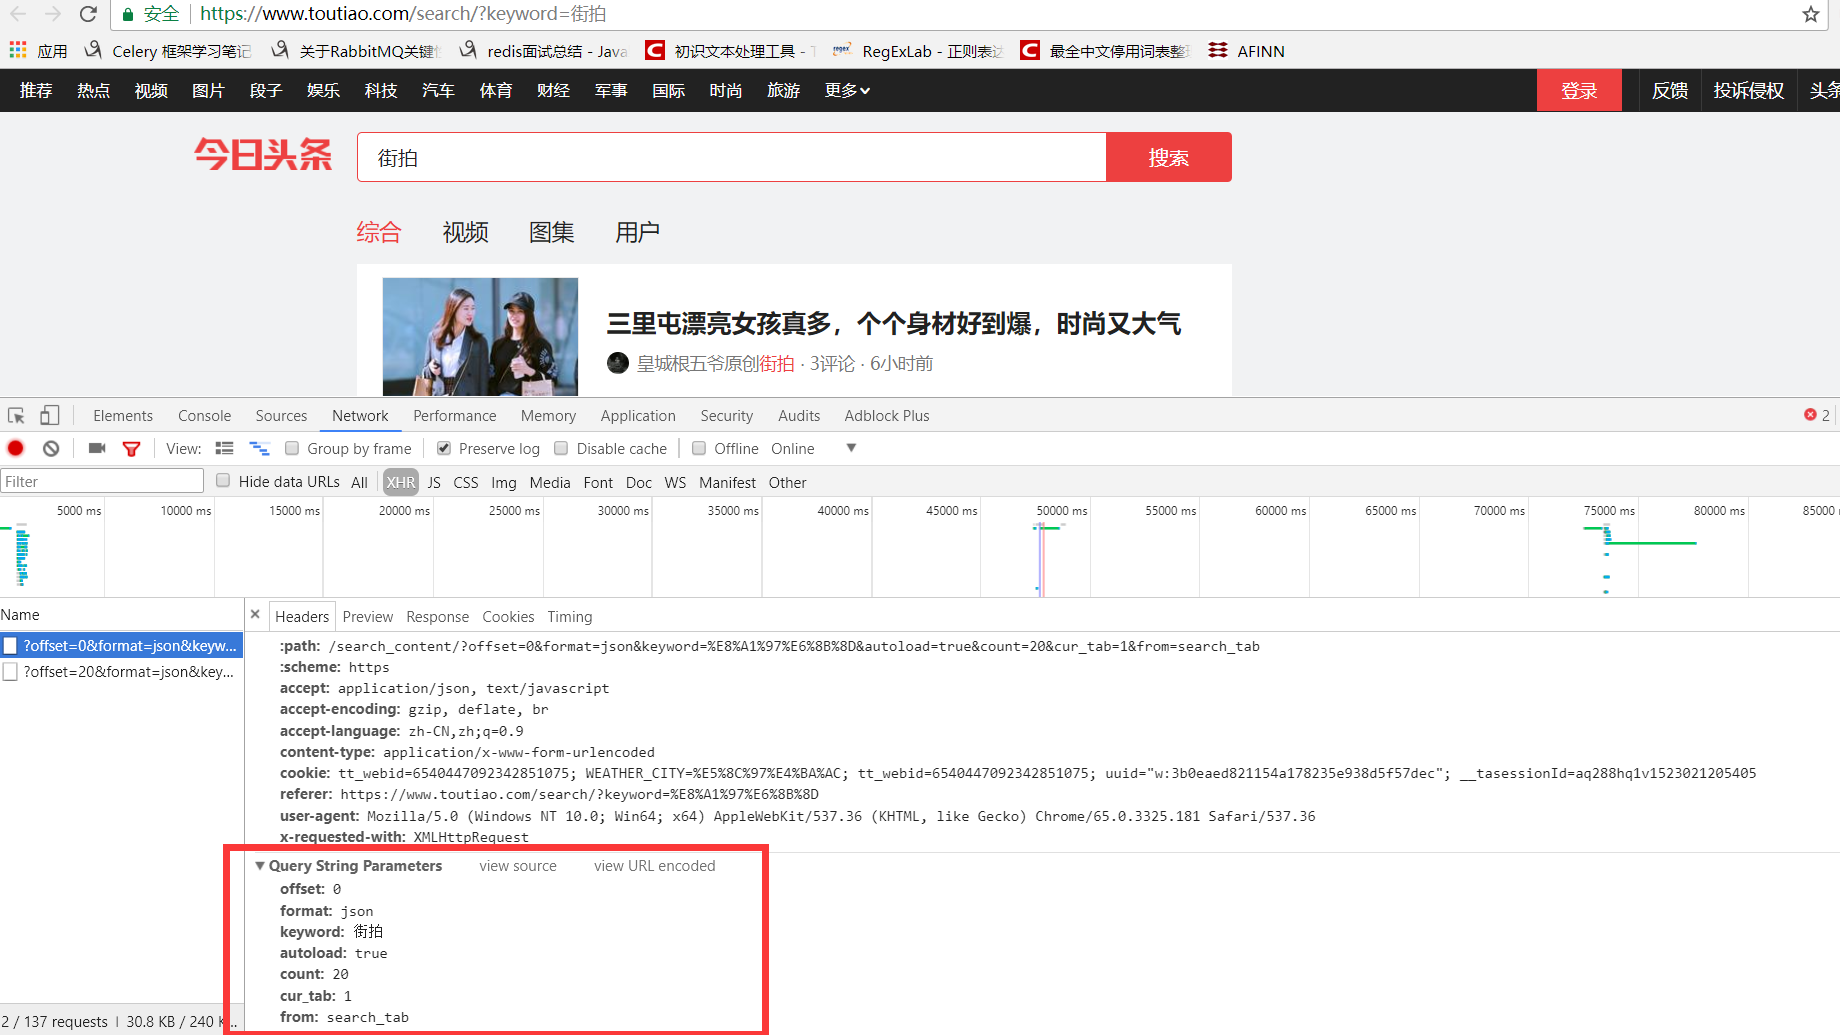
分析ajax的请求网址,和需要的参数。通过不断向下拉动滚动条,发现请求的参数中offset一直在变化,所以每次请求通过offset来控制新的ajax请求。
(2)上代码
a、通过ajax请求获取页面数据
# 获取页面数据

def get_page_index(offset, keyword):

    # 参数通过分析页面的ajax请求获得

    data = {

        'offset': offset,

        'format': 'json',

        'keyword': keyword,

        'autoload': 'true',

        'count': '',

        'cur_tab': '',

        'from': 'search_tab',

    }

    url = 'https://www.toutiao.com/search_content/?' + urlencode(data)  # 将字典转换为url参数形式

    try:

        response = requests.get(url, headers=headers)

        if response.status_code == 200:

            return response.text

        else:

            return None

    except RequestException:

        print('请求索引页错误')

        return None
b、分析ajax请求的返回结果,获取图片集的url
# 分析ajax请求的返回结果,获取图片集的url

def parse_page_index(html):

    data = json.loads(html) # 加载返回的json数据

    if data and 'data' in data.keys():

        for item in data.get('data'):

            yield item.get('article_url')
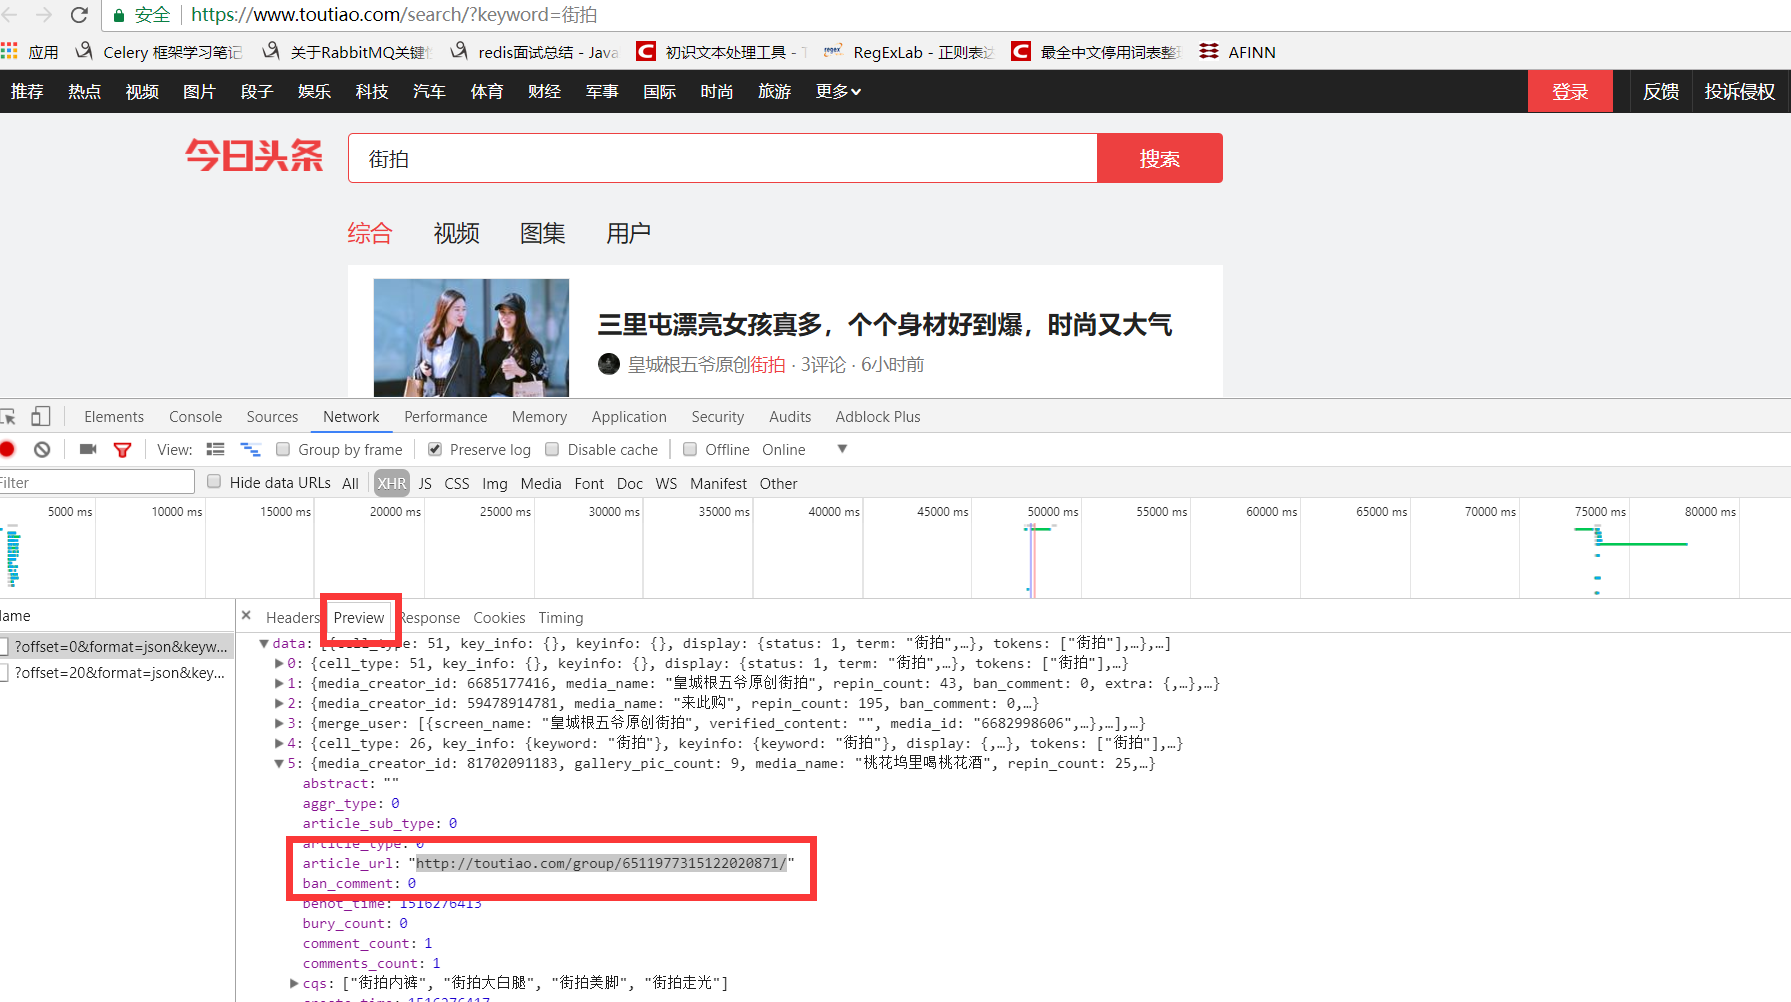
c、得到图集url后获取图集的内容
# 获取详情页的内容

def get_page_detail(url):

    try:

        response = requests.get(url, headers=headers)

        if response.status_code == 200:

            return response.text

        else:

            return None

    except RequestException:

        print('详情页页错误', url)

        return None
d、其他看完整代码
完整代码:
# -*- coding: utf-8 -*-

# @Author  : FELIX

# @Date    : 2018/4/4 12:49

import json

import os

from hashlib import md5

import requests

from urllib.parse import urlencode

from requests.exceptions import RequestException

from bs4 import BeautifulSoup

import re

import pymongo

from multiprocessing import Pool

MONGO_URL='localhost'

MONGO_DB='toutiao'

MONGO_TABLE='toutiao'

GROUP_START=1

GROUP_END=20

KEYWORD='街拍'

client = pymongo.MongoClient(MONGO_URL)  # 连接MongoDB

db = client[MONGO_DB]  # 如果已经存在连接,否则创建数据库

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/65.0.3325.181 Safari/537.36',

}

# 获取页面数据

def get_page_index(offset, keyword):

    # 参数通过分析页面的ajax请求获得

    data = {

        'offset': offset,

        'format': 'json',

        'keyword': keyword,

        'autoload': 'true',

        'count': '',

        'cur_tab': '',

        'from': 'search_tab',

    }

    url = 'https://www.toutiao.com/search_content/?' + urlencode(data)  # 将字典转换为url参数形式

    try:

        response = requests.get(url, headers=headers)

        if response.status_code == 200:

            return response.text

        else:

            return None

    except RequestException:

        print('请求索引页错误')

        return None

# 分析ajax请求的返回结果,获取图片集的url

def parse_page_index(html):

    data = json.loads(html) # 加载返回的json数据

    if data and 'data' in data.keys():

        for item in data.get('data'):

            yield item.get('article_url')

# 获取详情页的内容

def get_page_detail(url):

    try:

        response = requests.get(url, headers=headers)

        if response.status_code == 200:

            return response.text

        else:

            return None

    except RequestException:

        print('详情页页错误', url)

        return None

def parse_page_detail(html, url):

    # soup=BeautifulSoup(html,'lxml')

    # print(soup)

    # title=soup.select('tetle').get_text()

    # print(title)

    images_pattern = re.compile('articleInfo:.*?title: \'(.*?)\'.*?content.*?\'(.*?)\'', re.S)

    result = re.search(images_pattern, html)

    if result:

        title = result.group(1)

        url_pattern = re.compile('"(http:.*?)"')

        img_url = re.findall(url_pattern, str(result.group(2)))

        if img_url:

            for img in img_url:

                download_img(img)  # 下载

            data = {

                'title': title,

                'url': url,

                'images': img_url,

            }

            return data

def save_to_mongo(result):

    if result:

        if db[MONGO_TABLE].insert(result):  # 插入数据

            print('存储成功', result)

            return True

    return False

def download_img(url):

    print('正在下载', url)

    try:

        response = requests.get(url, headers=headers)

        if response.status_code == 200:

            save_img(response.content)

        else:

            return None

    except RequestException:

        print('下载图片错误', url)

        return None

def save_img(content):

    # os.getcwd()获取当前文件路径,用md5命名,保证不重复

    file_path = '{}/imgs/{}.{}'.format(os.getcwd(), md5(content).hexdigest(), 'jpg')

    if not os.path.exists(file_path):

        with open(file_path, 'wb')as f:

            f.write(content)

def main(offset):

    html = get_page_index(offset, KEYWORD)

    for url in parse_page_index(html):

        html = get_page_detail(url)

        print(url,'++++++++++++++++++++++++++++++++++++++++++++++++')

        print(html)

        if html:

            result = parse_page_detail(html, url)

            save_to_mongo(result)

            # print(result)

        # print(url)

if __name__ == '__main__':

    groups = [i * 20 for i in range(GROUP_START, GROUP_END + 1)]

    pool = Pool()

    pool.map(main, groups)
爬虫(八):分析Ajax请求抓取今日头条街拍美图的更多相关文章
- python3爬虫-分析Ajax,抓取今日头条街拍美图
# coding=utf-8 from urllib.parse import urlencode import requests from requests.exceptions import Re ...
- 通过分析Ajax请求 抓取今日头条街拍图集
代码: import os import re import json import time from hashlib import md5 from multiprocessing import ...
- 分析Ajax来爬取今日头条街拍美图并保存到MongDB
前提:.需要安装MongDB 注:因今日投票网页发生变更,如下代码不保证能正常使用 #!/usr/bin/env python #-*- coding: utf-8 -*- import json i ...
- python爬虫之分析Ajax请求抓取抓取今日头条街拍美图(七)
python爬虫之分析Ajax请求抓取抓取今日头条街拍美图 一.分析网站 1.进入浏览器,搜索今日头条,在搜索栏搜索街拍,然后选择图集这一栏. 2.按F12打开开发者工具,刷新网页,这时网页回弹到综合 ...
- 15-分析Ajax请求并抓取今日头条街拍美图
流程框架: 抓取索引页内容:利用requests请求目标站点,得到索引网页HTML代码,返回结果. 抓取详情页内容:解析返回结果,得到详情页的链接,并进一步抓取详情页的信息. 下载图片与保存数据库:将 ...
- Python Spider 抓取今日头条街拍美图
""" 抓取今日头条街拍美图 """ import os import time import requests from hashlib ...
- 分析Ajax请求并抓取今日头条街拍美图
项目说明 本项目以今日头条为例,通过分析Ajax请求来抓取网页数据. 有些网页请求得到的HTML代码里面并没有我们在浏览器中看到的内容.这是因为这些信息是通过Ajax加载并且通过JavaScript渲 ...
- 2.分析Ajax请求并抓取今日头条街拍美图
import requests from urllib.parse import urlencode # 引入异常类 from requests.exceptions import RequestEx ...
- 分析 ajax 请求并抓取今日头条街拍美图
首先分析街拍图集的网页请求头部: 在 preview 选项卡我们可以找到 json 文件,分析 data 选项,找到我们要找到的图集地址 article_url: 选中其中一张图片,分析 json 请 ...
随机推荐
- ASP.net Web API综合示例
目录 概述 功能介绍 程序结构 服务器端介绍 客户端介绍 “契约” Web API设计规则 并行写入冲突与时间戳 身份验证详解 Web API验证规则 客户端MVVM简介 Web.Config 本DE ...
- 使用Spring Cloud OAuth2和JWT保护微服务
采用Spring Security AOuth2 和 JWT 的方式,避免每次请求都需要远程调度 Uaa 服务.采用Spring Security OAuth2 和 JWT 的方式,Uaa 服务只验证 ...
- logback的使用和配置
参考:https://www.cnblogs.com/warking/p/5710303.html https://www.cnblogs.com 一.logback简介 1.logback: Log ...
- javascript/js实现 排序二叉树数据结构 学习随笔
二叉树是一种数据结构.其特点是: 1.由一系列节点组成,具有层级结构.每个节点的特性包含有节点值.关系指针.节点之间存在对应关系. 2.树中存在一个没有父节点的节点,叫做根节点.树的末尾存在一系列没有 ...
- 修改ssh的22端口
将ssh22端口修改为12345 https://www.cnblogs.com/chen-lhx/p/3974605.html # iptables开放12345端口iptables -I INPU ...
- java判定数据(对象)类型
1.说明一 int 是关键字,Integer是包装类,Number是所有数字了的基类(父类).所以,Number是Integer的基础,Integer是int的基础,也称Integer是int的原型类 ...
- 爬虫之 selenium模块
selenium模块 阅读目录 一 介绍 二 安装 三 基本使用 四 选择器 五 等待元素被加载 六 元素交互操作 七 其他 八 项目练习 一 介绍 selenium最初是一个自动化测试工具,而爬 ...
- Computer Vision_33_SIFT:An Improved RANSAC based on the Scale Variation Homogeneity——2016
此部分是计算机视觉部分,主要侧重在底层特征提取,视频分析,跟踪,目标检测和识别方面等方面.对于自己不太熟悉的领域比如摄像机标定和立体视觉,仅仅列出上google上引用次数比较多的文献.有一些刚刚出版的 ...
- jquery中的ajax方法(备忘)
参考:https://www.cnblogs.com/tylerdonet/p/3520862.html w3school:http://www.w3school.com.cn/jquery/ajax ...
- 管理Linux软件——apt
参考:Ubuntu的apt命令详解 apt命令是一个功能强大的命令行工具,它与Ubuntu的高级打包工具(APT,Advanced Packaging Tool )配合使用,可以执行安装新软件包,升级 ...