
python网络爬虫与信息提取 学习笔记day3
Day3:
只需两行代码解析html或xml信息 具体代码实现:day3_1 注意BeautifulSoup的B和S需要大写,因为python大小写敏感
import requests

r= requests.get("http://python123.io/ws/demo.html")

r.text

demo = r.text

from bs4 import BeautifulSoup

soup = BeautifulSoup(demo , "html.parser")

print(soup.prettify())
BeautifulSoup库的基本元素:详参html的基本信息
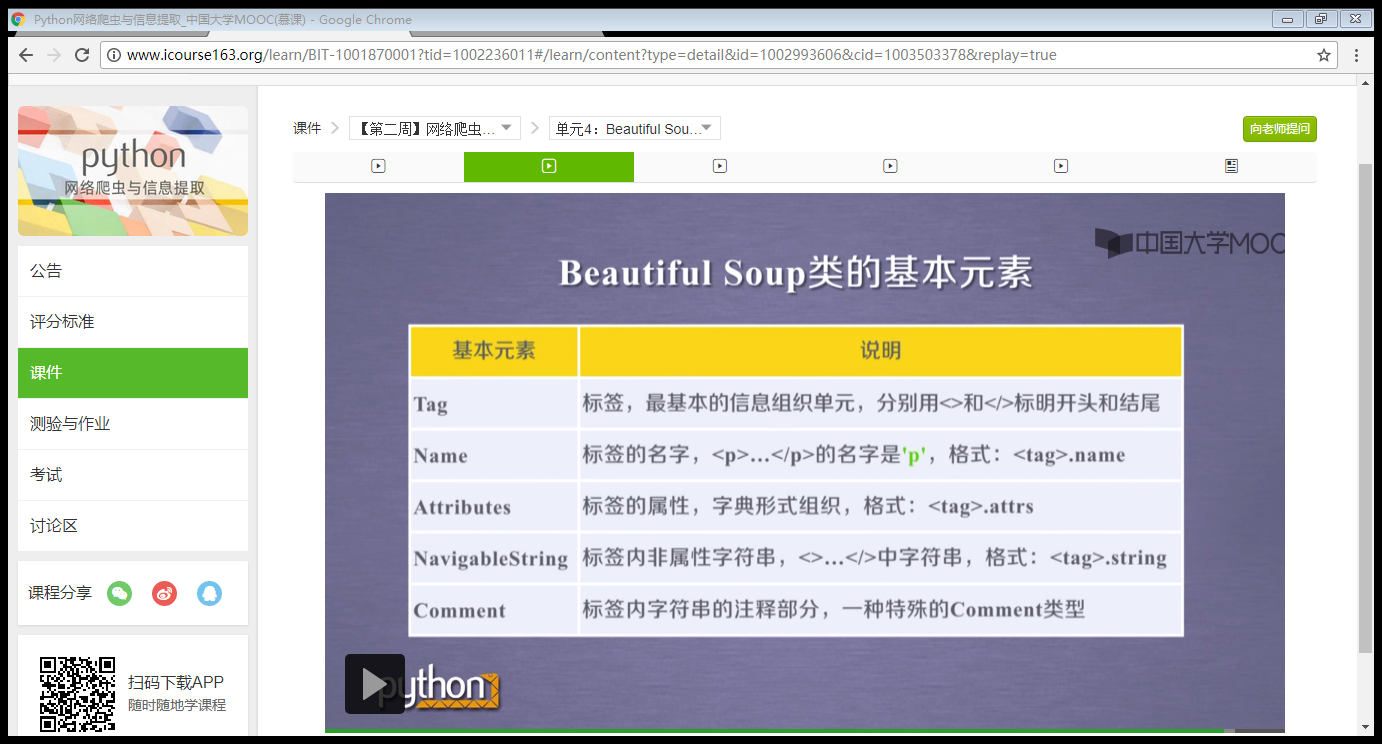
from bs4 import BeautifulSoup 语句含义:从bs4库中引入一个BeautifulSoup的类型

下行遍历,上行遍历和平行遍历:
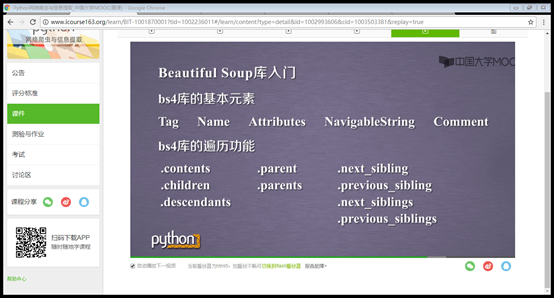
爬取中国大学排名
import requests

from bs4 import BeautifulSoup

import bs4

def getHTMLText(url):

    try:

        r = requests.get(url, timeout=30)

        r.raise_for_status()

        r.encoding = r.apparent_encoding

        return r.text

    except:

        return ""

def fillUnivList(ulist, html):

    soup = BeautifulSoup(html, "html.parser")

    for tr in soup.find('tbody').children:

        if isinstance(tr, bs4.element.Tag):

            tds = tr('td')

            ulist.append([tds[0].string, tds[1].string, tds[3].string])

def printUnivList(ulist, num):

    print("{:^10}\t{:^6}\t{:^10}".format("排名","学校名称","总分"))

    for i in range(num):

        u=ulist[i]

        print("{:^10}\t{:^6}\t{:^10}".format(u[0],u[1],u[2]))

def main():

    uinfo = []

    url = 'http://www.zuihaodaxue.cn/zuihaodaxuepaiming2016.html'

    html = getHTMLText(url)

    fillUnivList(uinfo, html)

    printUnivList(uinfo, 20) # 20 univs

main()
python网络爬虫与信息提取 学习笔记day3的更多相关文章
- python网络爬虫与信息提取 学习笔记day2
Day2: 查看robots协议: 查看京东的robots协议 查看百度的robots协议,可以看到百度拒绝了搜狗的爬虫233 爬取京东商品页面相关信息: import requests url = ...
- python网络爬虫与信息提取 学习笔记day1
Day1: 安装python之后,为其配置requests第三方库,并爬取百度主页内容. 语句解释: r.status_code检测请求的状态码,如果状态码为200,则说明访问成功,否则,则说明访问失 ...
- python 网络爬虫与信息提取 学习笔记day4
正则表达式简介: 简洁表示一组字符串的特征或者模式,在文本处理中十分常用,主要应用于字符串匹配中 1. 通用的字符串表达框架 2. 简洁表达一组字符串的表达式 3. 针对字符串表达简洁和特征思想 ...
- 第3次作业-MOOC学习笔记:Python网络爬虫与信息提取
1.注册中国大学MOOC 2.选择北京理工大学嵩天老师的<Python网络爬虫与信息提取>MOOC课程 3.学习完成第0周至第4周的课程内容,并完成各周作业 4.提供图片或网站显示的学习进 ...
- 第三次作业-MOOC学习笔记:Python网络爬虫与信息提取
1.注册中国大学MOOC 2.选择北京理工大学嵩天老师的<Python网络爬虫与信息提取>MOOC课程 3.学习完成第0周至第4周的课程内容,并完成各周作业 第一周 Requests库的爬 ...
- 第三次作业-Python网络爬虫与信息提取
1.注册中国大学MOOC 2.选择北京理工大学嵩天老师的<Python网络爬虫与信息提取>MOOC课程 3.学习完成第0周至第4周的课程内容,并完成各周作业 过程. 5.写一篇不少于100 ...
- Python网络爬虫与信息提取
1.Requests库入门 Requests安装 用管理员身份打开命令提示符: pip install requests 测试:打开IDLE: >>> import requests ...
- Python网络爬虫与信息提取笔记
直接复制粘贴笔记发现有问题 文档下载地址//download.csdn.net/download/hide_on_rush/12266493 掌握定向网络数据爬取和网页解析的基本能力常用的 Pytho ...
- 【学习笔记】PYTHON网络爬虫与信息提取(北理工 嵩天)
学习目的:掌握定向网络数据爬取和网页解析的基本能力the Website is the API- 1 python ide 文本ide:IDLE,Sublime Text集成ide:Pychar ...
随机推荐
- MongoDB 桌面管理器MongoVUE
MongoVUE是一个桌面GUI工具,专用于Windows平台,它有一个简洁.清爽的界面,它的基本功能是免费的.它可以以文本视图.树视图.表格视图来显示MongoDB的数据.还可以保持查询的结果供以后 ...
- UML类图三
2. 依赖关系 依赖(Dependency)关系是一种使用关系,特定事物的改变有可能会影响到使用该事物的其他事物,在需要表示一个事物使用另一个事物时使用依赖关系.大多数情况下,依赖关系体现在某个类的 ...
- wifislax中的linset软件钓鱼教程
wifislax中很多破解wifi密码的工具,下面就来说说里面的linset软件的钓鱼过程,国内很多人知道这个方法,不过没有总结,youtube上视频一大把,我刚才测试了一把,还是打算记录一下攻击过程 ...
- 世界上最好的语言搭建短链接及统计功能(附API代码)
前言 在这个营销的时代,短链接和二维码是企业进行营销中非常重要的工具,不仅仅是缩短了链接,而且还可以通过扩展获得更多的数据,诸如点击数.下载量.来源以及时间等等. 网上搜寻了一下比较有名有U.NU和0 ...
- pyenv 安装
sudo yum install openssl* git clone https://github.com/yyuu/pyenv.git ~/.pyenv echo 'export ...
- Java值传递和引用传递
Java总是在讨论是传递还是引用传递,Java没有像C语言那样拥有指针,在看到引用传递和值传递很多的解释之后,更相信引用传递和值传递归根到底都是值传递,只不过引用传递的时候看上去很高大上,其实是把变量 ...
- 笔记:Hibernate DML
Hibernate 提供的HQL(Hibernate Query Language)语句也支持批量 update 和 delete 语法,语法格式如下: [UPDATE | DELETE] FROM ...
- poj-1028 -网页导航
Description Standard web browsers contain features to move backward and forward among the pages rece ...
- POJ-1004-Finanical Management
Description Larry graduated this year and finally has a job. He's making a lot of money, but somehow ...
- [poj3468]A Simple Problem with Integers_线段树
A Simple Problem with Integers 题目大意:给出n个数,区间加.查询区间和. 注释:1<=n,q<=100,000.(q为操作次数). 想法:嗯...学了这么长 ...