
python+requests爬取百度文库ppt
实验网站:https://wenku.baidu.com/view/c7752014f18583d04964594d.html
在下面这种类型文件中的请求头的url打开后会得到一个页面
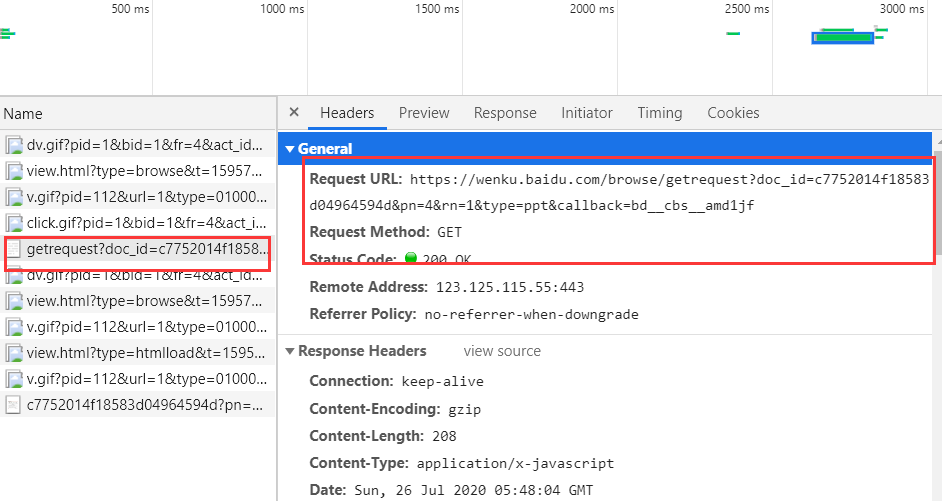
你会得到如下图一样的页面
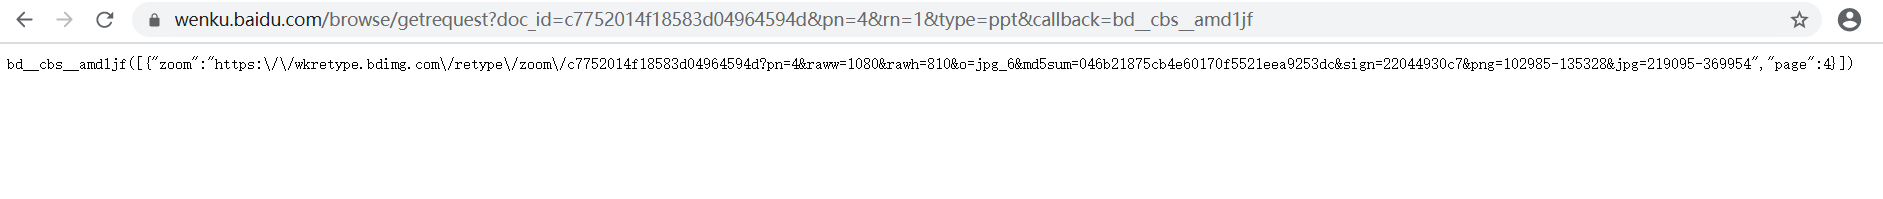
你将页面上zoom对应的值在一个新的网页打开之后会发现,这个就是ppt中的图片
你可以多打开几个“getrequest?doc_id”类型的请求头看一下它们的Request URL,你会发现我们只需要改变pn对应的数字就能得到文库中对应的PPT图片

知道了这个我们就可以先把图片url弄出来,然后再依次访问这些url,并下载至本地
要注意的是,如下面的url地址
https:\/\/wkretype.bdimg.com\/retype\/zoom\/c7752014f18583d04964594d?pn=4&raww=1080&rawh=810&o=jpg_6&md5sum=046b21875cb4e60170f5521eea9253dc&sign=22044930c7&png=102985-135328&jpg=219095-369954
你如果复制之后粘贴在浏览器的地址框里面,浏览器会把这个地址转化成下面这个类型之后再去访问
https://wkretype.bdimg.com//retype//zoom//c7752014f18583d04964594d?pn=4&raww=1080&rawh=810&o=jpg_6&md5sum=046b21875cb4e60170f5521eea9253dc&sign=22044930c7&png=102985-135328&jpg=219095-369954
所以在我们得到地址之后用一些函数处理一下就可以了
因为代码不太复杂,所以就不再详细叙述了
import requests

class Spider:

    def __init__(self):

        #定义url前缀

        self.url_pre = "https://wenku.baidu.com/browse/getrequest?doc_id=c7752014f18583d04964594d&pn="

        #定义url后缀

        self.url_suf = "&rn=1&type=ppt&callback=bd__cbs__sv0n59"

        #请求头

        self.headers = {

            'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/84.0.4147.89 Safari/537.36'

        }

    def Create_url(self):

        num = input('输入爬取ppt总页数:')

        for i in range(1,int(num)+1):

            #构建对应页数PPT的url地址

            self.url = self.url_pre+str(i)+self.url_suf

            #请求后得到页面源码

            response = requests.get(self.url,headers=self.headers)

            html = response.text

            #因为我们需要从页面源码中拿到PPT中图片对应地址,所以可以通过字符串匹配等方式得到,这里我就用数组查找就行

            #找出图片地址在源码中起始和终止位置

            start = html.find(':"http') + 2

            end = html.find('","')

            #切割字符串

            url_pic = html[start:end]

            #将图片url字符串,转化为可访问的url地址

            url_pic=url_pic.replace('\\','')

            #print(url_pic)

            self.request_pic(url_pic,i)

    def request_pic(self,url_pic,num):

        #print(url_pic)

        response = requests.get(url_pic, headers=self.headers)

        num = str(num)+'.png'

        with open(num,'wb') as f:

            f.write(response.content)

if __name__ == '__main__':

    spider = Spider()

    spider.Create_url()
python+requests爬取百度文库ppt的更多相关文章
- python+selenium爬取百度文库不能下载的word文档
有些时候我们需要用到百度文库的某些文章时,却发现需要会员才能下载,很难受,其实我们可以通过爬虫的方式来获取到我们所需要的文本. 工具:python3.7+selenium+任意一款编辑器 前期准备:可 ...
- python+selenium+bs4爬取百度文库内文字 && selenium 元素可以定位到,但是无法点击问题 && pycharm多行缩进、左移
先说一下可能用到的一些python知识 一.python中使用的是unicode编码, 而日常文本使用各类编码如:gbk utf-8 等等所以使用python进行文字读写操作时候经常会出现各种错误, ...
- python 利用selenium爬取百度文库的word文章
今天学习如何使用selenium库来爬取百度文库里面的收费的word文档 from selenium import webdriver from selenium.webdriver.common.k ...
- Python3实现QQ机器人自动爬取百度文库的搜索结果并发送给好友(主要是爬虫)
一.效果如下: 二.运行环境: win10系统:python3:PyCharm 三.QQ机器人用的是qqbot模块 用pip安装命令是: pip install qqbot (前提需要有request ...
- Python爬虫 - 爬取百度html代码前200行
Python爬虫 - 爬取百度html代码前200行 - 改进版, 增加了对字符串的.strip()处理 源代码如下: # 改进版, 增加了 .strip()方法的使用 # coding=utf-8 ...
- requests爬取百度音乐
使用requests爬取百度音乐,我想把当前热门歌手的音乐信息爬下来. 首先进行url分析,可以看到: 歌手网页: 薛之谦网页: 可以看到,似乎这些路劲的获取一切都很顺利,然后可以写代码: # -*- ...
- python 3 爬取百度图片
python 3 爬取百度图片 学习了:https://blog.csdn.net/X_JS612/article/details/78149627
- python爬虫-爬取百度图片
python爬虫-爬取百度图片(转) #!/usr/bin/python# coding=utf-8# 作者 :Y0010026# 创建时间 :2018/12/16 16:16# 文件 :spider ...
- 写一个python 爬虫爬取百度电影并存入mysql中
目标是利用python爬取百度搜索的电影 在类型 地区 年代各个标签下 电影的名字 评分 和图片连接 以及 电影连接 首先我们先在mysql中建表 create table liubo4( id in ...
随机推荐
- MySQL select if 查询最后一个主键 id
查询最后一个主键id SELECT IF(MAX(id) IS NULL, 0, MAX(id)) AS maxid FROM users; 查询最小的主键id SELECT IF(MIN(id) I ...
- Mongodb 安装和副本集集群搭建
通用步骤,适用于所有你需要用的软件. 总结为5大步骤: 找到官网-->下载包-->解压-->修改配置-->启动 不懂的,首选官网api,次选百度 1.安装mongodb mon ...
- bat批处理积累
1 ::所有命令不回显,包含echo off自身也不回显 2 @echo off 3 4 ::rem或双冒号都为注释行 5 6 rem 变量赋值,注意变量和等号之间不能有空格,等号后的空格会作为变量值 ...
- kubectl命令管理
kubectl命令管理 查看更多帮助命令 [root@k8s-master ~]# kubectl --help 创建一个命名空间 [root@k8s-master ~]# kubectl creat ...
- 单元测试:单元测试中的mock
公司要求提升单元测试的质量,提高代码的分支覆盖率和行覆盖率,安排我研究单元测试,指定方案分享并在开发部普及开.整理完资料后,同步一下到博客. 单元测试中的mock的目的 mock的主要目的是让单元测试 ...
- 浅谈JavaScript代码性能优化
可以通过https://jsbench.me/测试网站完成性能测试. 一.慎用全局变量 1.全局变量定义在全局执行上下文,是所有作用域链的顶端,在局部作用域中没找到的变量都会到全局变量中去查找,所以说 ...
- django之orm单表查询
这几天重新学习了一下django的orm,以此作为记录来分享. Part1:修改配置,生成表 在写数据和查数据之前,首先先得把django配置一下,具体配置如下: 1.先在公共项目的settings中 ...
- Py-解决粘包现象,tcp实现并发,tcp实现传输文件的程序,校验思路,线程与进程
黏包现象 TCP粘包就是指发送方发送的若干包数据到达接收方时粘成了一包,从接收缓冲区来看,后一包数据的头紧接着前一包数据的尾,出现粘包的原因是多方面的,可能是来自发送方,也可能是来自接收方TCP接收到 ...
- 07. struts2中对Action的管理方式
web.xml配置文件的常用代码 <filter> <filter-name>struts2</filter-name> <filter-class>o ...
- Android事件分发机制五:面试官你坐啊
前言 很高兴遇见你~ 事件分发系列文章已经到最后一篇了,先来回顾一下前面四篇,也当个目录: Android事件分发机制一:事件是如何到达activity的? : 从window机制出发分析了事件分发的 ...