
python 利用selenium爬取百度文库的word文章
今天学习如何使用selenium库来爬取百度文库里面的收费的word文档
from selenium import webdriver

from selenium.webdriver.common.keys import Keys

from pyquery import PyQuery as pq

from selenium.webdriver.support.ui import WebDriverWait

from selenium import webdriver

import time

options = webdriver.ChromeOptions()

options.add_argument('user-agent="Mozilla/5.0 (Linux; Android 4.0.4; Galaxy Nexus Build/IMM76B) AppleWebKit/535.19 (KHTML, like Gecko) Chrome/18.0.1025.133 Mobile Safari/535.19"')

driver = webdriver.Chrome('D:/chromedriver.exe',options=options)

url="https://wenku.baidu.com/view/aa31a84bcf84b9d528ea7a2c.html"

driver.get(url)

html=driver.page_source

page=driver.find_elements_by_xpath("/html/body/div[2]/div[2]/div[6]/div[2]/div[2]/div[1]/div/div[1]")#使用page标记记录百度文库中向下翻页的位置

driver.execute_script('arguments[0].scrollIntoView();', page)
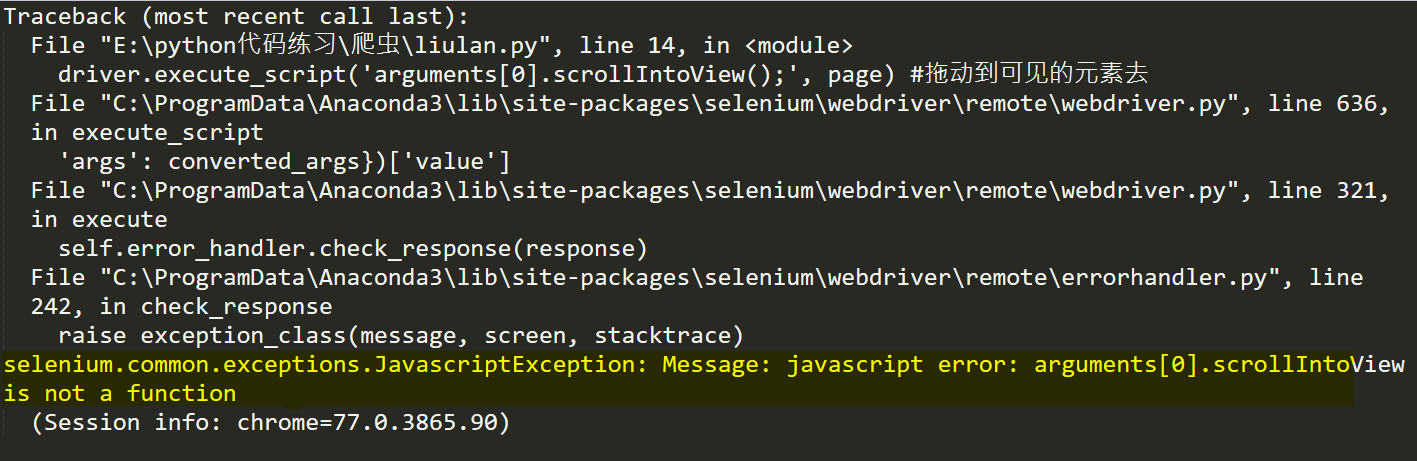
结果运行报错:
因为在百度文库页面底部需要点击“继续阅读”才可以加载到完整的页面,所以必须使用这两行代码
page=driver.find_elements_by_xpath("/html/body/div[2]/div[2]/div[6]/div[2]/div[2]/div[1]/div/div[1]")#使用page标记记录百度文库中向下翻页的位置

driver.execute_script('arguments[0].scrollIntoView();', page)
来将浏览器滚动到“继续阅读”这个位置,然后执行点击按钮。
但是却爆出了黄色部分的错误。找了好久,最后在stackoverflow上找到了答案,不得不说,stackoverflow还是强啊
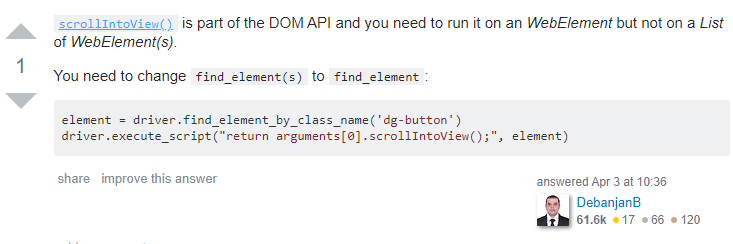
这哥们说,
scrollIntoView()
这个函数是属于DOM API ,因此你应该使用一个web元素来调用它,而不是一个web元素列表来使用它。
这是我认识到,我可能定位的元素并不是一个,所以我又重新定位了一下元素,更改的代码如下:
from selenium import webdriver

from selenium.webdriver.common.keys import Keys

driver = webdriver.Chrome('D:/chromedriver.exe')

driver.get("https://wenku.baidu.com/view/aa31a84bcf84b9d528ea7a2c.html")

page = driver.find_element_by_xpath("//*[@id='html-reader-go-more']/div[2]/div[1]/span/span[2]")

driver.execute_script('arguments[0].scrollIntoView();', page) #拖动到可见的元素去

driver.find_element_by_xpath("//*[@id='html-reader-go-more']/div[2]/div[1]/p").click()
然后就可以自动的加载所有文档内容啦
python 利用selenium爬取百度文库的word文章的更多相关文章
- python+selenium爬取百度文库不能下载的word文档
有些时候我们需要用到百度文库的某些文章时,却发现需要会员才能下载,很难受,其实我们可以通过爬虫的方式来获取到我们所需要的文本. 工具:python3.7+selenium+任意一款编辑器 前期准备:可 ...
- python+selenium+bs4爬取百度文库内文字 && selenium 元素可以定位到,但是无法点击问题 && pycharm多行缩进、左移
先说一下可能用到的一些python知识 一.python中使用的是unicode编码, 而日常文本使用各类编码如:gbk utf-8 等等所以使用python进行文字读写操作时候经常会出现各种错误, ...
- 利用Selenium爬取淘宝商品信息
一. Selenium和PhantomJS介绍 Selenium是一个用于Web应用程序测试的工具,Selenium直接运行在浏览器中,就像真正的用户在操作一样.由于这个性质,Selenium也是一 ...
- [Python爬虫] Selenium爬取新浪微博客户端用户信息、热点话题及评论 (上)
转载自:http://blog.csdn.net/eastmount/article/details/51231852 一. 文章介绍 源码下载地址:http://download.csdn.net/ ...
- Python3实现QQ机器人自动爬取百度文库的搜索结果并发送给好友(主要是爬虫)
一.效果如下: 二.运行环境: win10系统:python3:PyCharm 三.QQ机器人用的是qqbot模块 用pip安装命令是: pip install qqbot (前提需要有request ...
- 利用selenium爬取京东商品信息存放到mongodb
利用selenium爬取京东商城的商品信息思路: 1.首先进入京东的搜索页面,分析搜索页面信息可以得到路由结构 2.根据页面信息可以看到京东在搜索页面使用了懒加载,所以为了解决这个问题,使用递归.等待 ...
- 百度图片爬虫-python版-如何爬取百度图片?
上一篇我写了如何爬取百度网盘的爬虫,在这里还是重温一下,把链接附上: http://www.cnblogs.com/huangxie/p/5473273.html 这一篇我想写写如何爬取百度图片的爬虫 ...
- python+requests爬取百度文库ppt
实验网站:https://wenku.baidu.com/view/c7752014f18583d04964594d.html 在下面这种类型文件中的请求头的url打开后会得到一个页面 你会得到如下图 ...
- Python简易爬虫爬取百度贴吧图片
通过python 来实现这样一个简单的爬虫功能,把我们想要的图片爬取到本地.(Python版本为3.6.0) 一.获取整个页面数据 def getHtml(url): page=urllib.requ ...
随机推荐
- 在C#中使用二叉树实时计算海量用户积分排名的实现
从何说起 前些天和朋友讨论一个问题,他们的应用有几十万会员然后对应有积分,现在想做积分排名的需求,问有没有什么好方案.这个问题也算常见,很多地方都能看到,常规做法一般是数据定时跑批把计算结果到中间表然 ...
- CSRF绕过后端Referer校验
CSRF绕过后端Referer校验分正常情况和不正常的情况,我们这里主要讨论开发在写校验referer程序时,不正常的情况下怎么进行绕过. 正常情况 正常的情况指服务器端校验Referer的代码没毛病 ...
- springboot多环境(dev,test,prod)配置
前情提要 在我们开发工作中,常常因为配置的问题,搞得头昏脑大.开发环境.测试环境.配置各不相同,数据库.redis.注册中心等等参数都不一致,如果放在同一个配置文件,就会发现诸多注释,发布不同的环境, ...
- MariaDB的备份与主从、高可用实践
1.编写脚本,支持让用户自主选择,使用mysqldump还是xtraback全量备份. [root@test-centos7-node1 scripts]# cat chose_backup_mysq ...
- C++生成dll以及调用(函数)和类
C++新手,方法可能有很多,此方法仅仅是自己实验并可行,详细步骤如下: 生成dll文件和lib文件: (1) 新建项目-windows桌面向导,选择动态链接.dll以及空项目: (2)复制代码(头文件 ...
- Spring Boot2 系列教程 (十三) | 整合 MyBatis (XML 版)
前言 如题,今天介绍 SpringBoot 与 Mybatis 的整合以及 Mybatis 的使用,之前介绍过了 SpringBoot 整合MyBatis 注解版的使用,上一篇介绍过 MyBatis ...
- ipynb 文件转 py
前言 好多机器学习的文件都是ipynb的格式,如果想用其他编辑器的需要转为py的格式 命令: jupyter nbconvert --to script *.ipynb jupyter: pip3 i ...
- java面试题-集合类
准备年后要跳槽,所以最近一直再看面试题,并且把收集到的面试题整理了以下发到博客上,希望对大家有所帮助. 首先是集合类的面试题 1. HashMap 排序题,上机题. 已知一个 HashMap< ...
- 云原生 - 体验Istio的完美入门之旅(一)
作者:justmine 头条号:大数据达摩院 微信公众号:大数据处理系统 创作不易,在满足创作共用版权协议的基础上可以转载,但请以超链接形式注明出处. 为了方便大家阅读,可以关注头条号或微信公众号,后 ...
- 使用ajax向后台发送请求跳转页面无效的原因
Ajax只是利用脚本访问对应url获取数据而已,不能做除了获取返回数据以外的其它动作了.所以浏览器端是不会发起重定向的. 1)正常的http url请求,只有浏览器和服务器两个参与者.浏览器端发起一个 ...