
【sparkSQL】创建DataFrame及保存
首先我们要创建SparkSession
val spark = SparkSession.builder()

                        .appName("test")

                        .master("local")

                        .getOrCreate()

import spark.implicits._ //将RDD转化成为DataFrame并支持SQL操作
然后我们通过SparkSession来创建DataFrame
1.使用toDF函数创建DataFrame
通过导入(importing)spark.implicits, 就可以将本地序列(seq), 数组或者RDD转为DataFrame。
只要这些数据的内容能指定数据类型即可。
import spark.implicits._

val df = Seq(

  (1, "zhangyuhang", java.sql.Date.valueOf("2018-05-15")),

  (2, "zhangqiuyue", java.sql.Date.valueOf("2018-05-15"))

).toDF("id", "name", "created_time")
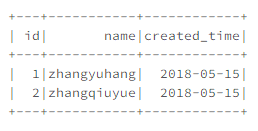
注意:如果直接用toDF()而不指定列名字,那么默认列名为"_1", "_2"
可以通过df.withColumnRenamed("_1", "newName1").withColumnRenamed("_2", "newName2")进行修改列名
2.使用createDataFrame函数创建DataFrame
通过schema + row 来创建
我们可以通俗的理解为schema为表的表头,row为表的数据记录
import org.apache.spark.sql.types._

//定义dataframe的结构的schema

val schema = StructType(List(

    StructField("id", IntegerType, nullable = false),

    StructField("name", StringType, nullable = true),

    StructField("create_time", DateType, nullable = true)

))

//定义dataframe内容的rdd

val rdd = sc.parallelize(Seq(

  Row(1, "zhangyuhang", java.sql.Date.valueOf("2018-05-15")),

  Row(2, "zhangqiuyue", java.sql.Date.valueOf("2018-05-15"))

))

//创建dataframe

val df = spark.createDataFrame(rdd, schema)
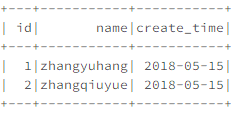
不过,我们可以把文件结构当做参数来使用,通过rdd自动产生schema和row,不用自己手动生成。
import org.apache.spark.sql.types._

//传入属性参数

val schemaString = " id name create_time"

//解析参数变成StructField

val fields = schemaString.split(" ")

                         .map(fieldName => StructField(fieldname, StringType, nullable = true))

//定义dataframe的结构的schema

val schema = StructType(fields)

//定义dataframe内容的rdd

val lines = sc.textFile("file:///people.txt")

val rdd = lines.spilt(_.split(","))

               .map(attributes=>ROW(attributes(0),attributes(1).trim) )

//创建dataframe

val df = spark.createDataFrame(rdd, schema)
3.通过反射机制创建DataFrame
首先要定义一个case class,因为只有case class才能被Spark隐式转化为DataFrame
import org.apache.spark.sql.catalyst.encoders.ExpressionEncoder

import org.apache.spark.sql.Encoder

import spark.implicits._

//创建匹配类

case class Person(id:Int,name:String,age:Long)

//读取文件生成rdd

val rdd = sc.textFile("file:///")

//通过匹配类把rdd转化成dataframe

val df = rdd.map(_.split(","))

            .map(attributes => Person(attributes(0),attributes(1),attributes(2).trim.toInt)) .toDF()
4.通过文件直接创建DataFrame
(1)使用parquet文件read创建
val df = spark.read.parquet("hdfs:/path/to/file")
(2)使用json文件read创建
val df = spark.read.json("examples/src/main/resources/people.json")
(3)使用csv文件load创建
val df = spark.read

        .format("com.databricks.spark.csv")

        .option("header", "true") //reading the headers

        .option("mode", "DROPMALFORMED")

        .load("csv/file/path")
(4)使用Hive表创建
spark.table("test.person") // 库名.表名 的格式

     .registerTempTable("person")  // 注册成临时表

spark.sql(

      """

        | select *

        | from person

        | limit 10

      """.stripMargin).show()
记得,最后我们要调用spark.stop()来关闭SparkSession。
5.保存
(1)通过df.write.format().save("file:///")保存
write.format()支持输出的格式有 JSON、parquet、JDBC、orc、csv、text等文件格式
,save()定义保存的位置
当我们保存成功后可以在保存位置的目录下看到文件,但是这个文件并不是一个文件而是一个目录。
里面的内容一般为
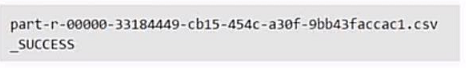
不用担心,这是没错的。
我们读取的时候,并不需要使用文件夹里面的part-xxxx文件,直接读取目录即可。
(2)通过df.rdd.saveAsTextFile("file:///")转化成rdd再保存
我们对于不同格式的文件读写来说,我们一般使用两套对应方式
val df = spark.read.格式("file:///")//读取文件

df.write.格式("file:///")//保存文件
val df = spark.read.format("").load("file:///")//读取文件

df.write.save("file:///")//保存文件
具体read和load方法有什么不同,我还不是很清楚,弄明白了回来补充。
6.通过JDBC创建DataFrame
我们在启动Spark-shell或者提交任务的时候需要添加相应的jar包
spark-shell(spark-submit)
--jars /usr/local/spark/mysql-connector-java-5.1.40/mysql-connector-java-5.1.40-bin.jar \
--driver-class-path /usr/local/spark/mysql-connector-java-5.1.40-bin.jar
val jdbcDf = spark.read.format("jdbc")

    .option("driver", "com.mysql.jdbc.Driver")   //驱动

    .option("url", "jdbc:mysql://ip:3306")  //数据库地址

    .option("dbtable", "db.user_test") //表名:数据库名.表名

    .option("user", "test") //用户名

    .option("password", "123456")  //密码

    .load()

jdbcDf.show()
【sparkSQL】创建DataFrame及保存的更多相关文章
- 【Spark篇】---SparkSQL初始和创建DataFrame的几种方式
一.前述 1.SparkSQL介绍 Hive是Shark的前身,Shark是SparkSQL的前身,SparkSQL产生的根本原因是其完全脱离了Hive的限制. SparkSQL支持查询原 ...
- JAVA SparkSQL初始和创建DataFrame的几种方式
建议参考SparkSQL官方文档:http://spark.apache.org/docs/latest/sql-programming-guide.html 一.前述 1.SparkSQ ...
- 大数据学习day24-------spark07-----1. sortBy是Transformation算子,为什么会触发Action 2. SparkSQL 3. DataFrame的创建 4. DSL风格API语法 5 两种风格(SQL、DSL)计算workcount案例
1. sortBy是Transformation算子,为什么会触发Action sortBy需要对数据进行全局排序,其需要用到RangePartitioner,而在创建RangePartitioner ...
- Spark SQL初始化和创建DataFrame的几种方式
一.前述 1.SparkSQL介绍 Hive是Shark的前身,Shark是SparkSQL的前身,SparkSQL产生的根本原因是其完全脱离了Hive的限制. SparkSQL支持查询原 ...
- SparkSQL和DataFrame
SparkSQL和DataFrame SparkSQL简介 Spark SQL是Spark用来处理结构化数据的一个模块,它提供了一个编程抽象叫做DataFrame并且作为分布式SQL查询引擎的作用.它 ...
- Spark之 SparkSql、DataFrame、DataSet介绍
SparkSql SparkSql是专门为spark设计的一个大数据仓库工具,就好比hive是专门为hadoop设计的一个大数据仓库工具一样. 特性: .易整合 可以将sql查询与spark应用程序进 ...
- 小记--------sparksql和DataFrame的小小案例java、scala版本
sparksql是spark中的一个模块,主要用于进行结构化数据的处理,他提供的最核心的编程抽象,就是DataFrame.同时,sparksql还可以作为分布式的sql查询引擎. 最最重要的功能就是从 ...
- Spark Java创建DataFrame
以前用Python和Scala操作Spark的时候比较多,毕竟Python和Scala代码写起来要简洁很多. 今天一起来看看Java版本怎么创建DataFrame,代码写起来其实差不多,毕竟公用同一套 ...
- 大数据学习day25------spark08-----1. 读取数据库的形式创建DataFrame 2. Parquet格式的数据源 3. Orc格式的数据源 4.spark_sql整合hive 5.在IDEA中编写spark程序(用来操作hive) 6. SQL风格和DSL风格以及RDD的形式计算连续登陆三天的用户
1. 读取数据库的形式创建DataFrame DataFrameFromJDBC object DataFrameFromJDBC { def main(args: Array[String]): U ...
随机推荐
- 再谈Redis应用场景(转)
原文:在谈Redis应用场景 一.MySql+Memcached架构的问题 实际MySQL是适合进行海量数据存储的,通过Memcached将热点数据加载到cache,加速访问,很多公司都曾经使用过这样 ...
- sql 使用select 生成json
) FROM ( SELECT ( '{"organizationTitle":"' + [Name] + '"' ,',"orgainization ...
- jvm堆配置参数
1.-Xms初始堆大小默认物理内存的1/64(<1GB)(官方建议)2.-Xmx最大堆大小默认物理内存的1/4(<1GB)(官方建议),实际中建议不大于4GB3.一般建议设置 -Xms=- ...
- BCrypt 加密实现
Bcrypt百度百科: bcrypt,是一个跨平台的文件加密工具.由它加密的文件可在所有支持的操作系统和处理器上进行转移.它的口令必须是8至56个字符,并将在内部被转化为448位的密钥. 除了对您的数 ...
- 知乎Live总结-重复nature文章笔记Single-cell
来自知乎Live-孟浩巍 1.文章重要技术及图讲解 首先在转录组RNA-seq中,有基因表达差异.基因融合.可变剪切.RNA单点突变. 在基因组中,单点变异.结构变异,CNV变异(拷贝数变异) 三类基 ...
- jQuery Mobile 手动显示ajax加载器
在jquery mobile开发中,经常需要调用ajax方法,异步获取数据,如果异步获取数据方法由于网速等等的原因,会有一个反应时间,如果能在点击按钮后数据处理期间,给一个正在加载的提示,客户体验会更 ...
- 解锁CHM文件
刚在网上下载了CHM格式的文件,打开之后,右侧部分一片空白. 原因:可能是,系统针对来源不明文件的一种保存措施吧 解决方法: 1.选中文件,右键打开属性对话框,在 “常规”选项卡中 勾选 [解除锁定] ...
- Javascript中call()和apply()的用法 ----2
前言 call 和 apply 都是为了改变某个函数运行时的 context 即上下文而存在的,换句话说,就是为了改变函数体内部 this 的指向.call 和 apply二者的作用完全一样,只是接受 ...
- hadoop10---消息队列
java消息队列 BlockingQueue也是java.util.concurrent下的主要用来控制线程同步的工具.锁也是用来控制线程同步的,释放锁的时候谁拿到了锁是没有预测的,所以谁拿到了锁是不 ...
- MySQL性能优化之max_connections参数
很多开发人员都会遇见”MySQL: ERROR 1040: Too many connections”的异常情况,造成这种情况的一种原因是访问量过高,MySQL服务器抗不住,这个时候就要考虑增加从服务 ...