
JZOJ 4319. 【NOIP2015模拟11.5】Lucas的数列
题目
思路
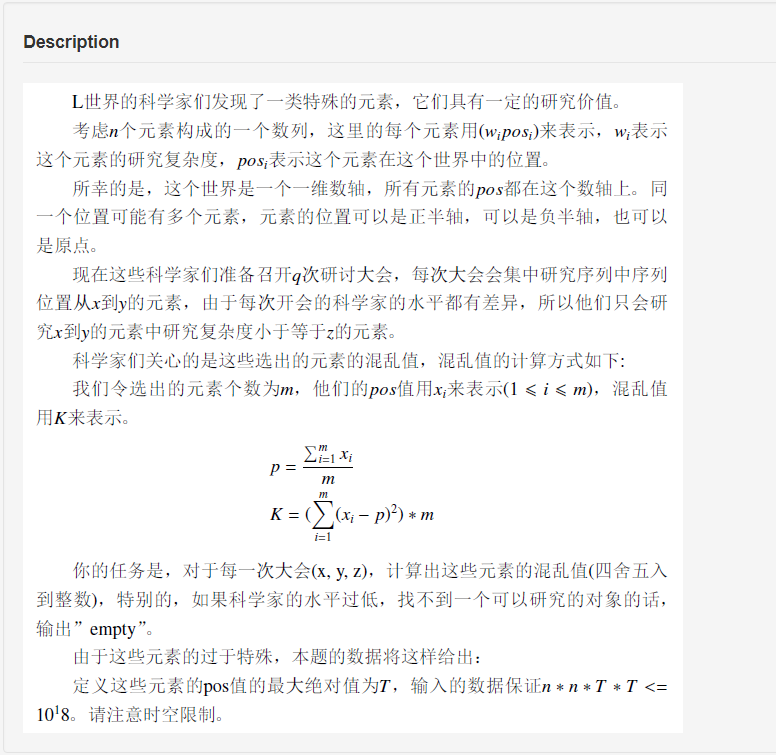
暴力很好打,我们显然可以先把关于 \(k\) 的式子拆开
先二项式展开,然后把外面的 \(m\) 乘进去,把 \(p\) 的分母 \(m\) 消去
\(K = (\sum_{i=1}^m (x_i - p)^2) \times m = m \times \sum_{i=1}^m x_i^2 - (\sum_{i=1}^m x_i)^2\)
发现它只剩下整数的乘和减运算
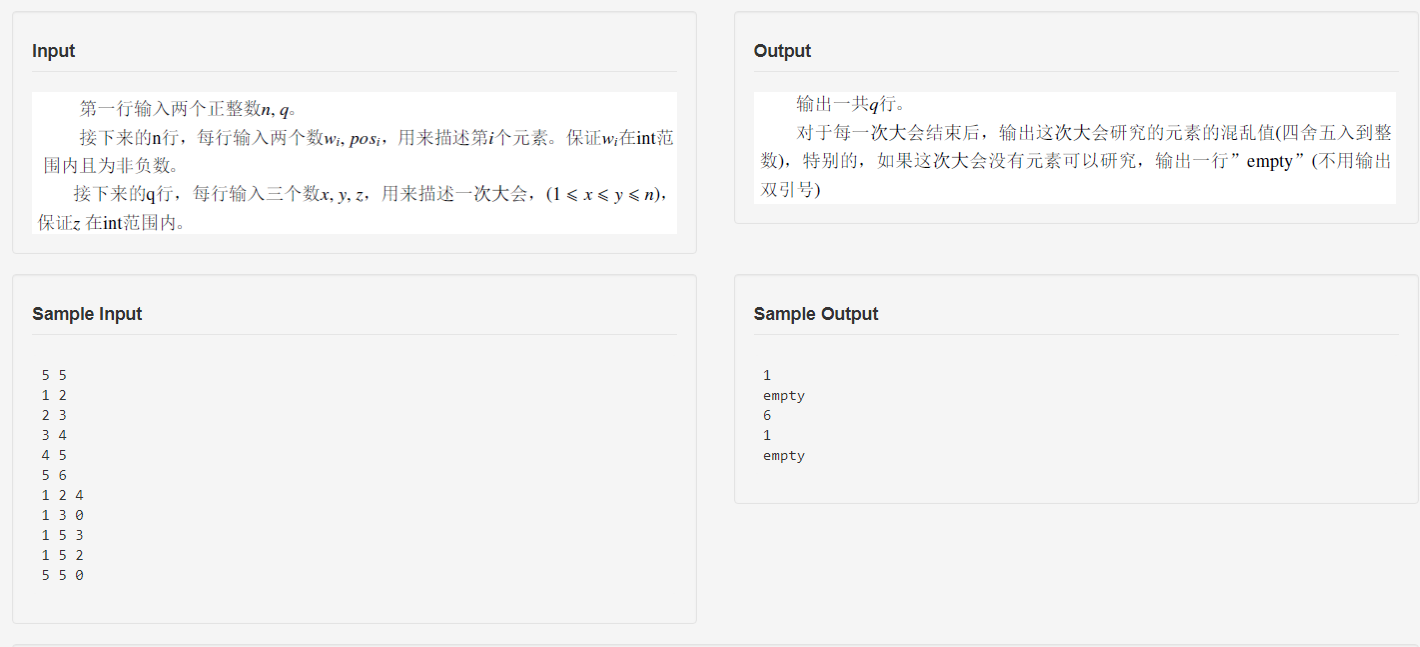
其实可以看出我们需要维护的东西:区间小于等于 \(z\) 的数的个数,这些数的和,这些数的平方的和
那么我们怎么维护区间小于等于 \(z\) 的数的信息呢?
对于这种二维偏序问题,经典的做法是在线的主席树
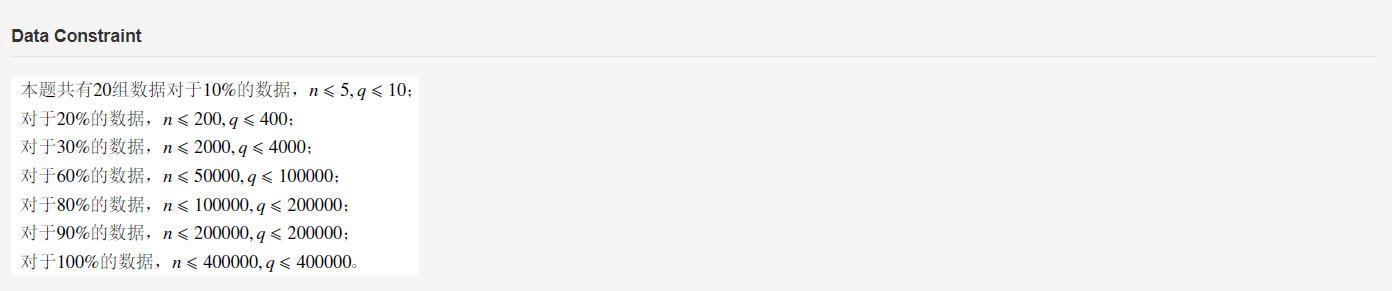
然而空间卡得不行不行的
所以我们考虑离线做法
依照题目意思,唯有 \(w \leq z\) 的数会对当前答案产生贡献
我们离线,先按照 \(w,z\) 从小到大排序
那么我们按这个顺序做下去,每遇到一个点就将其以它在原序列中的编号插入到某种数据结构中
遇到一个询问时,我们已经保证了 \(w \leq z\) 的数在这个数据结构中,只要查询区间 \([l..r]\) 的信息就好
因为空间的恶心,推荐使用树状数组

\(Code\)
#include<cstdio>

#include<algorithm>

using namespace std;

typedef long long LL;

const int N = 4e5 + 5;

const LL INF = -1e18 - 1e15;

LL m , ps1 , ps2 , ans[N];

int n , q , h[N] , tot;

struct question{

	int to , nxt;

}c[N];

struct ask{

	int x , y , z , id;

}a[N];

struct node{

	int w , id;

	LL pos;

}b[N];

struct segment{

	int cnt;

	LL pos1 , pos2;

}seg[N];

inline bool cmp1(node x , node y){return x.w < y.w;}

inline bool cmp2(ask x , ask y){return x.z < y.z;}

inline void addask(int id1 , int id2){c[++tot].to = id2 , c[tot].nxt = h[id1] , h[id1] = tot;}

inline int lowbit(int x){return x & (-x);}

inline void update(int x , int ct , LL p1 , LL p2)

{

	for(; x <= n; x += lowbit(x))

		seg[x].cnt += ct , seg[x].pos1 += p1 , seg[x].pos2 += p2;

}

inline void query(int x , int fl)

{

	for(; x; x -= lowbit(x))

		m += (LL)seg[x].cnt * fl , ps1 += seg[x].pos1 * fl , ps2 += seg[x].pos2 * fl;

}

int main()

{

	freopen("sequence.in" , "r" , stdin);

	freopen("sequence.out" , "w" , stdout);

	scanf("%d%d" , &n , &q);

	for(register int i = 1; i <= n; i++) scanf("%d%lld" , &b[i].w , &b[i].pos) , b[i].id = i;

	for(register int i = 1; i <= q; i++) scanf("%d%d%d" , &a[i].x , &a[i].y , &a[i].z) , a[i].id = i;

	sort(b + 1 , b + n + 1 , cmp1) , sort(a + 1 , a + q + 1 , cmp2);

	int l , r , mid , res;

	for(register int i = 1; i <= q; i++)

	{

		l = 1 , r = n , mid , res = 0;

		while (l <= r)

		{

			mid = (l + r) >> 1;

			if (b[mid].w <= a[i].z) res = mid , l = mid + 1;

			else r = mid - 1;

		}

		if (res == 0) ans[a[i].id] = INF;

		else addask(res , i);

	}

	for(register int i = 1; i <= n; i++)

	{

		update(b[i].id , 1 , b[i].pos , b[i].pos * b[i].pos);

		for(register int j = h[i]; j; j = c[j].nxt)

		{

			int id = c[j].to;

			ps1 = ps2 = 0 , m = 0;

			query(a[id].y , 1) , query(a[id].x - 1 , -1);

			if (m == 0)

			{

				ans[a[id].id] = INF;

				continue;

			}

			ans[a[id].id] = m * ps2 - ps1 * ps1;

		}

	}

	for(register int i = 1; i <= q; i++)

	{

		if (ans[i] == INF) printf("empty\n");

		else printf("%lld\n" , ans[i]);

	}

}
其实这题有个很暴力的方法
分块大法好!!!
我们维护一个分块数组
它包括每个点的 \(w,pos\)
然后同一块内的数按 \(w\) 从小到大排序
维护前缀和包括一次方和二次方的
查询只需要二分找块中的位置
前缀和更新即可

\(Code\)
#include<cstdio>

#include<cmath>

#include<algorithm>

using namespace std;

typedef long long LL;

const int N = 4e5 + 5;

LL m , pos[N] , ps1 , ps2;

int n , q , w[N] , st[N] , ed[N] , num , belong[N];

struct node{

	int w;

	LL pos , pos1 , pos2;

}t[N];

inline bool cmp(node x , node y){return x.w < y.w;}

inline void parepre()

{

	num = (int)sqrt(n);

	for(register int i = 1; i <= num; i++) st[i] = n / num * (i - 1) + 1 , ed[i] = n / num * i;

	ed[num] = n;

	for(register int i = 1; i <= num; i++)

	{

		for(register int j = st[i]; j <= ed[i]; j++) belong[j] = i , t[j] = (node){w[j] , pos[j] , 0 , 0};

		sort(t + st[i] , t + ed[i] + 1 , cmp);

		for(register int j = st[i]; j <= ed[i]; j++)

		{

			(j == st[i] ? (t[j].pos1 = t[j].pos) : (t[j].pos1 = t[j - 1].pos1 + t[j].pos));

			(j == st[i] ? (t[j].pos2 = t[j].pos * t[j].pos) : (t[j].pos2 = t[j - 1].pos2 + t[j].pos * t[j].pos));

		}

	}

}

inline void query(int l , int r , int z)

{

	int x = belong[l] , y = belong[r];

	if (x == y)

	{

		for(register int i = l; i <= r; i++)

		if (w[i] <= z) m++ , ps1 += pos[i] , ps2 += pos[i] * pos[i];

		return;

	}

	for(register int i = l; i <= ed[x]; i++)

	if (w[i] <= z) m++ , ps1 += pos[i] , ps2 += pos[i] * pos[i];

	for(register int i = st[y]; i <= r; i++)

	if (w[i] <= z) m++ , ps1 += pos[i] , ps2 += pos[i] * pos[i];

	int l1 , r1 , mid , ret;

	for(register int i = x + 1; i <= y - 1; i++)

	{

		l1 = st[i] , r1 = ed[i] , ret = 0;

		while (l1 <= r1)

		{

			mid = (l1 + r1) >> 1;

			if (t[mid].w <= z) ret = mid , l1 = mid + 1;

			else r1 = mid - 1;

		}

		if (ret) m += ret - st[i] + 1 , ps1 += t[ret].pos1 , ps2 += t[ret].pos2;

	}

}

int main()

{

	freopen("sequence.in" , "r" , stdin);

	freopen("sequence.out" , "w" , stdout);

	scanf("%d%d" , &n , &q);

	for(register int i = 1; i <= n; i++) scanf("%d%lld" , &w[i] , &pos[i]);

	parepre();

    int x , y , z;

	while (q--)

	{

		scanf("%d%d%d" , &x , &y , &z);

		ps1 = ps2 = 0 , m = 0;

		query(x , y , z);

		if (m == 0)

		{

			printf("empty\n");

			continue;

		}

		LL k = m * ps2 - ps1 * ps1;

		printf("%lld\n" , k);

	}

}
JZOJ 4319. 【NOIP2015模拟11.5】Lucas的数列的更多相关文章
- [JZOJ 4307] [NOIP2015模拟11.3晚] 喝喝喝 解题报告
题目链接: http://172.16.0.132/senior/#main/show/4307 题目: 解题报告: 题目询问我们没出现坏对的连续区间个数 我们考虑从左到有枚举右端点$r$,判断$a[ ...
- 【NOIP2015模拟11.5】JZOJ8月5日提高组T2 Lucas的数列
[NOIP2015模拟11.5]JZOJ8月5日提高组T2 Lucas的数列 题目 PS:\(n*n*T*T<=10^{18}\)而不是\(10^1*8\) 题解 题意: 给出\(n\)个元素的 ...
- JZOJ 4298. 【NOIP2015模拟11.2晚】我的天
4298. [NOIP2015模拟11.2晚]我的天 (File IO): input:ohmygod.in output:ohmygod.out Time Limits: 1000 ms Memor ...
- 【NOIP2015模拟11.5】JZOJ8月5日提高组T1 俄罗斯套娃
[NOIP2015模拟11.5]JZOJ8月5日提高组T1 俄罗斯套娃 题目 题解 题意就是说 将1~\(n\)排列,问有多少种方案使得序列的逆序对个数小于\(k\) 很容易想到DP 设\(f[i][ ...
- 【NOIP2015模拟11.2晚】JZOJ8月4日提高组T2 我的天
[NOIP2015模拟11.2晚]JZOJ8月4日提高组T2 我的天 题目 很久很以前,有一个古老的村庄--xiba村,村子里生活着n+1个村民,但由于历届村长恐怖而且黑暗的魔法统治下,村民们各自过着 ...
- 【NOIP2015模拟11.4】JZOJ2020年8月6日提高组T2 最优交换
[NOIP2015模拟11.4]JZOJ2020年8月6日提高组T2 最优交换 题目 题解 题意 有一个长度为\(n\)的正整数 最多可以进行\(k\)次操作 每次操作交换相邻两个位置上的数 问可以得 ...
- 【NOIP2015模拟11.4】JZOJ8月6日提高组T1 刷题计划
[NOIP2015模拟11.4]JZOJ8月6日提高组T1 刷题计划 题目 题解 题意 有\(n\)道题,编号为1~\(n\) 给出\(m\)次操作 每次操作有3种类型 1 \(x\) 表示交了\(A ...
- 【NOIP2015模拟11.5】JZOJ8月5日提高组T3 旅行
[NOIP2015模拟11.5]JZOJ8月5日提高组T3 旅行 题目 若不存在第\(k\)短路径时,输出"Stupid Mike" 题解 题意 给出一个有\(n\)个点的树 问这 ...
- 【NOIP2015模拟11.3】备用钥匙
题目 你知道Just Odd Inventions社吗?这个公司的业务是"只不过是奇妙的发明(Just Odd Inventions)".这里简称为JOI社. JOI社有N名员工, ...
- JZOJ4307. 【NOIP2015模拟11.3晚】喝喝喝
Description
随机推荐
- SSH(一)架包的引入
一年多未使用了,有些东西真的会忘. 一.ssh的图形化记忆运作流程 二.Struts2.hibernate.spring需要引用的jar包 Struts2: 基本开发:struts-2.3.32\ap ...
- 24V转5V降压芯片,24V转3.3V的稳压芯片,中文规格书
一般说明PW2312 是一个高频,同步,整流,降压,开关模式转换器内部功率 MOSFET.它提供了一个非常紧凑的解决方案,以实现 1.5A 的峰值输出电流在广泛的输入电源范围内,具有优良的负载和线路调 ...
- latex 中添加Springer LNCS 模板的\bibitem{}格式参考文献方法
1.将需要引用的参考文献新建为.bib格式,例如referencesTest.bib文件,具体如下: 新建txt文件,后缀名改为.bib: 然后打开谷歌学术,搜索参考文献, 点击导入BibTeX,具体 ...
- keras小点记录
Keras学习小点记录 1.axis(轴) (1)解释 参考链接:https://www.zhihu.com/question/58993137 (2)测试 参考链接:http://keras-cn. ...
- TypeScript 之 Type
Type 描述:全称叫做 '类型别名',为类型字面量提供名称.比 Interface 支持更丰富的类型系统特性. Type 与 Interface 区别 Interface 只能描述对象的形状,Typ ...
- Python requests 上传文件(以上传图片为例)
from requests_toolbelt import MultipartEncoderimport requests encoderl = MultipartEncoder( fields = ...
- RFN-Nest_ An end-to-end residual fusion network for infrared and visible images 论文解读
RFN-Nest 2021 研究 图像融合分为三步:特征提取,融合策略,图像重建. 当前端到端的图像融合方法:基于GAN的.还有本文提出的 研究背景:当前设计的融合策略在为特定任务生成融合图像方面是比 ...
- <五>function的实现原理
类模版std::function是一种通用.多态的函数封装.std::function的实例可以对任何可以调用的目标实体进行存储.复制.和调用操作,这些目标实体包括普通函数.Lambda表达式.函数指 ...
- selenium 之可视模式、静默模式、忽略证书不可用的设置
1.可视模式的设置(在前台工作) from selenium import webdriver import time url = "https://y.qq.com/n/ryqq/song ...
- 【深入浅出 Yarn 架构与实现】4-2 RM 管理 Application Master
上一篇文章对 ResourceManager 整体架构和功能进行了讲述.本篇将对 RM 中管理 Application Master 的部分进行深入的讲解. 下面将会介绍 RM 与 AM 整体通信执行 ...