
python: 爬取[博海拾贝]图片脚本
练手代码,聊作备忘:
# encoding: utf-8

# from __future__ import unicode_literals

import urllib

import urllib2

import re

import os

import time

from threading import Thread

class BhsbSpider(object):

    _url = r'https://bh.sb/post/category/main/';

    _page_count = 0

    _page_index = 0

    def __init__(self, url, page_count = 0):

        self._url = url

        self._page_count = page_count

        folder = '博海拾贝'.decode('utf-8')

        if not os.path.exists(folder):

            os.mkdir(folder)

    def spider(self):

        while self._page_index < self._page_count:

            self._page_index += 1

            self._url = r'https://bh.sb/post/category/main/page/%d' % self._page_index

            self.do_spider(self._url)

    def do_spider(self, url):

        html = self.get_html(url)

        pattern = r'(?s)<h2><a\s+href="(?P<url>[^"]+).*?>\[博海拾贝\d+\](?P<title>[^<]+).*?'

        for i, m in enumerate(re.findall(pattern, html)):

            info = '%d. url: %s, title: %s' % ((self._page_index - 1) * 20 + i + 1, m[0], m[1])

            print info

            # 多线程爬取页面

            Thread(target=self.download, args=(m[0], m[1])).start()

            time.sleep(2)

    def download(self, url, title):

        title = '博海拾贝\\' + title

        title = title.decode('utf-8')

        if not os.path.exists(title):

            os.mkdir(title)

        html = self.get_html(url)

        pattern = r'(?s)<p>(?P<title>[^<]+).*?<p><img\s+src="(?P<image>[^"]+)"'

        for i, m in enumerate(re.findall(pattern, html)):

            img_title = m[0]

            img_url = m[1]

            img_filename = '%s/%s%s' % (title.encode('utf-8'), img_title, os.path.splitext(img_url)[1])

            img_filename = img_filename.decode('utf-8')

            print 'download %s ...' % img_filename

            if not os.path.exists(img_filename):

                Thread(target=urllib.urlretrieve, args=(img_url, img_filename)).start()

                time.sleep(1)

    def get_html(self, url):

        try:

            url = url.encode('utf-8')

            req = urllib2.Request(url)

            req.add_header('User-Agent', 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Maxthon/4.9.5.1000 Chrome/39.0.2146.0 Safari/537.36')

            page = urllib2.urlopen(req)

            return page.read()

        except Exception as ex:

            print 'get url_%s html error, ex=%s' % (url, ex)

if __name__ == '__main__':

    url = r'https://bh.sb/post/category/main/'

    bs = BhsbSpider(url, 10)

    bs.spider()
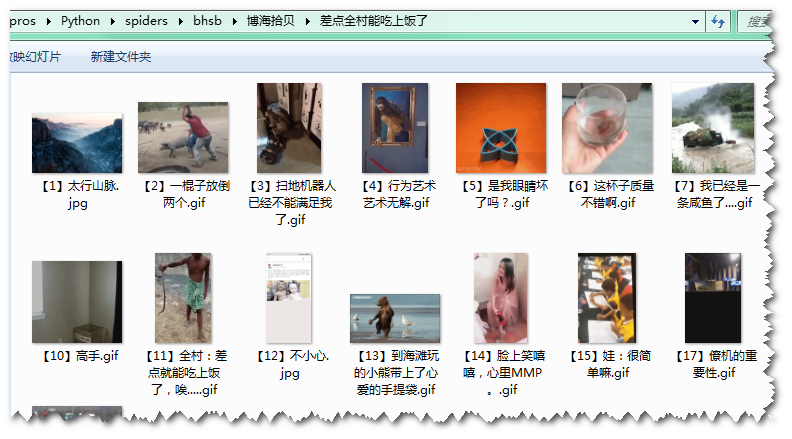
未及细测试,其间有图片丢失情况。结果如下图示:
python: 爬取[博海拾贝]图片脚本的更多相关文章
- python爬取博客圆首页文章链接+标题
新人一枚,初来乍到,请多关照 来到博客园,不知道写点啥,那就去瞄一瞄大家都在干什么好了. 使用python 爬取博客园首页文章链接和标题. 首先当然是环境了,爬虫在window10系统下,python ...
- Python 爬取陈都灵百度图片
Python 爬取陈都灵百度图片 标签(空格分隔): 随笔 今天意外发现了自己以前写的一篇爬虫脚本,爬取的是我的女神陈都灵,尝试运行了一下发现居然还能用.故把脚本贴出来分享一下. import req ...
- python爬取某个网页的图片-如百度贴吧
python爬取某个网页的图片-如百度贴吧 作者:vpoet mail:vpoet_sir@163.com 注:随意copy,不用告诉我 #coding:utf-8 import urllib imp ...
- python爬取某个网站的图片并保存到本地
python爬取某个网站的图片并保存到本地 #coding:utf- import urllib import re import sys reload(sys) sys.setdefaultenco ...
- Python爬取 | 唯美女生图片
这里只是代码展示,且复制后不能直接运行,需要配置一些设置才行,具体请查看下方链接介绍: Python爬取 | 唯美女生图片 from selenium import webdriver from fa ...
- python爬取网页文本、图片
从网页爬取文本信息: eg:从http://computer.swu.edu.cn/s/computer/kxyj2xsky/中爬取讲座信息(讲座时间和讲座名称) 注:如果要爬取的内容是多页的话,网址 ...
- Python爬取mn52网站美女图片以及图片防盗链的解决方法
防盗链原理 http标准协议中有专门的字段记录referer 一来可以追溯上一个入站地址是什么 二来对于资源文件,可以跟踪到包含显示他的网页地址是什么 因此所有防盗链方法都是基于这个Referer字段 ...
- python爬取并批量下载图片
import requests from lxml import etree url='http://desk.zol.com.cn/meinv/' add1='.html' urls=[] i = ...
- Python爬取百度贴吧图片
一.获取URL Urllib 模块提供了读取web页面数据的接口,我们可以像读取本地文件一样读取www和ftp上的数据.首先,我们定义了一个getHtml()函数: urllib.urlopen()方 ...
随机推荐
- 提问:MicrosoftUnderlying input stream returned zero bytes
报错信息:MicrosoftUnderlying input stream returned zero bytes 报错截图: 查阅资料后,提示 jdbc的bug,不能将一个"NULL&qu ...
- Nuget调用简单封装.
1. 项目引用Dapper作为直接访问, 为了使用方便, 封装一下.达到效果: - 数据库连接配置在webconfig.xml中. - 常用调用方法封装. 调用: //可以采用单例模式. //全局实 ...
- Mysql优化批量插入数据
最近为了测试项目,需要在Mysql中插入百万级测试数据,于是用到了批量插入,自己写了个简单的Spring Cloud项目. 开始时执行效率很慢,大概100条/秒,批次的大小也试过1000,2000,5 ...
- 机器学习笔记之二-win10+cuda9.1+CUDNN7+Anaconda3+VS2017+tensorflow1.5+opencv3.4
[Tensorflow]环境搭建vs2017+win10+py3.6+cuda9.1+cudnn7+tf1.5 一.安装cuda 9.1+VS2017 一路下一步即可,环境变量cuda会自动配好 ...
- 三、CSS样式——字体
概念: CSS字体属性定义文本的字体系列.大小.加粗.风格和变形. 属性 描述 font-family 设置字体系列 font-size 设置字体的大小 font-style 设置字体的风格 font ...
- Flask即插视图与tornado比较
由于公司使用了Tornado框架和Flask框架,之前一直使用的都是Flask框架,已经对url下面紧跟着视图的写法很固执.刚开始接触Tornado框架,对于其url和视图分开的写法思想上无法转变.今 ...
- 五分钟搞定Go.js
五分钟搞定Go.js 1.基于html5~因为Go.js是一个依赖于HTML5特性的JavaScript库,所以需要确保您的页面声明它是一个HTML5文档,当然需要加载库 <!DOCTYPE ...
- .yaml参数文件的编写和使用
一.在ROS底下使用.yaml文件配置参数 在ROS底下用起来还是非常方便的,首先,写一个读参数的函数getParam(),由于参数类型不止一种,所以要使用模板. 具体语句如下: template&l ...
- request和response的常用方法
一.request 1.setAttribute()在Request域中存储数据 2.setCharacterEncoding()设置请求参数的编码方式,只对post请求有效 3.getMet ...
- python 配置文件解析模块 configparser
import ConfigParser //实例化cf = ConfigPraser.ConfigPraser()cf.read("配置文件") //获取所有sections.也就 ...