
爬虫(六):XPath、lxml模块
1. XPath
1.1 什么是XPath
XPath(XML Path Language) 是一门在XML和HTML文档中查找信息的语言,可用来在XML和HTML文档中对元素和属性进行遍历。
1.2 XPath开发工具
1.2.1 Chrome插件XPath Helper
https://jingyan.baidu.com/article/1e5468f94694ac484861b77d.html
1.2.2 Firefox插件XPath Checker
https://blog.csdn.net/menofgod/article/details/75646443
1.3 Xpath语法
这个就要看我写的selenium基础中的文章了。
https://www.cnblogs.com/liuhui0308/p/11937139.html
2. lxml模块
lxml是一个HTML/XML的解析库,主要功能是如何解析和提取HTML/XML数据。
lxml和正则是一样,也是用C语言实现的,是一款高性能的Python HTML/XML解析器,可以利用之前学习的XPath语法,来快速定位特定元素以及节点信息。
可通过 pip 安装:
pip install lxml -i http://pypi.douban.com/simple/ --trusted-host pypi.douban.com
2.1 基本使用
我们可以利用它来解析HTML 代码,且在解析 HTML 代码的时候,如果 HTML 代码不规范,他会自动进行补全。
from lxml.html import etree

htmlText = '''

<div>

    <ul>

        <li class="item-0"><a href="link1.html">first item</a></li>

        <li class="item-1"><a href="link2.html">second item</a></li>

        <li class="item-inactive"><a href="link3.html">third item</a></li>

        <li class="item-1"><a href="link4.html">fourth item</a></li>

        <li class="item-0"><a href="link5.html">fifth item</a></li>

    </ul>

</div>

'''

# 利用 etree.HTML,将字符串解析为 HTML 文档

html = etree.HTML(htmlText)

# 按字符串序列化 HTML 文档

result = etree.tostring(html, encoding='utf-8', pretty_print=True).decode('utf-8')

print(result)
2.2 在文件中读取html代码
除了直接使用字符串进行解析,lxml 还支持从文件中读取内容。
html代码:
<!DOCTYPE html>

<html lang="zh-CN">

<head>

    <meta charset="utf-8">

    <title></title>

</head>

<body>

    <div>

    <ul>

        <li class="item-0"><a href="link1.html">first item</a></li>

        <li class="item-1"><a href="link2.html">second item</a></li>

        <li class="item-inactive"><a href="link3.html">third item</a></li>

        <li class="item-1"><a href="link4.html">fourth item</a></li>

        <li class="item-0"><a href="link5.html">fifth item</a></li>

    </ul>

</div>

</body>

</html>
然后利用etree.parse()方法来读取文件。
from lxml.html import etree

html = etree.parse('./hello.html')

result = etree.tostring(html, encoding='utf-8', pretty_print=True).decode('utf-8')

print(result)
结果:

我们看到居然报错了,为什么呢?
之所以使用etree.parse()方法解析 html 内容时,会报lxml.etree.XMLSyntaxError的错,是因为etree.parse()默认使用的是XML的解析器,所以当html内容不规范,比如出现某个标签缺少闭合标签时,就会报这个错误。这时,可使用etree.HTMLParser()创建一个HTML的解析器,然后作为etree.parse()方法的参数即可。
from lxml.html import etree

htmlParser = etree.HTMLParser(encoding='utf-8')

html = etree.parse('./hello.html', parser=htmlParser)

result = etree.tostring(html, encoding='utf-8', pretty_print=True).decode('utf-8')

print(result)
2.3 在lxml中使用XPath语法
使用XPath语法,应该使用Element.xpath语法,来执行XPath的选择。
xpath函数返回的永远是一个列表。
我们先来匹配下li标签和a标签
from lxml.html import etree

htmlParser = etree.HTMLParser(encoding='utf-8')

html = etree.parse('./hello.html', parser=htmlParser)

lis = html.xpath('//li')

for li in lis:

    print(etree.tostring(li, encoding='utf-8', pretty_print=True).decode('utf-8'), end='')

aList = html.xpath('//a/@href')

for a in aList:

    print(a)

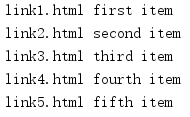
获得li标签下a标签的href属性和内容:
from lxml.html import etree

htmlParser = etree.HTMLParser(encoding='utf-8')

html = etree.parse('./hello.html', parser=htmlParser)

lis = html.xpath('//li')

for li in lis:

    # . 号表示在当前的 li 元素下去匹配

    href = li.xpath('.//a/@href')[0]   #获取 a 标签的 href 属性

    txt = li.xpath('.//a/text()')[0]   #获取 a 标签的文本

    print(href, txt)
爬虫(六):XPath、lxml模块的更多相关文章
- 洗礼灵魂,修炼python(71)--爬虫篇—【转载】xpath/lxml模块,爬虫精髓讲解
Xpath,lxml模块用法 转载的原因和前面的一样,我写的没别人写的好,所以我也不浪费时间了,直接转载这位崔庆才大佬的 原帖链接:传送门 以下为转载内容: --------------------- ...
- Python爬虫基础——XPath语法的学习与lxml模块的使用
XPath与正则都是用于数据的提取,二者的区别是: 正则:功能相对强大,写起来相对复杂: XPath:语法简单,可以满足绝大部分的需求: 所以,如果你可以根据自己的需要进行选择. 一.首先,我们需要为 ...
- Python爬虫 XPath语法和lxml模块
XPath语法和lxml模块 什么是XPath? xpath(XML Path Language)是一门在XML和HTML文档中查找信息的语言,可用来在XML和HTML文档中对元素和属性进行遍历. X ...
- lxml模块(应用xpath技术)
一.lxml介绍 第三方库lxml是第一款表现出高性能特征的python xml库,天生支持Xpath1.0.XSLT1.0.定制元素类,甚至python风格的数据绑定接口.lxml是通过Cpytho ...
- python爬虫网页解析之lxml模块
08.06自我总结 python爬虫网页解析之lxml模块 一.模块的安装 windows系统下的安装: 方法一:pip3 install lxml 方法二:下载对应系统版本的wheel文件:http ...
- XPath语法和lxml模块
XPath语法和lxml模块 什么是XPath? xpath(XML Path Language)是一门在XML和HTML文档中查找信息的语言,可用来在XML和HTML文档中对元素和属性进行遍历. X ...
- 爬虫学习笔记(六)PyQuery模块
PyQuery模块也是一个解析html的一个模块,它和Beautiful Soup用起来差不多,它是jquery实现的,和jquery语法差不多,会用jquery的人用起来就比较方便了. Pyquer ...
- python3爬虫lxml模块的安装
1:在下载lxml之前,要先查看python的版本信息, 在CMD命令行输入python 再输入import pip; print(pip.pep425tags.get_supported()) -- ...
- 【爬虫入门手记03】爬虫解析利器beautifulSoup模块的基本应用
[爬虫入门手记03]爬虫解析利器beautifulSoup模块的基本应用 1.引言 网络爬虫最终的目的就是过滤选取网络信息,因此最重要的就是解析器了,其性能的优劣直接决定这网络爬虫的速度和效率.Bea ...
随机推荐
- springboot+swagger接口文档企业实践(下)
目录 1.引言 2. swagger接口过滤 2.1 按包过滤(package) 2.2 按类注解过滤 2.3 按方法注解过滤 2.4 按分组过滤 2.4.1 定义注解ApiVersion 2.4.2 ...
- 2sql
------------------------------------ 高级查询-- as 起别名select name as 名字 from studnets;-- 消除重复的行 -- 查看有哪几 ...
- 2019牛客暑期多校训练营(第九场) E All men are brothers
传送门 知识点:并查集+组合数学 并查集合并操作可以理解为使得两个集合的人互相成为朋友,也就是两个集合并在了一起,答案是要求从所有人中挑出四个互相不是朋友的四个人,比较基础的组合数学知识,但因为每个集 ...
- cesium定义线面
面: var polygon = viewer.entities.add({ polygon : { hierarchy : { positions : null, holes : [{ positi ...
- MySQL5.7.18自动化安装脚本
背景 很好的朋友邱启明同学,擅长MySQL,目前任职某大型互联网业MySQL DBA,要来一套MySQL自动安装的Shell脚本,贴出来保存一些. 此版本为 MySQL 5.7.18 ###### 自 ...
- APM环境搭建
权限设置 把用户添加到用户组 “dialout”(如果这步没做,会导致很多用户权限问题): sudo usermod -a -G dialout $USER 然后注销后,重新登录,因为重新登录后所 ...
- shell一键部署nginx+tomcat
1.首先拉取环境 tomcat需要用到jdk环境 提前准备好nginx源码包,放于指定目录下 vim test.sh #!/bin/bash yum -y install gcc gcc-c++ z ...
- ios 10 更新 新体验
1.使用手机登录开发者网站https://developer.apple.com/download/ 2.下载描述文件 3.安装描述文件,按照提示步骤操作 4.更新ios系统 下面的方法是连接电脑直接 ...
- iOS 弹窗alertView使用详解
转自:http://blog.it985.com/4321.html alertView是iOS自带的弹窗通知框,我们来看下默认样式的效果图 下面直接上代码 1 2 3 4 5 - (void)del ...
- HDU-3339 IN ACTION(Dijkstra +01背包)
Since 1945, when the first nuclear bomb was exploded by the Manhattan Project team in the US, the ...