
大数据笔记(二十)——NoSQL数据库之MemCached
一、为什么要把数据存入内存?
1、原因:快
2、常见的内存数据库
(*)MemCached:看成Redis的前身,严格来说Memcached的不能叫数据库,原因:不支持持久化
(*)Redis:内存数据库,持久化(RDB、AOF)
(*)Oracle TimesTen
(*)SAP HANA
二、MemCached缓存技术
1、基本原理和体系结构
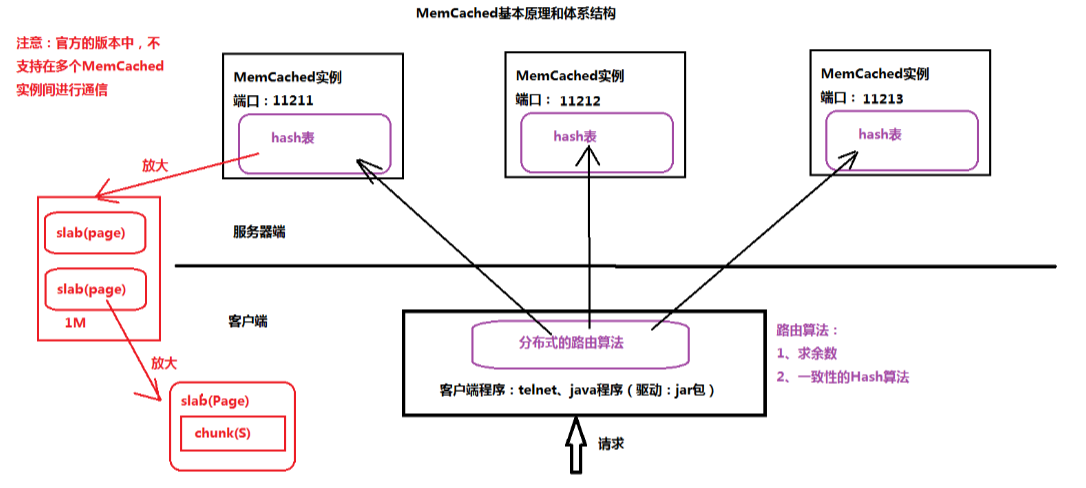
(*) 就是在内存中,维护一张巨大的Hash表
(*) MemCached通过一个路由算法(由客户端决定),来决定数据保存到哪一个节点上
2、安装和配置
(*) 前提1:安装gcc的编译器
(*) 前提2:安装libevent
(1) 确定、删除自带的libevent
rpm -qa|grep libevent =-==> 确定是否已有
rpm -e libevent-2.0.21-4.el7.x86_64 --nodeps (不要删除相关的依赖)
(2) tar -zxvf libevent-2.0.21-stable.tar.gz
(3) 安装到: /root/training/libevent
./configure --prefix=/root/training/libevent
make
make install
(*) 安装MemCached: 官方的版本:memcached-1.4.25.tar.gz
tar -zxvf memcached-1.4.25.tar.gz
安装目录:/root/training/memcached
配置:./configure --prefix=/root/training/memcached --with-libevent=/root/training/libevent
make
make install
(*) 启动:./memcached -u root -d -m 128 -p 11211
./memcached -u root -d -m 128 -p 11212
./memcached -u root -d -m 128 -p 11213(training/me../bin目录)
3、操作MemCached
(1)命令行:telnet (如果mnt下面没有东西,则重新挂载一下光盘)
(*) 安装telnet:rpm -ivh telnet-0.17-64.el7.x86_64.rpm
(*) telnet 127.0.0.1 11211
(*) 插入数据: add/set
set: 如果key已经存在,会替换原来的值
add: 如果key已经存在,返回信息(错误): NOT_STROED
举例:add key1 0 0 4
key1: key-value的键
第一个0:标志位
第二个0:数据过期的时间,0表示永远不过期
4表示:数据的长度
统计信息的命令:
stats
stats items
stats slabs
(2)JAVA API
4、MemCached路由算法
由客户端来决定
(1)求余数路由算法
缺点:如果需要扩容或者有宕机的情况,会造成数据的丢失。
举例: 扩容
3台MemCached ----> 4台MemCached
key
1 1 1
2 2 2
3 0 3
4 1 0
5 2 1
6 0 2
7 1 3
8 2 0
9 0 1
10 1 2
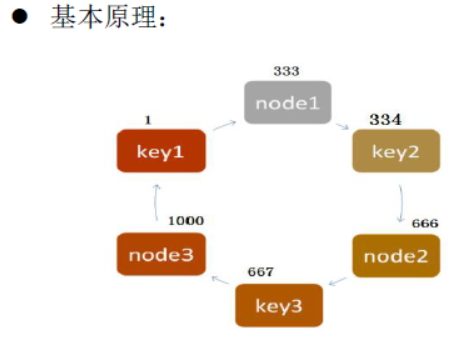
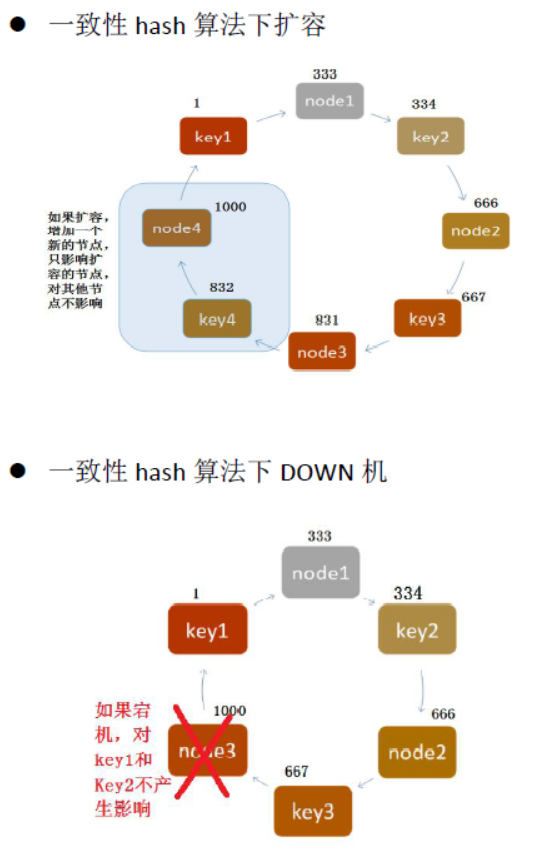
(2)一致性的hash算法
5、MemCached主主复制功能(双机热备)
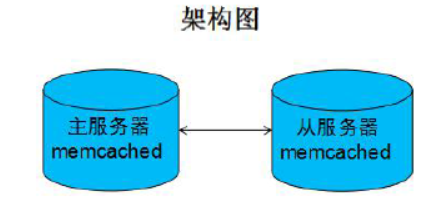
(1)不能使用官方的版本
一个日本的工程师改写了官方的版本,支持主主复制功能
memcached-1.2.8-repcached-2.2.tar.gz
(2)准备两台:bigdata11 bigdata12
(*) tar -zxvf memcached-1.2.8-repcached-2.2.tar.gz
(*) ./configure --prefix=/root/training/memcached_replication --with-libevent=/root/training/libevent --enable-replication
make
错误:error: ‘IOV_MAX’ undeclared (first use in this function)
vi memcached.c
55 /* FreeBSD 4.x doesn't have IOV_MAX exposed. */
56 #ifndef IOV_MAX
57 //#if defined(__FreeBSD__) || defined(__APPLE__)
58 # define IOV_MAX 1024
59 //#endif
60 #endif
make install
(3) 启动:需要指定对端的Memcached地址: -x参数
bigdata11: ./memcached -d -u root -m 128 -x bigdata12(/root/training/memcached_replication/bin)
bigdata12: ./memcached -d -u root -m 128 -x bigdata11
错误:
./memcached: error while loading shared libraries: libevent-2.0.so.5: cannot open shared object file:
No such file or directory
判断:命令memcached依赖的库有哪些?
ldd memcached
linux-vdso.so.1 => (0x00007ffee936b000)
libevent-2.0.so.5 => not found
libc.so.6 => /lib64/libc.so.6 (0x00007fc26923e000)
/lib64/ld-linux-x86-64.so.2 (0x00005579c379b000)
创建一个连接,让系统的libevent-2.0.so.5 指向我们自己的libevent-2.0.so.5
(64位系统) ln -s /root/training/libevent/lib/libevent-2.0.so.5 /usr/lib64/libevent-2.0.so.5
(32位系统) ln -s /root/training/libevent/lib/libevent-2.0.so.5 /usr/lib/libevent-2.0.so.5
telnet退出: ctrl + ]
如果没有telnet 重新挂载一下光盘: mount /dev/cdrom /mnt,去Package目录下执行:rpm -ivh telnet-0.17-64.el7.x86_64.rpm
大数据笔记(二十)——NoSQL数据库之MemCached的更多相关文章
- 大数据笔记(十二)——使用MRUnit进行单元测试
package demo.wc; import java.util.ArrayList; import java.util.List; import org.apache.hadoop.io.IntW ...
- 大数据笔记(十五)——Hive的体系结构与安装配置、数据模型
一.常见的数据分析引擎 Hive:Hive是一个翻译器,一个基于Hadoop之上的数据仓库,把SQL语句翻译成一个 MapReduce程序.可以看成是Hive到MapReduce的映射器. Hive ...
- 大数据笔记(十)——Shuffle与MapReduce编程案例(A)
一.什么是Shuffle yarn-site.xml文件配置的时候有这个参数:yarn.nodemanage.aux-services:mapreduce_shuffle 因为mapreduce程序运 ...
- 大数据笔记(十九)——数据采集引擎Sqoop和Flume安装测试详解
一.Sqoop数据采集引擎 采集关系型数据库中的数据 用在离线计算的应用中 强调:批量 (1)数据交换引擎: RDBMS <---> Sqoop <---> HDFS.HBas ...
- 大数据笔记(十八)——Pig的自定义函数
Pig的自定义函数有三种: 1.自定义过滤函数:相当于where条件 2.自定义运算函数: 3.自定义加载函数:使用load语句加载数据,生成一个bag 默认:一行解析成一个Tuple 需要MR的ja ...
- 大数据笔记(十六)——Hive的客户端及自定义函数
一.Hive的Java客户端 JDBC工具类:JDBCUtils.java package demo.jdbc; import java.sql.DriverManager; import java. ...
- 大数据笔记(十四)——HBase的过滤器与Mapreduce
一. HBase过滤器 1.列值过滤器 2.列名前缀过滤器 3.多个列名前缀过滤器 4.行键过滤器5.组合过滤器 package demo; import javax.swing.RowFilter; ...
- python3.4学习笔记(二十四) Python pycharm window安装redis MySQL-python相关方法
python3.4学习笔记(二十四) Python pycharm window安装redis MySQL-python相关方法window安装redis,下载Redis的压缩包https://git ...
- Linux实战教学笔记44:NoSQL数据库开篇之应用指南
第1章 NoSQL数据库 1.1 NoSQL概述 自关系型数据库诞生40年以来,从理论产生发展到现实产品,例如:大家最常见的MySQL和Oracle,逐渐在数据库领域里上升到了霸主地位,形成每年高达数 ...
- 大数据量高并发的数据库优化详解(MSSQL)
转载自:http://www.jb51.net/article/71041.htm 如果不能设计一个合理的数据库模型,不仅会增加客户端和服务器段程序的编程和维护的难度,而且将会影响系统实际运行的性能. ...
随机推荐
- Java数据结构之单向环形链表(解决Josephu约瑟夫环问题)
1.Josephu(约瑟夫.约瑟夫环)问题: 设编号为1,2,… n的n个人围坐一圈,约定编号为k(1<=k<=n)的人从1开始报数,数到m 的那个人出列,它的下一位又从1开始报数,数到m ...
- tensorflow学习笔记六----------神经网络
使用mnist数据集进行神经网络的构建 import numpy as np import tensorflow as tf import matplotlib.pyplot as plt from ...
- django字段类型(Field types)介绍
字段类型(Field types) AutoField 它是一个根据 ID 自增长的 IntegerField 字段.通常,你不必直接使用该字段.如果你没在别的字段上指定主 键,Django 就会自动 ...
- 关于原型链,原来这么简单?—————终结__proto__和prototype的那些事
今天,一个技术群里小朋友提出一个问题: Object.prototype.a = function () { console.log('a') } Function.prototype.b = fun ...
- 富文本编辑器Ueditor
一.大概使用: 官网:http://ueditor.baidu.com/website/download.html 使用:[参考index.html] 3.1 引入ueditor的js <scr ...
- makeinfo - 翻译 Texinfo 文档
SYNOPSIS 总览 makeinfo [OPTION]... TEXINFO-FILE... DESCRIPTION 描述 将 Texinfo 源文档翻译为各种其他格式,默认是可以用 Emacs ...
- python set 集合操作
转自:https://www.cnblogs.com/alex3714/articles/5740985.html s = set([3,5,9,10]) #创建一个数值集合 t = set(&quo ...
- js赋值后 改变现有数据会修改原来的数据
看代码: let obj1 = { name: '张三', age: , sex: '男' } let obj2 = obj1 console.log('obj2:', obj2) obj2.age ...
- noip级别模板小复习
不是很noip的知识点就不写了. dij什么的太easy就不写了. 缩点 注意\(Tarjan\)在缩边双和求强联通分量时候的区别. 一个要判断是否在栈内一个不要. 最后\(topsort\)来\(d ...
- MySQL常见的三种存储引擎
原文链接:https://www.cnblogs.com/yuxiuyan/p/6511837.html 简单来说,存储引擎就是指表的类型以及表在计算机上的存储方式. 存储引擎的概念是MySQL的特点 ...