
spark复习笔记(3):使用spark实现单词统计
wordcount是spark入门级的demo,不难但是很有趣。接下来我用命令行、scala、Java和python这三种语言来实现单词统计。
一、使用命令行实现单词的统计
1.首先touch一个a.txt文本文件
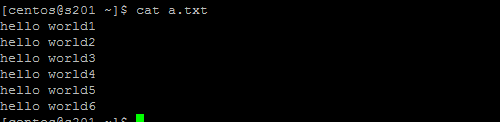
2.加载文本:产生弹性分布式数据集,用sc.textFile()加载文本文件到内存中去,加载到内存之后,整个RDD就是一个数组,就以换行符来做分隔
val rdd1 = sc.textFile("/home/centos/a.txt")

3.对2中产生的数组按空格进行切割,切开之后每个元素就变成了一个数组,[hello,world1]
val rdd2=rdd1.flatMap(line=>line.split(" "))

4.对3中产生的结果进行key,value键值对额转换
val rdd3=rdd2.map(wor=>(word,))

5.对4中的结果进行聚合
val rdd4=rdd3.reduceByKey(_ + _)

5.查看结果

6.一步操作

7.实现单词过滤

对于spark-shell这种环境一般只用于测试和调试
spark复习笔记(3):使用spark实现单词统计的更多相关文章
- Spark学习笔记2(spark所需环境配置
Spark学习笔记2 配置spark所需环境 1.首先先把本地的maven的压缩包解压到本地文件夹中,安装好本地的maven客户端程序,版本没有什么要求 不需要最新版的maven客户端. 解压完成之后 ...
- spark复习笔记(3)
在windows上实现wordcount单词统计 一.编写scala程序,引入spark类库,完成wordcount 1.sparkcontextAPI sparkcontext是spark功能的主要 ...
- spark复习笔记(2)
之前工作的时候经常用,隔了段时间,现在学校要用学的东西也忘了,翻翻书谢谢博客吧. 1.什么是spark? Spark是一种快速.通用.可扩展的大数据分析引擎,2009年诞生于加州大学伯克利分校AMPL ...
- spark复习笔记(7):sparkstreaming
一.介绍 1.sparkStreaming是核心模块Spark API的扩展,具有可伸缩,高吞吐量以及容错的实时数据流处理等.数据可以从许多来源(如Kafka,Flume,Kinesis或TCP套接字 ...
- spark复习笔记(7):sparkSQL
一.saprkSQL模块,使用类sql的方式访问Hadoop,实现mr计算,底层使用的是rdd 1.hive //hadoop mr sql 2.phenoix //hbase上构建sql的交互过 ...
- Spark学习笔记--Linux安装Spark集群详解
本文主要讲解如何在Linux环境下安装Spark集群,安装之前我们需要Linux已经安装了JDK和Scala,因为Spark集群依赖这些.下面就如何安装Spark进行讲解说明. 一.安装环境 操作系统 ...
- Spark学习笔记5:Spark集群架构
Spark的一大好处就是可以通过增加机器数量并使用集群模式运行,来扩展计算能力.Spark可以在各种各样的集群管理器(Hadoop YARN , Apache Mesos , 还有Spark自带的独立 ...
- Spark学习笔记1:Spark概览
Spark是一个用来实现快速而通用的集群计算的平台. Spark项目包含多个紧密集成的组件.Spark的核心是一个对由很多计算任务组成的,运行在多个工作机器或者是一个计算集群上的应用进行调度,分发以及 ...
- spark复习笔记(1)
使用spark实现work count ---------------------------------------------------- (1)用sc.textFile(" &quo ...
随机推荐
- 【leetcode】1108. Defanging an IP Address
题目如下: Given a valid (IPv4) IP address, return a defanged version of that IP address. A defanged IP a ...
- python frozenset集合(17)
在前一篇文章中我们对 python set集合 做了详细的讲解,而本文讲解的 frozenset集合 其实和set集合类似!区别在于frozenset集合不能修改/添加/删除,其他功能和set集合一样 ...
- 【bzoj3162】独钓寒江雪
*题目描述: *题解: 树哈希+组合数学.对于树的形态相同的子树就一起考虑. *代码: #include <cstdio> #include <cstring> #includ ...
- 01-pandas基础-Series与DataFrame
一.Series: 1,介绍:Series是以中类似于一维数组的对象,由一维数组以及与之相关的标签组成 特点:索引在左边,值在右边.在创建时,若我们未给数据指定索引,Series会自动创建一个0到N- ...
- Packet Transactions: High-level Programming for Line-Rate Switches
Name of article:Packet Transactions: High-level Programming for Line-Rate Switches Origin of the art ...
- [CSP-S模拟测试]:d(贪心+树状数组)
题目传送门(内部题65) 输入格式 第一行,一个自然数$T$,代表数据组数.对于每组数据:第一行,一个正整数$n$,一个自然数$m$.接下来$n$行,每行两个正整数,$a_i,b_i$. 输出格式 对 ...
- sql分别用日期、月、年 分组 group by 分组,datepart函数
标签: datepart函数sql分别用日期月年 分组group by 分组 2013-12-26 15:31 20764人阅读 评论(1) 收藏 举报 分类: SQL Server(21) 版权声明 ...
- 常见的七种Hadoop和Spark项目案例
常见的七种Hadoop和Spark项目案例 有一句古老的格言是这样说的,如果你向某人提供你的全部支持和金融支持去做一些不同的和创新的事情,他们最终却会做别人正在做的事情.如比较火爆的Hadoop.Sp ...
- 顶级域名、一级域名、二级域名与IP
转自:https://blog.csdn.net/qq_38071429/article/details/80339091 域名:可分三级,一级域名,二级域名,三级域名.是由一串字符+域名后缀组成,我 ...
- C# 防火墙操作之特定程序
将特定程序加入防火墙组,与将特定端口加入防火墙流程类似.详情见“C# 防火墙操作之特定端口”.其主要代码为: /// <summary> /// 允许应用程序通过防火墙 /// </ ...