
spark复习笔记(2)
之前工作的时候经常用,隔了段时间,现在学校要用学的东西也忘了,翻翻书谢谢博客吧。
1.什么是spark?
Spark是一种快速、通用、可扩展的大数据分析引擎,2009年诞生于加州大学伯克利分校AMPLab,2010年开源,2013年6月成为Apache孵化项目,2014年2月成为Apache顶级项目。目前,Spark生态系统已经发展成为一个包含多个子项目的集合,其中包含SparkSQL、Spark Streaming、GraphX、MLlib等子项目,Spark是基于内存计算的大数据并行计算框架。Spark基于内存计算,提高了在大数据环境下数据处理的实时性,同时保证了高容错性和高可伸缩性,允许用户将Spark部署在大量廉价硬件之上,形成集群。Spark得到了众多大数据公司的支持,这些公司包括Hortonworks、IBM、Intel、Cloudera、MapR、Pivotal、百度、阿里、腾讯、京东、携程、优酷土豆。当前百度的Spark已应用于凤巢、大搜索、直达号、百度大数据等业务;阿里利用GraphX构建了大规模的图计算和图挖掘系统,实现了很多生产系统的推荐算法;腾讯Spark集群达到8000台的规模,是当前已知的世界上最大的Spark集群。
2为什么要学Spark
Spark是一个开源的类似于Hadoop MapReduce的通用的并行计算框架,Spark基于map reduce算法实现的分布式计算,拥有Hadoop MapReduce所具有的优点;但不同于MapReduce的是Spark中的Job中间输出和结果可以保存在内存中,从而不再需要读写HDFS,因此Spark能更好地适用于数据挖掘与机器学习等需要迭代的map reduce的算法。
Spark是MapReduce的替代方案,而且兼容HDFS、Hive,可融入Hadoop的生态系统,以弥补MapReduce的不足。
3 Spark特点
1) 快
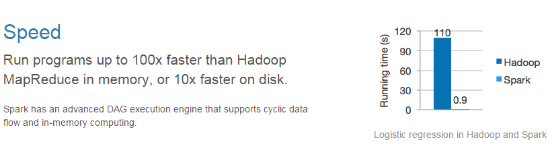
与Hadoop的MapReduce相比,Spark基于内存的运算要快100倍以上,基于硬盘的运算也要快10倍以上。Spark实现了高效的DAG执行引擎,可以通过基于内存来高效处理数据流。
2)易用
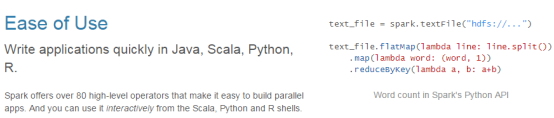
Spark支持Java、Python和Scala的API,还支持超过80种高级算法,使用户可以快速构建不同的应用。而且Spark支持交互式的Python和Scala的shell,可以非常方便地在这些shell中使用Spark集群来验证解决问题的方法。
3)通用
Spark提供了统一的解决方案。Spark可以用于批处理、交互式查询(Spark SQL)、实时流处理(Spark Streaming)、机器学习(Spark MLlib)和图计算(GraphX)。这些不同类型的处理都可以在同一个应用中无缝使用。Spark统一的解决方案非常具有吸引力,毕竟任何公司都想用统一的平台去处理遇到的问题,减少开发和维护的人力成本和部署平台的物力成本。
4)兼容性
Spark可以非常方便地与其他的开源产品进行融合。比如,Spark可以使用Hadoop的YARN和Apache Mesos作为它的资源管理和调度器,并且可以处理所有Hadoop支持的数据,包括HDFS、HBase和Cassandra等。这对于已经部署Hadoop集群的用户特别重要,因为不需要做任何数据迁移就可以使用Spark的强大处理能力。Spark也可以不依赖于第三方的资源管理和调度器,它实现了Standalone作为其内置的资源管理和调度框架,这样进一步降低了Spark的使用门槛,使得所有人都可以非常容易地部署和使用Spark。此外,Spark还提供了在EC2上部署Standalone的Spark集群的工具。

4.spark安装
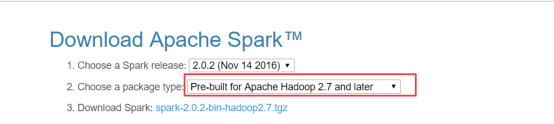
1)下载spark安装包
下载地址spark官网:http://spark.apache.org/downloads.html这里我们使用 spark-2.0.2-bin-hadoop2.7版本.
2)解压安装包
tar -zxvf spark-2.0.2-bin-hadoop2.7.tgz -C /soft
3)创建软连接
ln -s spark-2.0.2-bin-hadoop2.7.tgz spark
4)修改配置文件
(1)配置文件目录在/soft/spark/conf
nano spark-env.sh 修改文件(先把spark-env.sh.template重命名为spark-env.sh)
(2)配置spark环境变量
#指定spark老大Master的IP
export SPARK_MASTER_HOST=s201
#指定spark老大Master的端口
export SPARK_MASTER_PORT=7077
(2)nano slaves文件
先把slaves.template重命名为slaves
(3)将spark分发到其他主机
s201:8080
5)配置spark环境变量
export SPARK_HOME=/opt/bigdata/spark
export PATH=$PATH:$SPARK_HOME/bin
将spark添加到环境变量,添加以下内容到 /etc/profile
注意最后 source /etc/profile 刷新配置
6)启动spark集群
start-all.sh
7)停止spark集群
stop-all.sh
8)验证是否成功
5.体验spark
1)进入spark-shell
$>spark-shell
$scala>
2)API
(1)[SparkContext]
Spark程序的入口点,封装了整个spark程序的运行环境信息

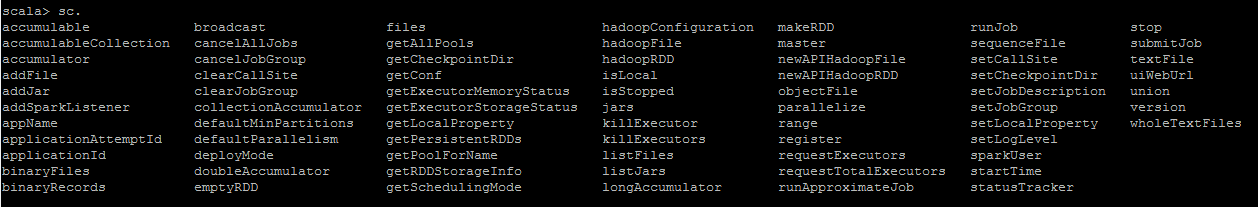
即sc:这是spark应用上下文即sparkContext对象,spark程序的的入口点,封装spark运行环境信息。通过sc.+Tab键可以得到如下方法
(2)RDD resilient distributed dataset 弹性分布式数据集,等价于集合。
3)通过spark实现word count
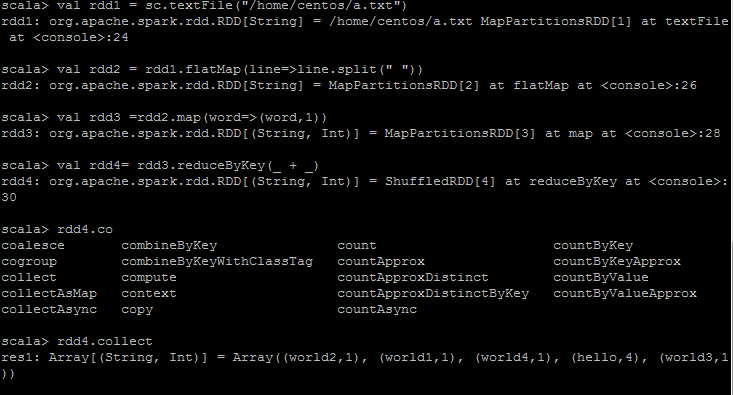
(1)加载文件:val rdd1 = sc.textFile("/home/centos/test.txt"),将文件加载进入内存中
sc.textFile:def 加载之后将其转换成数组 textFile(path:String,minPartitions:Int):org.apache.spark.rdd.RDD(String)
(2)按照空格进行切割。压扁操作
val rdd2 =rdd1.map(line=>line.split(" "))
就是对第一步集合进行处理,把没一行的元素进行切割,切开之后每个元素仍然是一个数组,现在切开之后就变成了数组的集合了。
(3)在进行单词统计的时候需要在后面标1,变成一个key-value键值对的形式
flatmap()函数只能是从集合元素到map的形式
val rdd3 = flatMap(line=>line.split(" "));//压扁操作
(4)map(word=>(word,1)) //变换成对偶(k,v),将单词变换成对偶,也就是映射
(5)聚合:reduceByKey(_ + _)
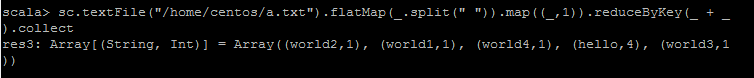
一句话写完spark
spark复习笔记(2)的更多相关文章
- spark复习笔记(1)
使用spark实现work count ---------------------------------------------------- (1)用sc.textFile(" &quo ...
- spark复习笔记(7):sparkstreaming
一.介绍 1.sparkStreaming是核心模块Spark API的扩展,具有可伸缩,高吞吐量以及容错的实时数据流处理等.数据可以从许多来源(如Kafka,Flume,Kinesis或TCP套接字 ...
- spark复习笔记(7):sparkSQL
一.saprkSQL模块,使用类sql的方式访问Hadoop,实现mr计算,底层使用的是rdd 1.hive //hadoop mr sql 2.phenoix //hbase上构建sql的交互过 ...
- spark复习笔记(6):RDD持久化
在spark中最重要的功能之一是跨操作在内存中持久化数据集.当你持久化一个RDD的时候,每个节点都存放了一个它在内存中计算的一个分区,并在该数据集的其他操作中进行重用,持久化一个RDD的时候,节点上的 ...
- spark复习笔记(6):数据倾斜
一.数据倾斜 spark数据倾斜,map阶段对key进行重新划分.大量的数据在经过hash计算之后,进入到相同的分区中,zao
- spark复习笔记(4):RDD变换
一.RDD变换 1.返回执行新的rdd的指针,在rdd之间创建依赖关系.每个rdd都有一个计算函数和指向父rdd的指针 Spark是惰性的,因此除非调用某个转换或动作,否则不会执行任何操作,否则将触发 ...
- spark复习笔记(5):API分析
0.spark是基于hadoop的mr模型,扩展了MR,高效实用MR模型,内存型集群计算,提高了app处理速度. 1.特点:(1)在内存中存储中间结果 (2)支持多种语言:java scala pyt ...
- spark复习笔记(4):spark脚本分析
1.[start-all.sh] #!/usr/bin/env bash # # Licensed to the Apache Software Foundation (ASF) under one ...
- spark复习笔记(3)
在windows上实现wordcount单词统计 一.编写scala程序,引入spark类库,完成wordcount 1.sparkcontextAPI sparkcontext是spark功能的主要 ...
- spark复习笔记(3):使用spark实现单词统计
wordcount是spark入门级的demo,不难但是很有趣.接下来我用命令行.scala.Java和python这三种语言来实现单词统计. 一.使用命令行实现单词的统计 1.首先touch一个a. ...
随机推荐
- 对postcss以及less和sass的研究
1.postcss PostCSS 的主要功能只有两个:第一个就是前面提到的把 CSS 解析成 JavaScript 可以操作的 抽象语法树结构(Abstract Syntax Tree,AST),第 ...
- Socket网络通信编程(二)
1.Netty初步 2.HelloWorld 3.Netty核心技术之(TCP拆包和粘包问题) 4.Netty核心技术之(编解码技术) 5.Netty的UDP实现 6.Netty的WebSocket实 ...
- CF704D Captain America
http://codeforces.com/problemset/problem/704/D 题解 对于两种颜色的染色,我们可以把它看做选择问题. 比如说红色的代价小,所以我们尽可能多的染红色. 然后 ...
- jsp页面a标签URL转码问题
简单的办法只有一句话,在后台对传过来的字符串(value)加一句: String value = new String(value.getBytes("ISO-8859-1"),& ...
- 文档流&文字&CSS常用命令
文档流 文档流就是文档内元素流动方向 流动方向 内联元素从左往右流,宽度不够,之字形,且元素会被截断 块元素从上往下流动,一排一排 注意事项 内联元素中有英文单词,流动时宽度不够,英文单词会整体迁移, ...
- HTML5和CSS3兼容清单
1.CSS3 2.CSS3选择器 3.HTML5 4.HTML5 From
- picker-view组件
picker-view组件,是一个页面上的滚动选择器: 如果想进行滚动:他的子元素必须是 picker-view-column 组件: picker-view-column组件:只是提供了一个可视 ...
- vue2.0 之 douban (一)框架搭建 及 整体布局
1.创建豆瓣项目 我们通过官方vue-cli初始化项目 vue init webpack douban 填写项目描述,作者,安装vue-router 初始化后,通过npm install安装依赖 cd ...
- PCIE手札
PCIE兼容了大部分PCI总线的特性,区别在于使用串行差分总线代替了并行总线,并实现了协议分层.PCIE的带宽与LANE数量和时钟频率相关,时钟频率支持2.5G和5G,Lane支持x1/x2/x4/x ...
- P3373线段树2
#include<bits/stdc++.h> using namespace std; typedef long long ll; ; ll sum[N<<],lazy1[N ...