
python爬虫--用xpath爬豆瓣电影
- 将目标网站下的页面抓取下来
- 将抓取下来的数据根据一定规则进行提取
- 将目标网站下的页面抓取下来
import requests
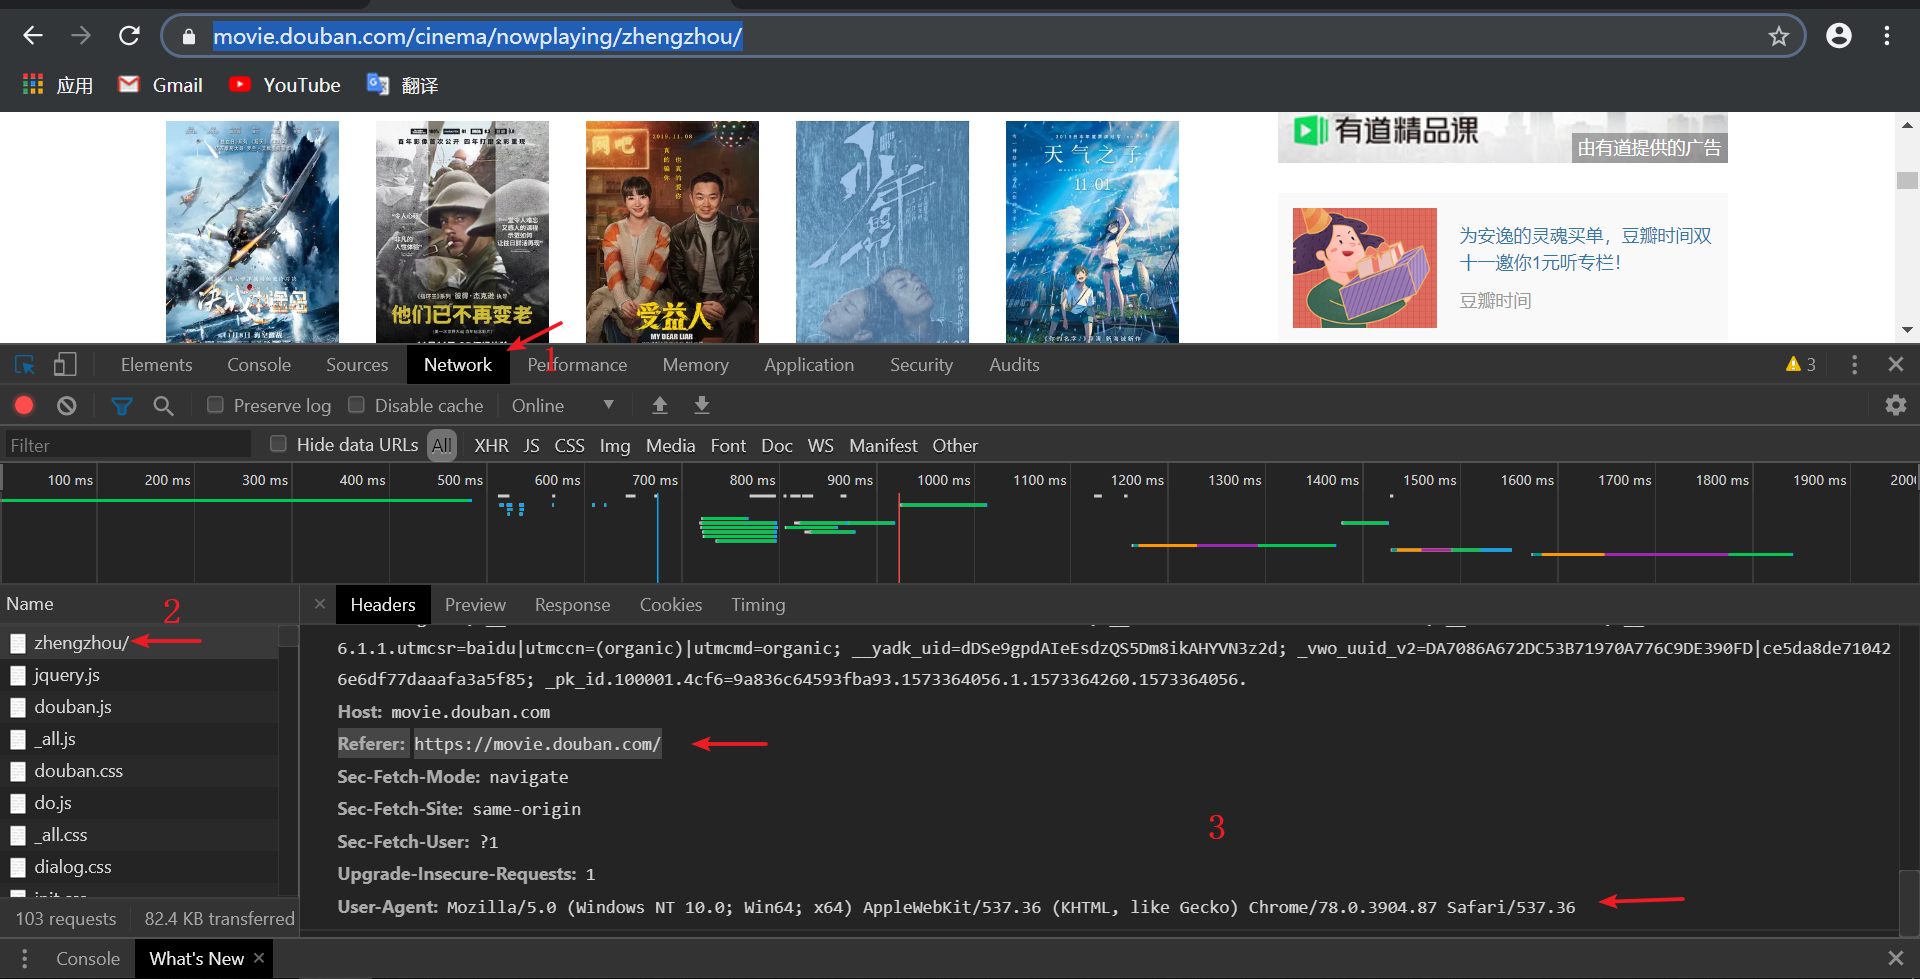
headers = {

    #请求身份/默认为User-Agent:python

	'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.87 Safari/537.36',

    'Referer': 'https://movie.douban.com/'

}
url = 'https://movie.douban.com/cinema/nowplaying/zhengzhou/'
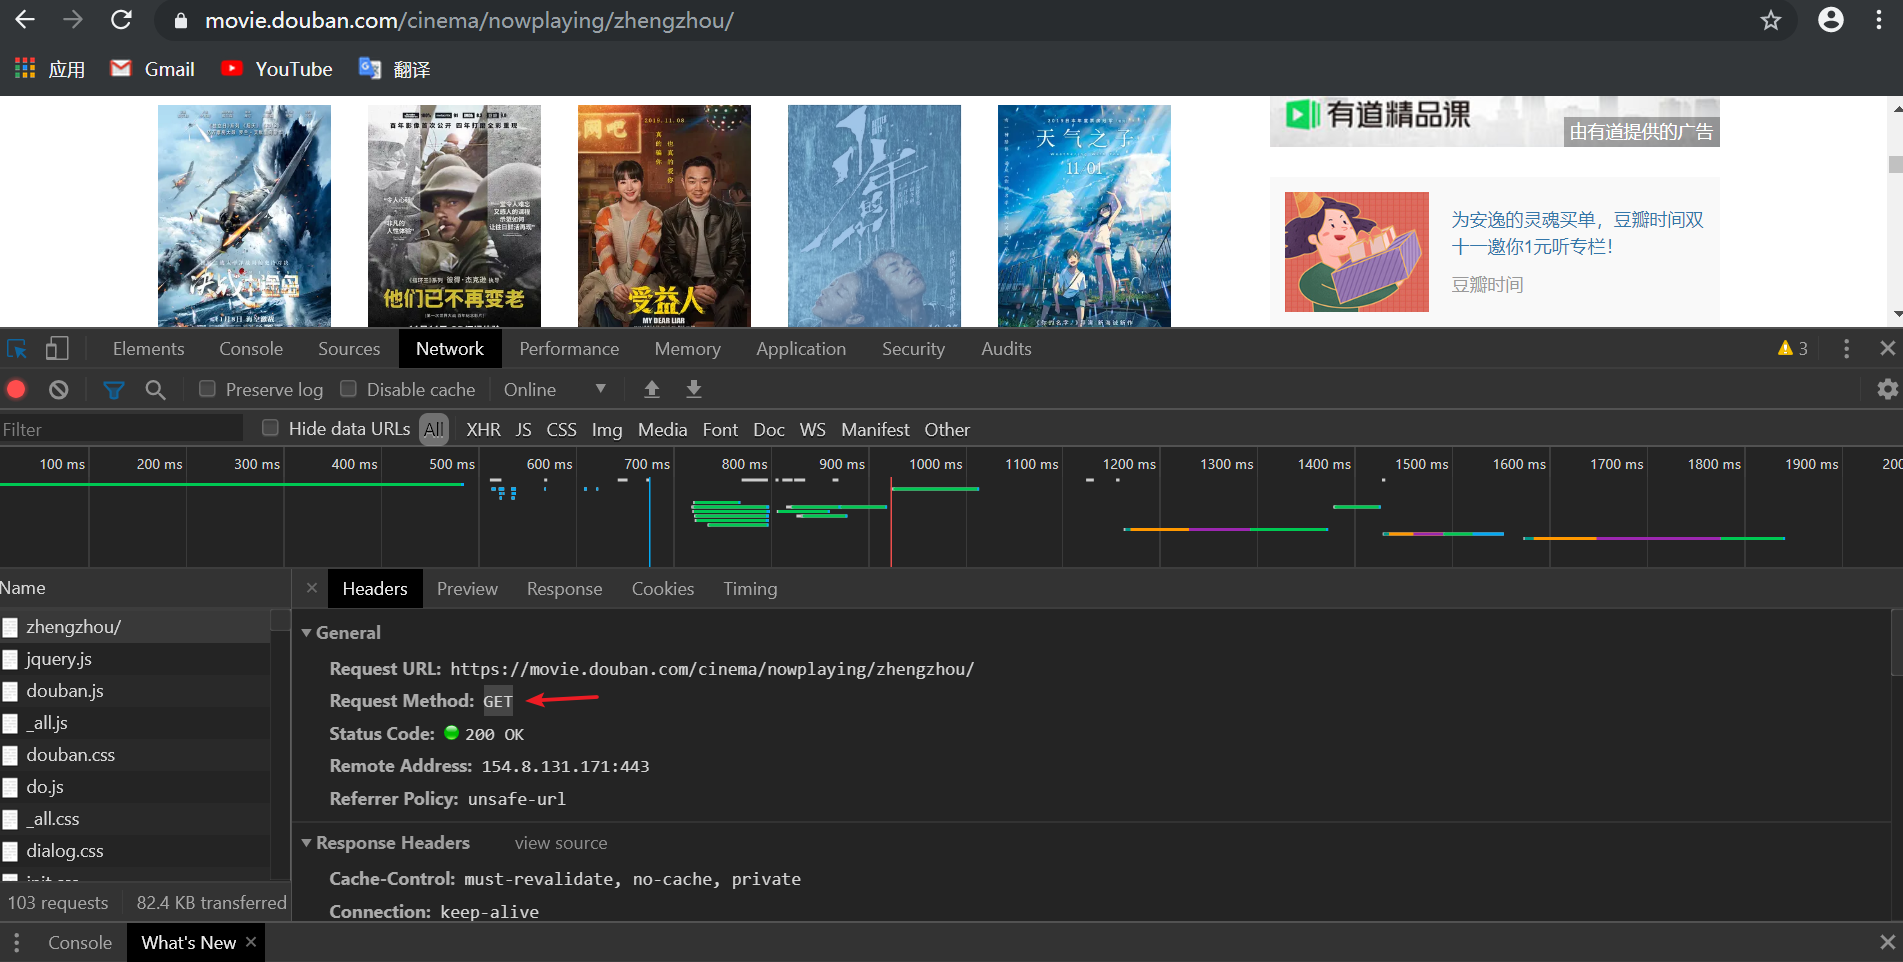
response = requests.get(url,headers=headers)  #响应

#print(response.text)

text = response.text
from lxml import etree

html = etree.HTML(text)

ul = html.xpath("//ul[@class='lists']")[0]

#print(etree.tostring(ul,encoding='utf-8').decode('utf-8'))

lis = ul.xpath('./li')

for li in lis:

    #print(etree.tostring(li,encoding='utf-8').decode('utf-8'))

    title = li.xpath('@data-title')[0]

    #print(title)

    score = li.xpath('@data-score')[0]

    # print(score)

    poster = li.xpath('.//img/@src')[0]

   # print(poster)
request.urlretrieve(poster, 'D:/A/' + score + title + '.jpg')
下载到D盘下A目录中,文件名为 评分+影名.jpg
2.显示进度条
fns_num = 1

num = len(lis)

for li in lis:

    ···

    print("\r完成进度: {:.2f}%".format(fns_num * 100 / num), end="")

    fns_num += 1
#coding=UTF-8

import requests

from lxml import etree

from urllib import request

headers = {

	'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.87 Safari/537.36',

	'Referer': 'https://movie.douban.com/'

}

url = 'https://movie.douban.com/cinema/nowplaying/zhengzhou/'

response = requests.get(url,headers=headers)

# print(response.text)

text = response.text

html = etree.HTML(text)

ul = html.xpath("//ul[@class='lists']")[0]

# print(etree.tostring(ul,encoding='utf-8').decode('utf-8'))

lis = ul.xpath("./li")

# movies = []

fns_num = 1

num = len(lis)

for li in lis:

    # print(etree.tostring(li,encoding='utf-8').decode('utf-8'))

    title = li.xpath('@data-title')[0]

    # print(title)

    score = li.xpath('@data-score')[0]

    # print(score)

    poster = li.xpath('.//img/@src')[0]

    # print(poster)

    request.urlretrieve(poster, 'D:/A/' + score + title + '.jpg')

    print("\r完成进度: {:.2f}%".format(fns_num * 100 / num), end="")

    fns_num += 1
python爬虫--用xpath爬豆瓣电影的更多相关文章
- 一个简单python爬虫的实现——爬取电影信息
最近在学习网络爬虫,完成了一个比较简单的python网络爬虫.首先为什么要用爬虫爬取信息呢,当然是因为要比人去收集更高效. 网络爬虫,可以理解为自动帮你在网络上收集数据的机器人. 网络爬虫简单可以大致 ...
- Python爬虫教程-17-ajax爬取实例(豆瓣电影)
Python爬虫教程-17-ajax爬取实例(豆瓣电影) ajax: 简单的说,就是一段js代码,通过这段代码,可以让页面发送异步的请求,或者向服务器发送一个东西,即和服务器进行交互 对于ajax: ...
- Python爬虫实例:爬取猫眼电影——破解字体反爬
字体反爬 字体反爬也就是自定义字体反爬,通过调用自定义的字体文件来渲染网页中的文字,而网页中的文字不再是文字,而是相应的字体编码,通过复制或者简单的采集是无法采集到编码后的文字内容的. 现在貌似不少网 ...
- Python爬虫实例:爬取豆瓣Top250
入门第一个爬虫一般都是爬这个,实在是太简单.用了 requests 和 bs4 库. 1.检查网页元素,提取所需要的信息并保存.这个用 bs4 就可以,前面的文章中已经有详细的用法阐述. 2.找到下一 ...
- python简单爬豆瓣电影排名
爬豆瓣电影 网站分析: 1 打开https://movie.douban.com,选择 [排行榜],然后随便选择一类型,我这里选择科幻 2 一直浏览网页,发现没有下一的标签,是下滑再加载的,可 ...
- 非常全的一份Python爬虫的Xpath博文
非常全的一份Python爬虫的Xpath博文 Xpath 是 python 爬虫过程中非常重要的一个用来定位的一种语法. 一.开始使用 首先我们需要得到一个 HTML 源代码,用来模拟爬取网页中的源代 ...
- Python爬虫实例:爬取B站《工作细胞》短评——异步加载信息的爬取
很多网页的信息都是通过异步加载的,本文就举例讨论下此类网页的抓取. <工作细胞>最近比较火,bilibili 上目前的短评已经有17000多条. 先看分析下页面 右边 li 标签中的就是短 ...
- python爬虫:XPath语法和使用示例
python爬虫:XPath语法和使用示例 XPath(XML Path Language)是一门在XML文档中查找信息的语言,可以用来在XML文档中对元素和属性进行遍历. 选取节点 XPath使用路 ...
- Python爬虫之xpath语法及案例使用
Python爬虫之xpath语法及案例使用 ---- 钢铁侠的知识库 2022.08.15 我们在写Python爬虫时,经常需要对网页提取信息,如果用传统正则表达去写会增加很多工作量,此时需要一种对数 ...
随机推荐
- python菜鸟教程学习4:基本数据类型
变量:python中的变量不需要声明,但在使用前都必须要赋值,变量赋值之后才会被创建 在python中变量是没有类型的,所有的数据类型是对内存中对象的类型. 赋值:使用等号=来给变量赋值 python ...
- centos 6系统下新磁盘分区(MBR格式)
添加新磁盘后,fdisk -l查看所有磁盘列表( fdisk只能分区2T以下磁盘,超过2T的用parted命令来进行GPT分区) 然后fdisk -cu /dev/sdb选择要分区的磁盘,按m显示菜单 ...
- PL/SQL Developer 13注册码(亲测可用)
product code: 4vkjwhfeh3ufnqnmpr9brvcuyujrx3n3le serial Number: 226959 password: xs374ca
- Unity CommandBuffer物体轮廓
1.command buffer具有很高的灵活性,它的作用是预定义一些渲染指令,然后在我们想要执行的时候去执行这些指令(见图1),绿点表示可以在"Forward Rendering Path ...
- php插入一百万测试数据(实例)
<?phpset_time_limit(0);function a(){ header("Content-Type:text/html;charset=utf-8"); $s ...
- 使用ABBYY FineReader 手动校正文档复杂结构
ABBYY FineReader 15(Windows系统)拥有强大的OCR识别功能,能对扫描仪或者数码相机等光学工具获取的图像进行识别,解析其中的文本.图像.表格.条形码等,方便用户进一步获取图像中 ...
- word教程字体和段落设置
放大/缩小字号:1.选中文字-点击"大A"或"小A" 2.同时摁着ctrl+shift+>/ctrl+shift+<即可 设置标题与正文间距:鼠标放 ...
- robot 如何定义用户关键字、变量
1.用户关键字,使用robot语法定义的关键字 2.系统关键字 自带的 3.资源文件,自己定义的关键字 4.变量 自己定义的关键字,需单独建一个资源文件 自己写的关键字,需写在***Keywords ...
- java中String类的使用
一.Strng类的概念 String类在我们开发中经常使用,在jdk1.8版本之前(包括1.8),String类的底层是一个char类型的数组,1.8版本之后是byte类型的数组,正是因为String ...
- 上位机学习技巧——c#(原创)
(一直更新.......) 一.扫描可用串口 二.捕获鼠标移到控件(上升沿)/离开控件(下降沿) 在窗体生成代码中,找到对应按钮(这里使用butten1)区域,在区域内添加两个事件,分别是: 鼠标移到 ...