
大数据并行计算框架Spark
Spark2.1. http://dblab.xmu.edu.cn/blog/1689-2/
0+入门:Spark的安装和使用(Python版)
Spark2.1.0+入门:第一个Spark应用程序:WordCount(Python版)
http://dblab.xmu.edu.cn/blog/1692-2/#more-1692
应用:
启动
cd /usr/local/spark

./bin/pyspark
RDD
分布式对象集合,一个只读的分区记录集合。一种数据结构(相当于int、double等)
1.RDD创建
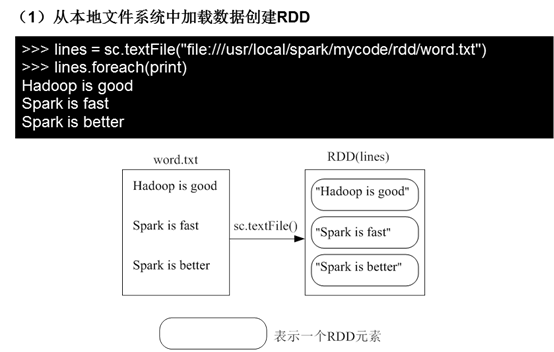
(1)从本地文件系统中加载数据创建RDD
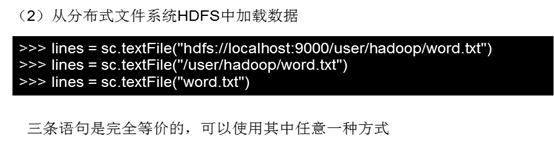
(2)从分布式文件系统HDFS中加载数据
(3)从其他RDD创建。
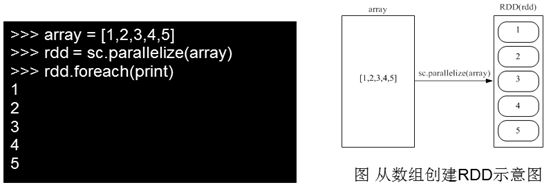
parallelize:https://blog.csdn.net/wyqwilliam/article/details/84330408
2.RDD操作
Spark API :https://www.csdn.net/gather_26/MtTaYg4sNDQ5MC1ibG9n.html
2.1转换操作
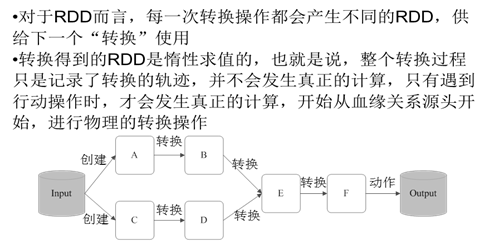

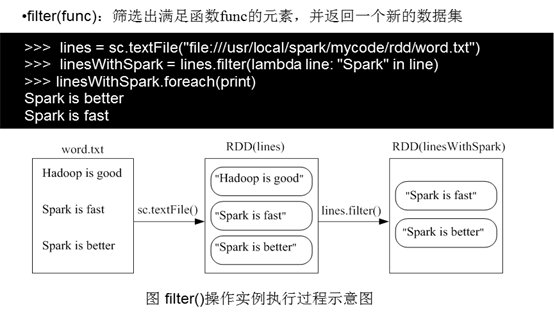
1)fileter(func)
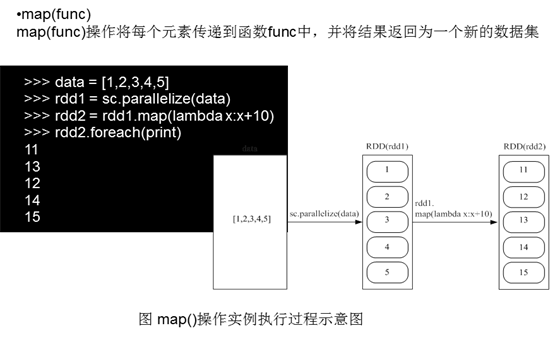
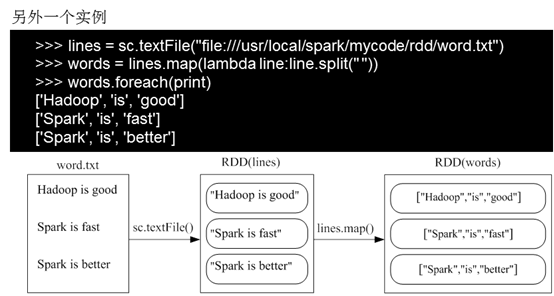
2)map(func)
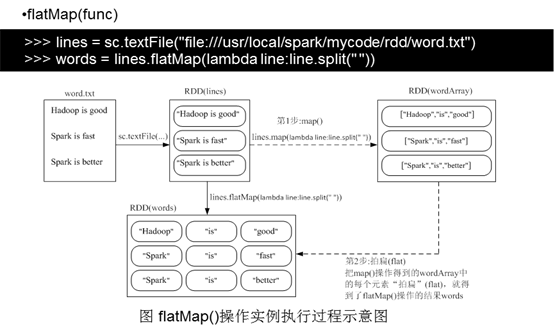
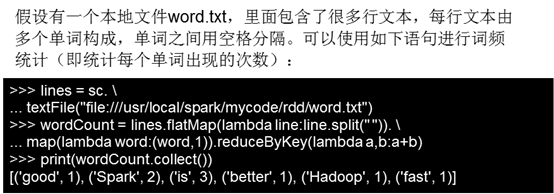
3)flatMap(func)
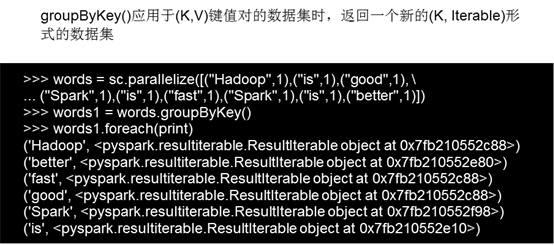
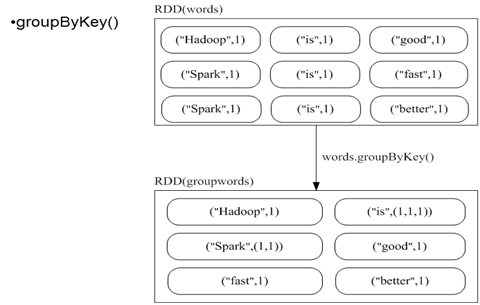
4)groupByKey()
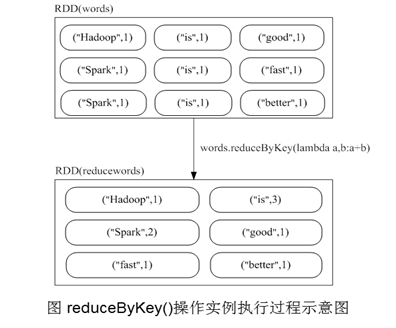
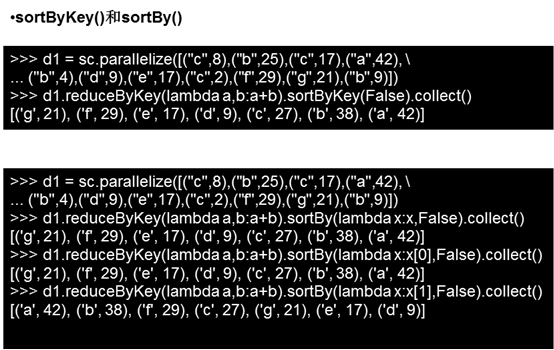
5)reduceBykey(func)

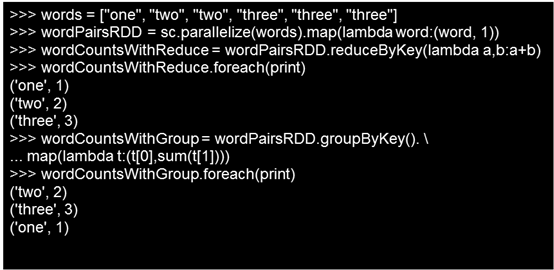
groupByKey也是对每个key进行操作,但只生成一个sequence,groupByKey本身不能自定义函数,需要先用groupByKey生成RDD,然后才能对此RDD通过map进行自定义函数操作
reduceByKey用于对每个key对应的多个value进行merge操作,最重要的是它能够在本地先进行merge操作,并且merge操作可以通过函数自定义
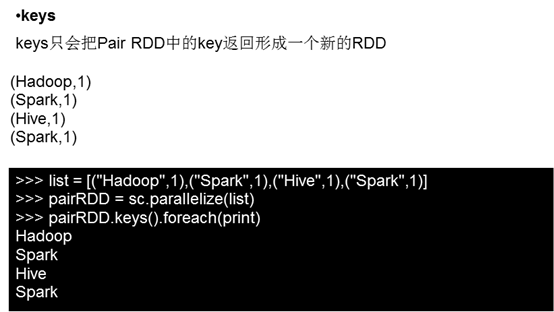
6)keys()
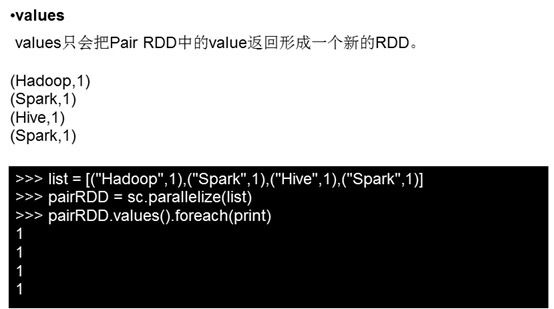
7)values()
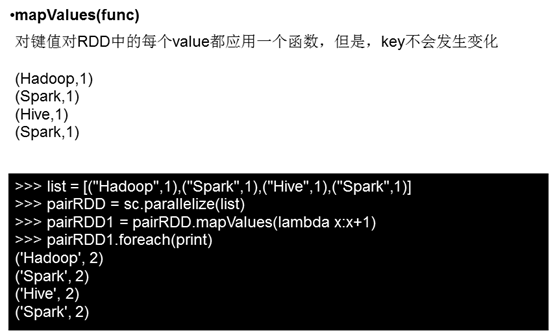
8)mapValues(func)
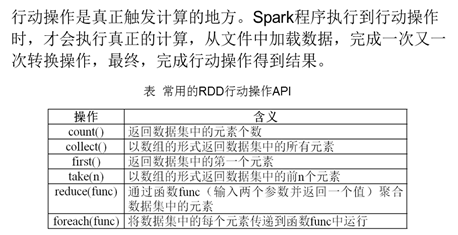
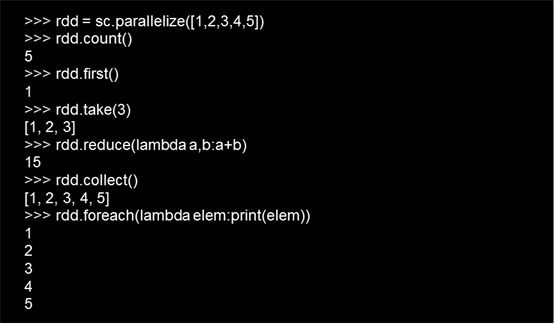
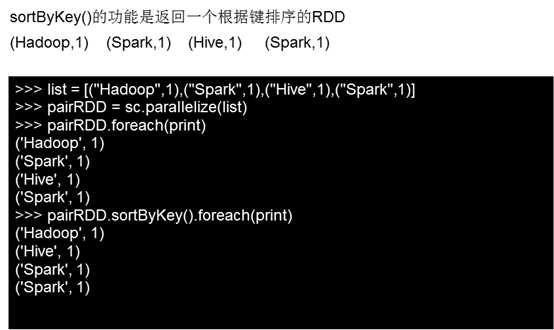
4.2行动操作

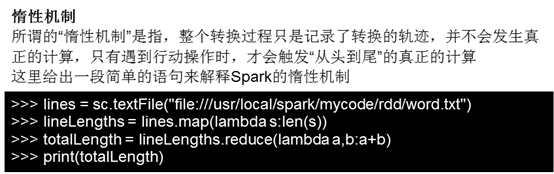
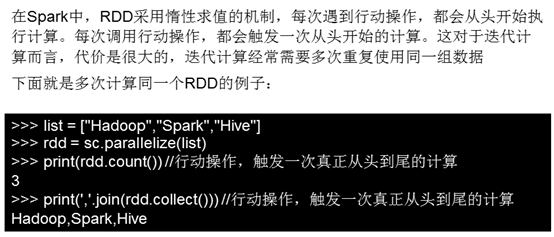
4.3惰性机制
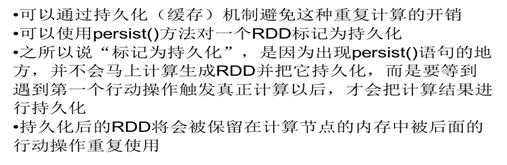
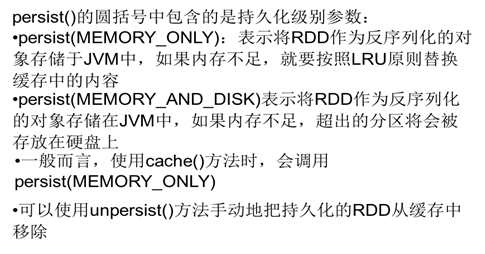
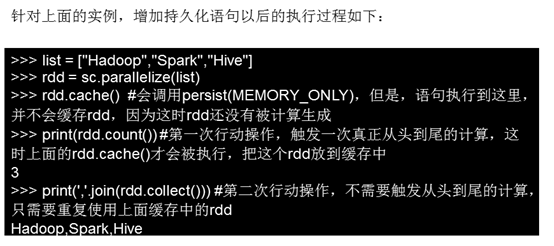
持久化
分区

练习:
1给定一组键值对("spark",2),("hadoop",6),("hadoop",4),("spark",6),键值对的key表示图书名称,value表示某天图书销量,请计算每个键对应的平均值,也就是计算每种图书的每天平均销量。
2 有两个文件,file1.txt,file2.txt,字段含义如下orderid,userid,payment,productid。求top 5个payment值。
file1.txt
1,1768,50,155

2,1218, 600,211

3,2239,788,242

4,3101,28,599

5,4899,290,129

6,3110,54,1201

7,4436,259,877

8,2369,7890,27
file2.txt
100,4287,226,233

101,6562,489,124

102,1124,33,17

103,3267,159,179

104,4569,57,125

105,1438,37,116
大数据并行计算框架Spark的更多相关文章
- Spark 介绍(基于内存计算的大数据并行计算框架)
Spark 介绍(基于内存计算的大数据并行计算框架) Hadoop与Spark 行业广泛使用Hadoop来分析他们的数据集.原因是Hadoop框架基于一个简单的编程模型(MapReduce),它支持 ...
- 大数据实时处理-基于Spark的大数据实时处理及应用技术培训
随着互联网.移动互联网和物联网的发展,我们已经切实地迎来了一个大数据 的时代.大数据是指无法在一定时间内用常规软件工具对其内容进行抓取.管理和处理的数据集合,对大数据的分析已经成为一个非常重要且紧迫的 ...
- 大数据计算框架Hadoop, Spark和MPI
转自:https://www.cnblogs.com/reed/p/7730338.html 今天做题,其中一道是 请简要描述一下Hadoop, Spark, MPI三种计算框架的特点以及分别适用于什 ...
- 大数据计算新贵Spark在腾讯雅虎优酷成功应用解析
http://www.csdn.net/article/2014-06-05/2820089 摘要:MapReduce在实时查询和迭代计算上仍有较大的不足,目前,Spark由于其可伸缩.基于内存计算等 ...
- 成都大数据Hadoop与Spark技术培训班
成都大数据Hadoop与Spark技术培训班 中国信息化培训中心特推出了大数据技术架构及应用实战课程培训班,通过专业的大数据Hadoop与Spark技术架构体系与业界真实案例来全面提升大数据工程师 ...
- 网易大数据平台的Spark技术实践
网易大数据平台的Spark技术实践 作者 王健宗 网易的实时计算需求 对于大多数的大数据而言,实时性是其所应具备的重要属性,信息的到达和获取应满足实时性的要求,而信息的价值需在其到达那刻展现才能利益最 ...
- 大数据篇:Spark
大数据篇:Spark Spark是什么 Spark是一个快速(基于内存),通用,可扩展的计算引擎,采用Scala语言编写.2009年诞生于UC Berkeley(加州大学伯克利分校,CAL的AMP实验 ...
- [转帖]大数据hadoop与spark的区别
大数据hadoop与spark的区别 https://www.cnblogs.com/adnb34g/p/9233906.html Posted on 2018-06-27 14:43 左手中倒影 阅 ...
- 大数据体系概览Spark、Spark核心原理、架构原理、Spark特点
大数据体系概览Spark.Spark核心原理.架构原理.Spark特点 大数据体系概览(Spark的地位) 什么是Spark? Spark整体架构 Spark的特点 Spark核心原理 Spark架构 ...
随机推荐
- 意外发现PHP另一个显示转换类型 binary
竟然不知道除了(string)$a之外,还有(binary)$a知道unset可以不加括号,但不知道还有这种写法(unset) 请看lex文件(php-7.1.8) <ST_IN_SCRIPTI ...
- 模块 schedule 定时任务
schedule模块实现定时任务 2018-08-29 15:01:51 更多 一.官方示例 import schedule import time def job(): print("I' ...
- logstash用jdbc插件将数据库内容导入elasticsearch时间字段相差5小时
logstash将mysql的数据导入elasticsearch之后发现时间字段的相差5个小时 解决办法: 在数据库连接配置后面加上?serverTimezone=UCT这个就OK了 logstash ...
- HTML 基础(六)
一.脚本 JavaScript 是 HTML 页面具有更强的动态和交互性 <script> 标签 <script> 标签用于定义客户端脚本,<script> 元素既 ...
- Xmind pro Win10系统下安装问题解决与破解
Xmind pro Win10系统下安装问题解决与破解 1.下载安装版本 解压包含文件: xmind-8-update7-windows--安装包 和XMindCrack.jar--激活破解工具 2. ...
- NKOJ3777 卡牌操作
问题描述 有n张卡片在桌上一字排开,每张卡片上有两个数,第i张卡片上,正面的数为a[i],反面的数为b[i].现在,有m个熊孩子来破坏你的卡片了!第i个熊孩子会交换c[i]和d[i]两个位置上的卡片. ...
- NKOJ3765 k个最小和
问题描述 有k个整数数组,各包含k个元素,从每个数组中选取一个元素加起来,可以得到k^k个和,求这些和中最小的k个值. 输入格式 第一行,一个整数k(k<=500)接下来k行,每行k个正整数(& ...
- .gitattributes
.gitattributes文件是一个文本文件,文件中的一行定义一个路径的若干属性.以行为单位设置一个路径下所有文件的属性,格式如下: 要匹配的文件模式 属性1 属性2 GRLF和LF CRLF,LF ...
- 微信小程序页面传值详解
我们知道,在微信小程序中,从一个页面转到另一个页面,一般情况下可以通过navigate或redirect时候的url来携带参数,然后在目标页面的onLoad函数参数中获取这些url参数.例如: / ...
- 安卓开发学习日记 DAY5——监听事件onClick的实现方法
今天主要学习了监听事件的是实现方法,就是说,做了某些动作后,怎么监听这个动作并作出相应反应. 方法主要有三种: 1.匿名内部类的方法 2.独立类的方法 3.类似实现接口的方法 以下分别分析: 1.匿名 ...