
scrapy框架整理
0.安装scrapy框架
pip install scrapy
注:找不到的库,或者安装部分库报错,去python第三方库中找,很详细
https://www.lfd.uci.edu/~gohlke/pythonlibs/#wordcloud
1.创建一个scrapy框架
scrapy startproject 项目名

2.使用scrapy框架爬虫的三个步骤
a.配置items文件,确定需要爬取的字段
b.配置pipeline文件,确定文件的存储方式,并在setting文件中配置管道文件
注:如果存的是json数据,json.dumps(dict(item), ensure_ascii=False)
这里要记得将ensure_ascii置为False,原因是因为默认为ascii编码,但是中文用ascii编码会有问题
c.配置爬虫文件(分为两种,父类为Spider,CrawlSpider)
在终端中进入到项目目录下,执行:
scrapy genspider 爬虫名 限制的域名范围(创建Spider模板)
scrapy genspider -t crawl 爬虫名 限制的域名范围(创建CrawlSpider模板)
3.Spider类的使用
a.三个变量:name(爬虫名), allowed_domains(限定域), start_urls(最先请求的网站)
b.重写parse()方法,方法名必须是这个
c.在函数的最后yield item,会把item交给管道文件处理
d.如果需要再次发送请求的话需要 yield scrapy.Request(url,meta,callback)方法
url:为再次请求的地址
meta:请求携带的内容(字典格式),可以被response.meta取到,用于两个函数之间变量的传递
callback:请求的回调函数
4.CrawlSpider类的使用
a.三个变量(与Spider类一致)
b.rules规则的定义(用于匹配需要爬取的链接内容,且每次请求的页面也遵循这个规则)
优点:比Spider类更简洁,不需要写scrapy.Request()再次发送请求
注:rule规则可以写多条,如第一个规则用于翻页,第二个规则用于匹配当前页内中的链接
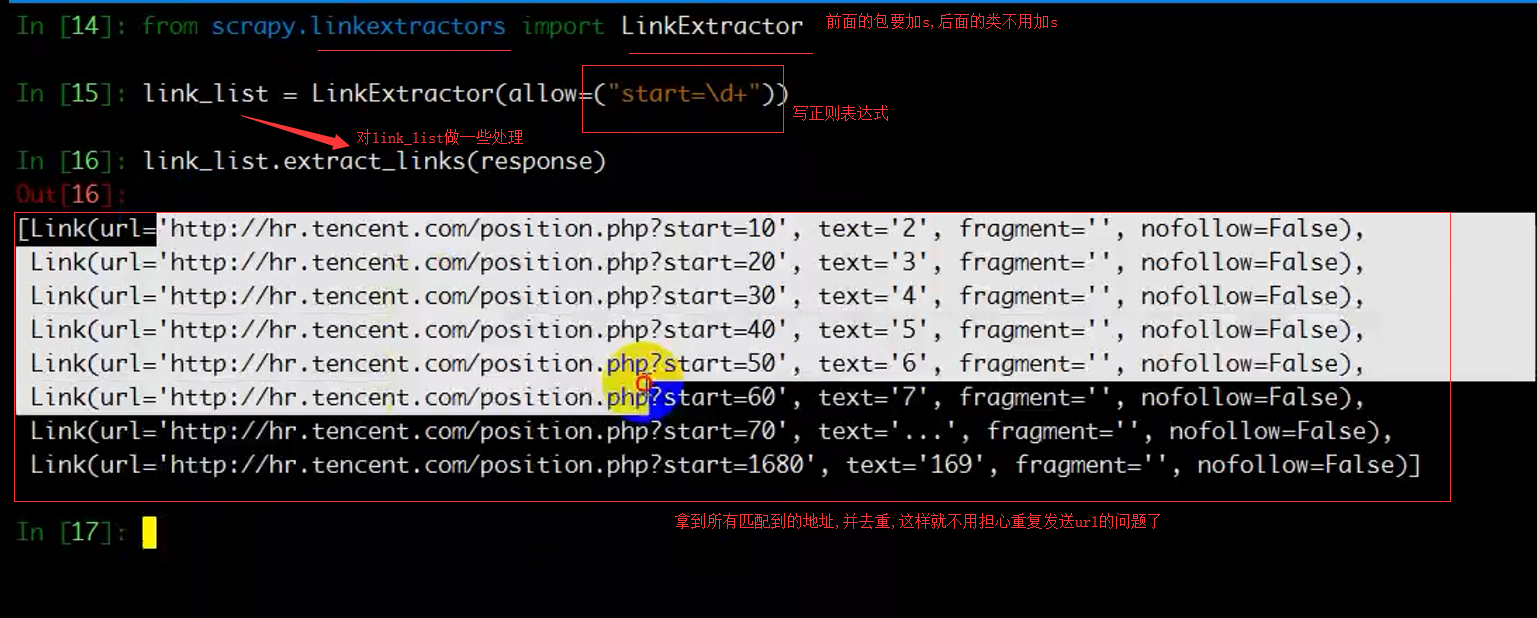
例:rules = (
Rule(LinkExtractor(allow=r'Items/'), callback='parse_item', follow=True),
)
allow:代表使用正则来匹配链接
restrict_xpaths:代表使用xpath来匹配链接
restrict_css:代表使用beautifulsoup4来匹配链接

callback:回调函数
follow:是否跟进(如果没有callback,follow默认为True),应用在匹配页码链接时,需要跟进
如果有callback,follow默认为False
注:在使用CrawlSpider时,callback不能再写parse,因为框架使用了parse实现其逻辑,我们在使用时,需要另起一个名字
5.中间件的设置
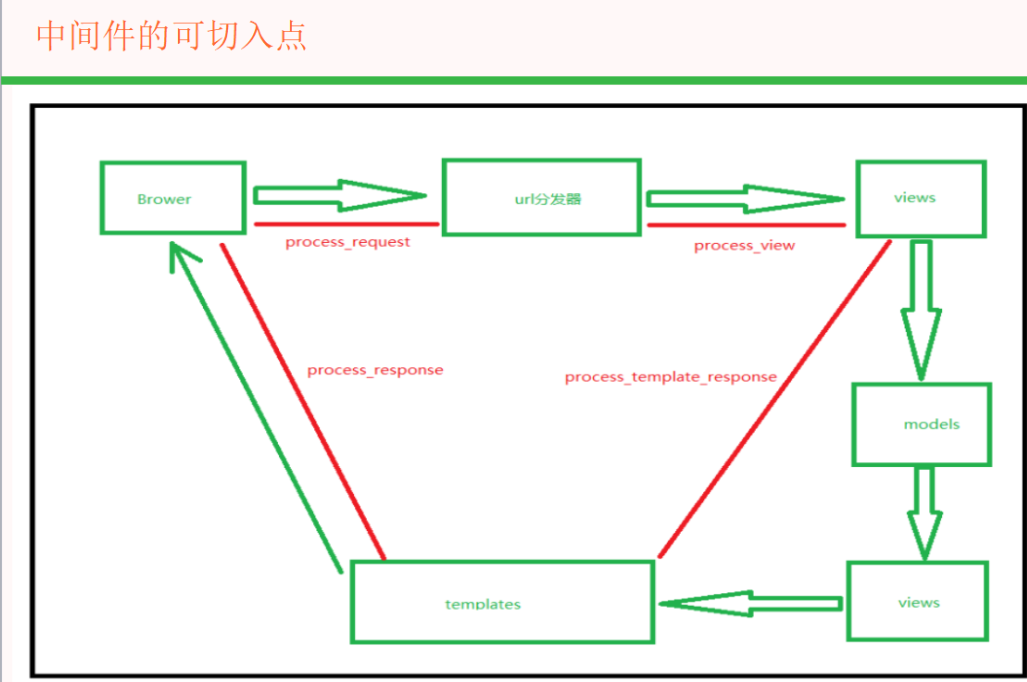
1.定义User-Agent列表,循环使用

2.如果需要使用代理服务器,需要设置代理,并附上对应的host和账号密码

scrapy框架整理的更多相关文章
- Python爬虫从入门到放弃(十一)之 Scrapy框架整体的一个了解
这里是通过爬取伯乐在线的全部文章为例子,让自己先对scrapy进行一个整理的理解 该例子中的详细代码会放到我的github地址:https://github.com/pythonsite/spider ...
- python爬虫入门(六) Scrapy框架之原理介绍
Scrapy框架 Scrapy简介 Scrapy是用纯Python实现一个为了爬取网站数据.提取结构性数据而编写的应用框架,用途非常广泛. 框架的力量,用户只需要定制开发几个模块就可以轻松的实现一个爬 ...
- Scrapy 框架流程详解
框架流程图 Scrapy 使用了 Twisted 异步非阻塞网络库来处理网络通讯,整体架构大致如下(绿线是数据流向): 简单叙述一下每层图的含义吧: Spiders(爬虫):它负责处理所有Respon ...
- Scrapy框架-----爬虫
说明:文章是本人读了崔庆才的Python3---网络爬虫开发实战,做的简单整理,希望能帮助正在学习的小伙伴~~ 1. 准备工作: 安装Scrapy框架.MongoDB和PyMongo库,如果没有安装, ...
- 12.scrapy框架
一.Scrapy 框架简介 1.简介 Scrapy是用纯Python实现一个为了爬取网站数据.提取结构性数据而编写的应用框架,用途非常广泛. 框架的力量,用户只需要定制开发几个模块就可以轻松的实现一个 ...
- Scrapy 框架 安装
Scrapy 框架 Scrapy是用纯Python实现一个为了爬取网站数据.提取结构性数据而编写的应用框架,用途非常广泛. 框架的力量,用户只需要定制开发几个模块就可以轻松的实现一个爬虫,用来抓取网页 ...
- Scrapy框架学习笔记
1.Scrapy简介 Scrapy是用纯Python实现一个为了爬取网站数据.提取结构性数据而编写的应用框架,用途非常广泛. 框架的力量,用户只需要定制开发几个模块就可以轻松的实现一个爬虫,用来抓取网 ...
- scrapy框架系列 (1) 初识scrapy
Scrapy 框架 Scrapy是用纯Python实现一个为了爬取网站数据.提取结构性数据而编写的应用框架,用途非常广泛. 框架的力量,用户只需要定制开发几个模块就可以轻松的实现一个爬虫,用来抓取网页 ...
- Python爬虫进阶三之Scrapy框架安装配置
初级的爬虫我们利用urllib和urllib2库以及正则表达式就可以完成了,不过还有更加强大的工具,爬虫框架Scrapy,这安装过程也是煞费苦心哪,在此整理如下. Windows 平台: 我的系统是 ...
随机推荐
- Centos7.1环境下搭建SVN
环境准备: 系统 配置 IP Centos7.1 1核2G+60GB硬盘 10.10.28.204 1.安装 sudo yum install subversion 查看版本 svnserve –-v ...
- 在Windows上搭建Git Server
Git在版本控制方面,相比与SVN有更多的灵活性,对于开源的项目,我们可以托管到Github上面,非常方便,但是闭源的项目就会收取昂贵的费用. 那么私有项目,如何用Git进行代码版本控制呢?我们可以自 ...
- Redis入门到高可用(十五)—— HyperLogLog
一.简介 二.API Demo 三.使用经验
- python框架之Django(3)-模版
常用语法 符号 {{...}} # 变量相关 {%...%} # 逻辑相关 {#...#} # 注释 使用变量 def test(request): name = '张三' age = 19 retu ...
- Cartographer源码阅读(7):轨迹推算和位姿推算的原理
其实也就是包括两个方面的内容:类似于运动模型的位姿估计和扫描匹配,因为需要计算速度,所以时间就有必要了! 1. PoseExtrapolator解决了IMU数据.里程计和位姿信息进行融合的问题. 该类 ...
- asp.net 导出excel--NPOI
1.使用OLEDB导出Excel ,这种方式有点慢,慎用 /// <summary> /// 使用OLEDB导出Excel /// </summary> /// <par ...
- IP通信基础学习第二周
此周的课程学习应该算是我对此科目真正学校生涯的开始吧,尽管我对该科目仍感到很陌生. 课程一开头,老师就给我们简单的介绍了网络的定义.发展及其分类,重点讲了网络拓扑结构及其在局域网上具体的分层情况.该部 ...
- 20190402Linux高级命令进阶(week1_day2
Linux高级命令进阶(week1_day2) 输出重定向 场景:一般命令的输出都会显示在终端中,有些时候需要将一些命令的执行结果想要保存到文件中进行后续的分析/统计,则这时候需要使用到的输出重定向技 ...
- MySQL条件检索_WHERE
MySQL使用WHERE命令来限定数据查询条件. 语法:SELECT 属性1,属性2 FROM 表名 WHERE 条件1 OR 条件2 AND 条件3 说明:WHERE同样适用于UPDATE.DELE ...
- Linux 查看系统状态
查看系统状态 命令:vmstat 命令:vmsta 1 10 #每1秒钟1次显示10次. r:几个进程在占用cpu b:等待IO值 Swpd:多少交换内存 free:剩余内 ...