
学习bn算法
好处:
1.归一化后有什么好处呢?原因在于神经网络学习过程本质就是为了学习数据分布,一旦训练数据与测试数据的分布不同,那么网络的泛化能力也大大降低;
2.另外一方面,一旦每批训练数据的分布各不相同(batch 梯度下降),那么网络就要在每次迭代都去学习适应不同的分布,这样将会大大降低网络的训练速度,这也正是为什么我们需要对数据都要做一个归一化预处理的原因。
原因:
我们把网络中间层在训练过程中,数据分布的改变称之为:“Internal Covariate Shift”。Paper所提出的算法,就是要解决在训练过程中,中间层数据分布发生改变的情况,于是就有了Batch Normalization,这个牛逼算法的诞生。
首先学习一下白化这个预处理方法:
举例来说,假设训练数据是图像,由于图像中相邻像素之间具有很强的相关性,所以用于训练时输入是冗余的。白化的目的就是降低输入的冗余性;更正式的说,我们希望通过白化过程使得学习算法的输入具有如下性质:(i)特征之间相关性较低;(ii)所有特征具有相同的方差。
1.首先复习pca的本质:
本质就是1.先算n个特征数据集的协方差矩阵.2.然后找协方差矩阵从大到小最大的k个方向,k<n.3.把数据在这k个分量上做投影,就得到了更小维度的数据,也尽量保持了数据.
其实这些方向也就是矩阵的奇异值对应的奇异向量.也就是主方向.
2.第一种白化pca白化:1.先做pca 2.把得到的数据再让各个主方向的方差都是1即可.
def zca_whitening(inputs):

    sigma = np.dot(inputs, inputs.T)/inputs.shape[] #inputs是经过归一化处理的,所以这边就相当于计算协方差矩阵

    U,S,V = np.linalg.svd(sigma) #奇异分解

    epsilon = 0.1                #白化的时候,防止除数为0

    ZCAMatrix = np.dot(np.dot(U, np.diag(1.0/np.sqrt(np.diag(S) + epsilon))), U.T)                     #计算zca白化矩阵

    return np.dot(ZCAMatrix, inputs)   #白化变换
别人的代码.我感觉这写的根本不对啊.我试了input是2*3的矩阵输出一个1*3的矩阵.这尼玛sample_size都给我变了.搞毛.我再查查.感觉第一步sigma就不用求.
inputs就是一个大矩阵.
比如我做的汽车问题inputs=2万*30 sample_size*feature_size,这上面代码不对,根本跑不了.我已经需改好,放到博客里面了.
下面跳过白化.继续讨论bn算法.
随机梯度下降就是用batch的bp算法.虽然看了很多次,也会很多次,但是老忘记这个名字对应的含义,总感觉这个名字起的操蛋.为什么不用小批量bp算法来起名字!
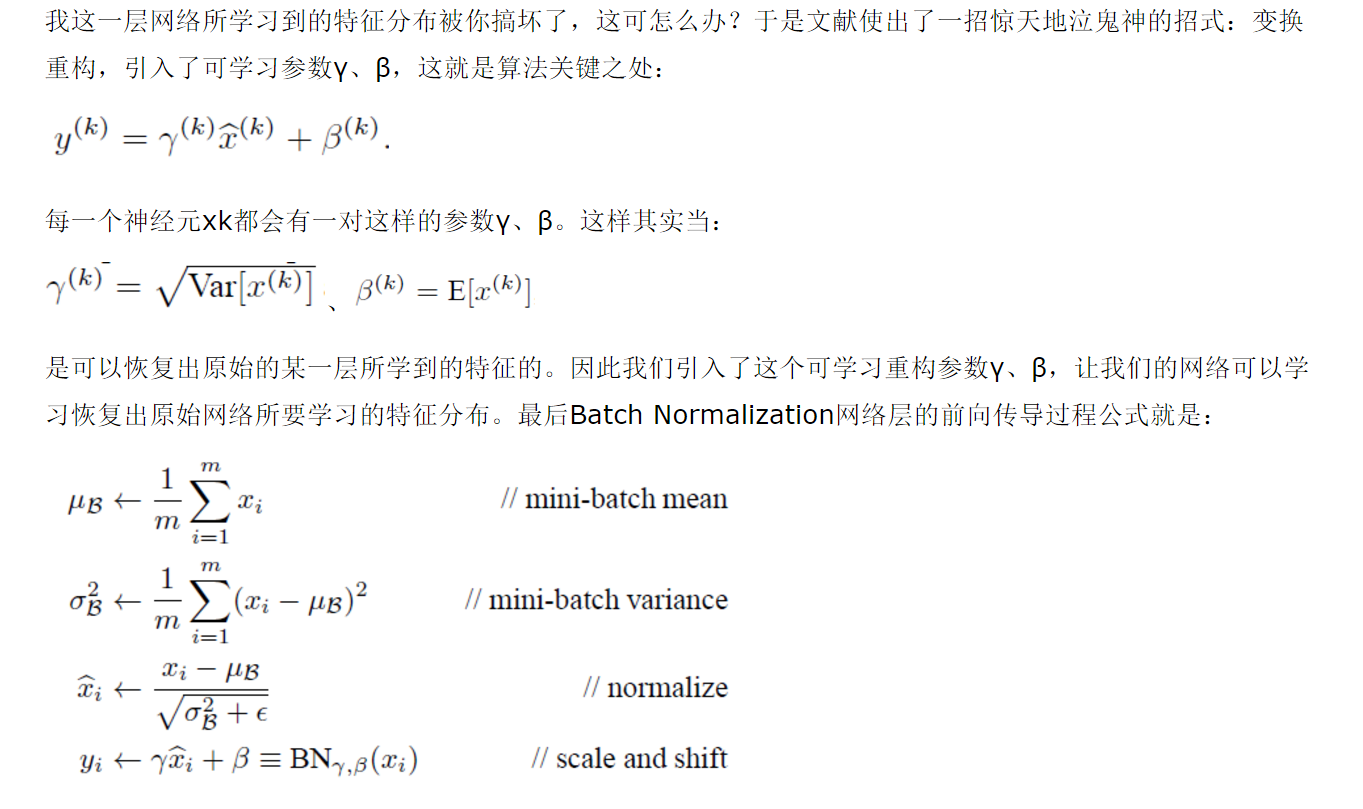
这就是bn算法的核心了,加入一个放射变换,用这变化来归一化这一层的数据.
思路也不难,1.这个bn层,先做归一化,然后你归一化之后会破坏这个数据的分布,导致学习效果很差.
2.做一个放射变换把归一化之后的东西再放射一下来恢复这个数据进入这个bn层的输入状态.这样通过归一化和放射变化就组合出了bn层.
import numpy as np
X=np.array([[1,2,3],[2,3,4]])
gamma=1
beta=0
epsilon=0.01
m = np.mean(X, axis=-1, keepdims=True)#计算均值
std = np.std(X, axis=-1, keepdims=True)#计算标准差
X_normed = (X - m) / (std + epsilon)#归一化
out = gamma * X_normed + beta#重构变换
print (out)
print (np.std(out))
print (np.mean(out))
效果还行.听说效果能提高10倍,
行了,去汽车里面试试去了
学习bn算法的更多相关文章
- 转——深度学习之BN算法(Batch Normailization)
Batch Normalization 学习笔记 原文地址:http://blog.csdn.net/hjimce/article/details/50866313 作者:hjimce 一.背景意义 ...
- BN算法
批量归一化(BN: Batch Normalization) 1 BN训练 1)随机梯度下降法(SGD)对于训练深度网络简单高效,但是它有个毛病,就是需要我们人为的去选择参数,比如学习率.参数初始化. ...
- [置顶] 小白学习KM算法详细总结--附上模板题hdu2255
KM算法是基于匈牙利算法求最大或最小权值的完备匹配 关于KM不知道看了多久,每次都不能完全理解,今天花了很久的时间做个总结,归纳以及结合别人的总结给出自己的理解,希望自己以后来看能一目了然,也希望对刚 ...
- 学习cordic算法所得(流水线结构、Verilog标准)
最近学习cordic算法,并利用FPGA实现,在整个学习过程中,对cordic算法原理.FPGA中流水线设计.Verilog标准有了更加深刻的理解. 首先,cordic算法的基本思想是通过一系列固定的 ...
- 学习排序算法(一):单文档方法 Pointwise
学习排序算法(一):单文档方法 Pointwise 1. 基本思想 这样的方法主要是将搜索结果的文档变为特征向量,然后将排序问题转化成了机器学习中的常规的分类问题,并且是个多类分类问题. 2. 方法流 ...
- 从 SGD 到 Adam —— 深度学习优化算法概览(一) 重点
https://zhuanlan.zhihu.com/p/32626442 骆梁宸 paper插画师:poster设计师:oral slides制作人 445 人赞同了该文章 楔子 前些日在写计算数学 ...
- 吴裕雄 python 机器学习——集成学习AdaBoost算法回归模型
import numpy as np import matplotlib.pyplot as plt from sklearn import datasets,ensemble from sklear ...
- 吴裕雄 python 机器学习——集成学习AdaBoost算法分类模型
import numpy as np import matplotlib.pyplot as plt from sklearn import datasets,ensemble from sklear ...
- TF之BN:BN算法对多层中的每层神经网络加快学习QuadraticFunction_InputData+Histogram+BN的Error_curve
# 23 Batch Normalization import numpy as np import tensorflow as tf import matplotlib.pyplot as plt ...
随机推荐
- wzben的QQ空间
实习之后没有动过博客了,后续慢慢补.
- leetcode404
/** * Definition for a binary tree node. * public class TreeNode { * public int val; * public TreeNo ...
- 获取request错误信息
from: https://stackoverflow.com/questions/19370436/get-errno-from-python-requests-connectionerror 当使 ...
- SQL语言类别
SQL语言主要分为四大类:数据查询语言DQL,数据操纵语言DML, 数据定义语言DDL,数据控制语言DCL. DQL (data query language) DML(data manipulati ...
- os.popen与os.system区别
os.system 调用系统命令,完成后退出,返回结果是命令执行状态,一般是0 os.popen 可以实现一个“管道”,从这个命令获取的值可以在python 中继续被使用 #该方法不但执行命令还返回执 ...
- one by one 项目 part 2
在网上百度了一下mySQL常用语句 ,整理如下: 1.说明:创建数据库 CREATE DATABASE database-name 2.说明:删除数据库 drop database dbname 3. ...
- Hive—学习笔记(一)
主要内容: 1.Hive的基本工能机制和概念 2.hive的安装和基本使用 3.HQL 4.hive的脚本化运行使用方式 5.hive的基本语法--建表语法 6.hive的基本语法--内部表和外部表. ...
- CentOS6.5下安装ActiveMQ
1.下载ActiveMQ [root@localhost softwares]# wget http://archive.apache.org/dist/activemq/apache-activem ...
- pre换行段落间距
<!DOCTYPE html><html><head lang="en"><meta charset="UTF-8"& ...
- 第八章 高级搜索树 (xa1)红黑树:动机