
Python爬虫全网搜索并下载音乐
现在写一篇博客总是喜欢先谈需求或者本内容的应用场景,是的,如果写出来的东西没有任何应用价值,确实也没有实际意义。今天的最早的需求是来自于如何免费[白嫖]下载全网优质音乐,我去b站上面搜索到了一个大牛做过的一个歌曲搜素神器,界面是这样的:
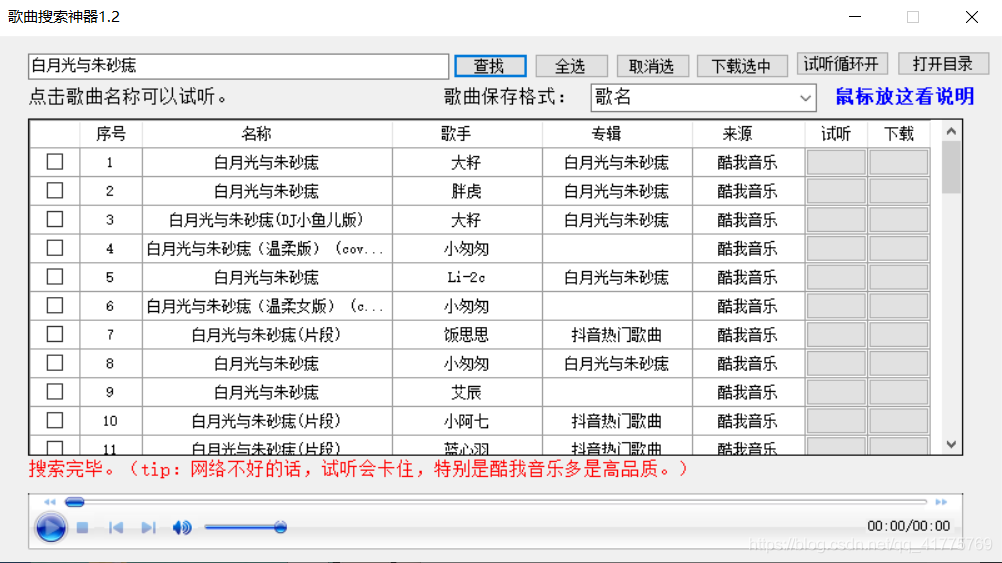
确实很好用的,而且涵盖了互联网上面大多数主流的音乐网站,涉及到的版本也很多,可谓大而全,但是一个技术人的追求远远不会如此,于是我就想去了解其中背后的原理,因为做过网络爬虫的人都知道,爬虫只能爬取某一页或者某些页的网站资源,所以我很好奇它背后是怎么实现的?
笔者一直以来都是做的基于Python3.7版本的网络爬虫,所以本文也是基于此来学习记录的。首先爬取的网站不是对应的音乐网站,而是一个音乐直链搜索,那里汇聚了大多数音频音乐的解析功能,界面如下:
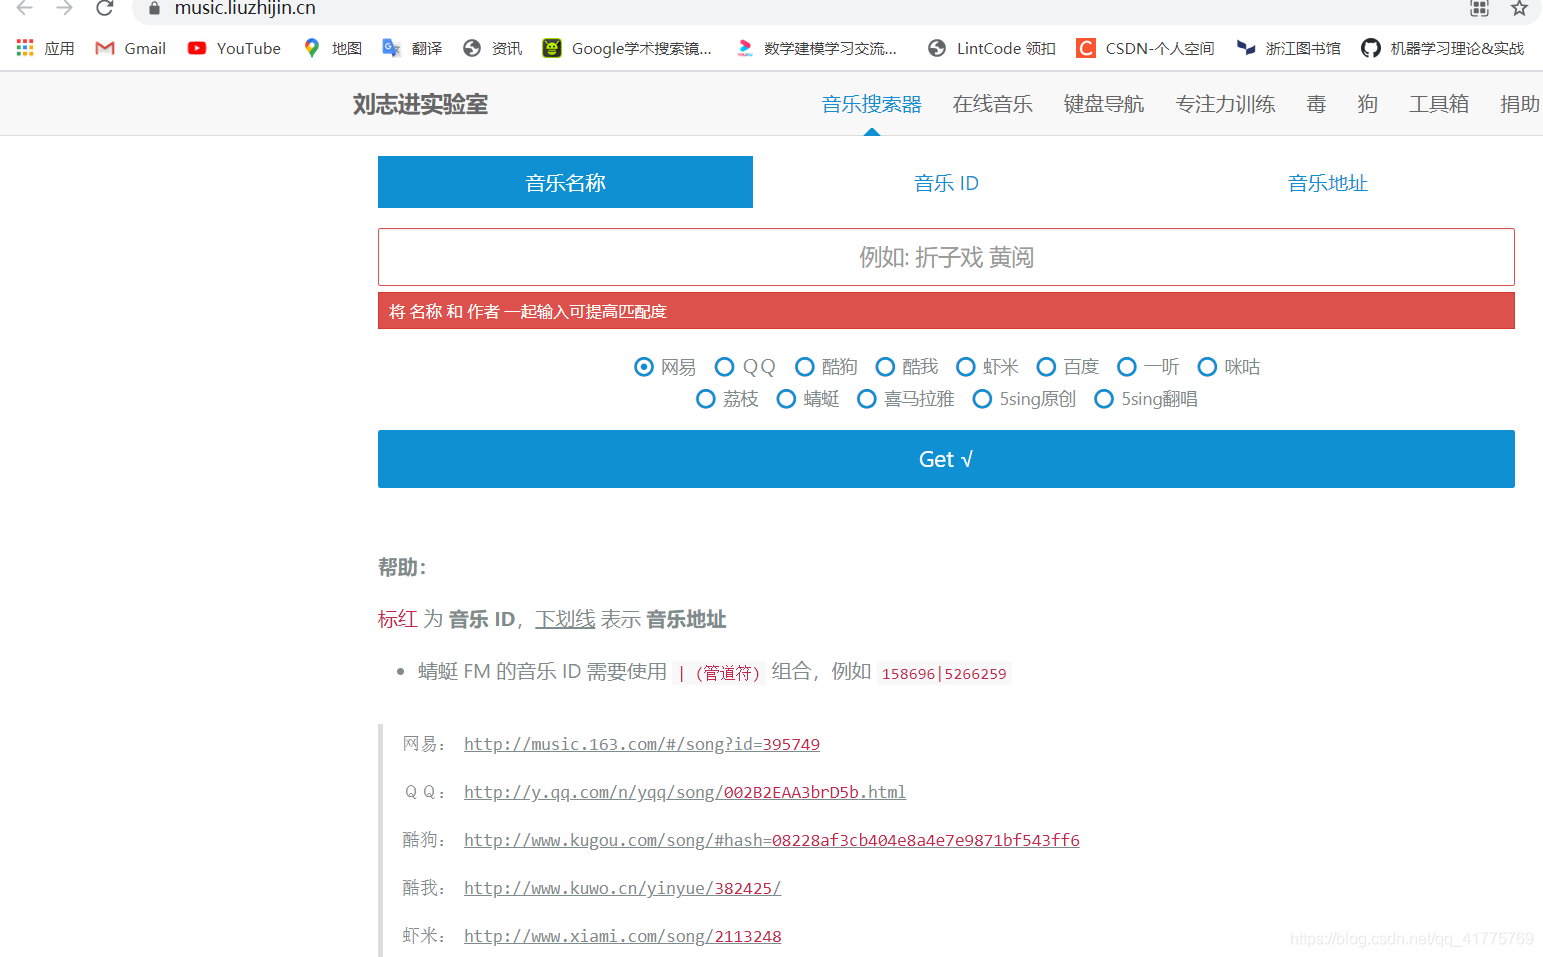
所以自制一个搜索引擎的思想也很直观了,那就是利用第三方的接口,直接对该服务器发起请求即可,然后将获取的数据进行解析保存。这里以最近比较火的歌曲“白月光与朱砂痣”下载为例:
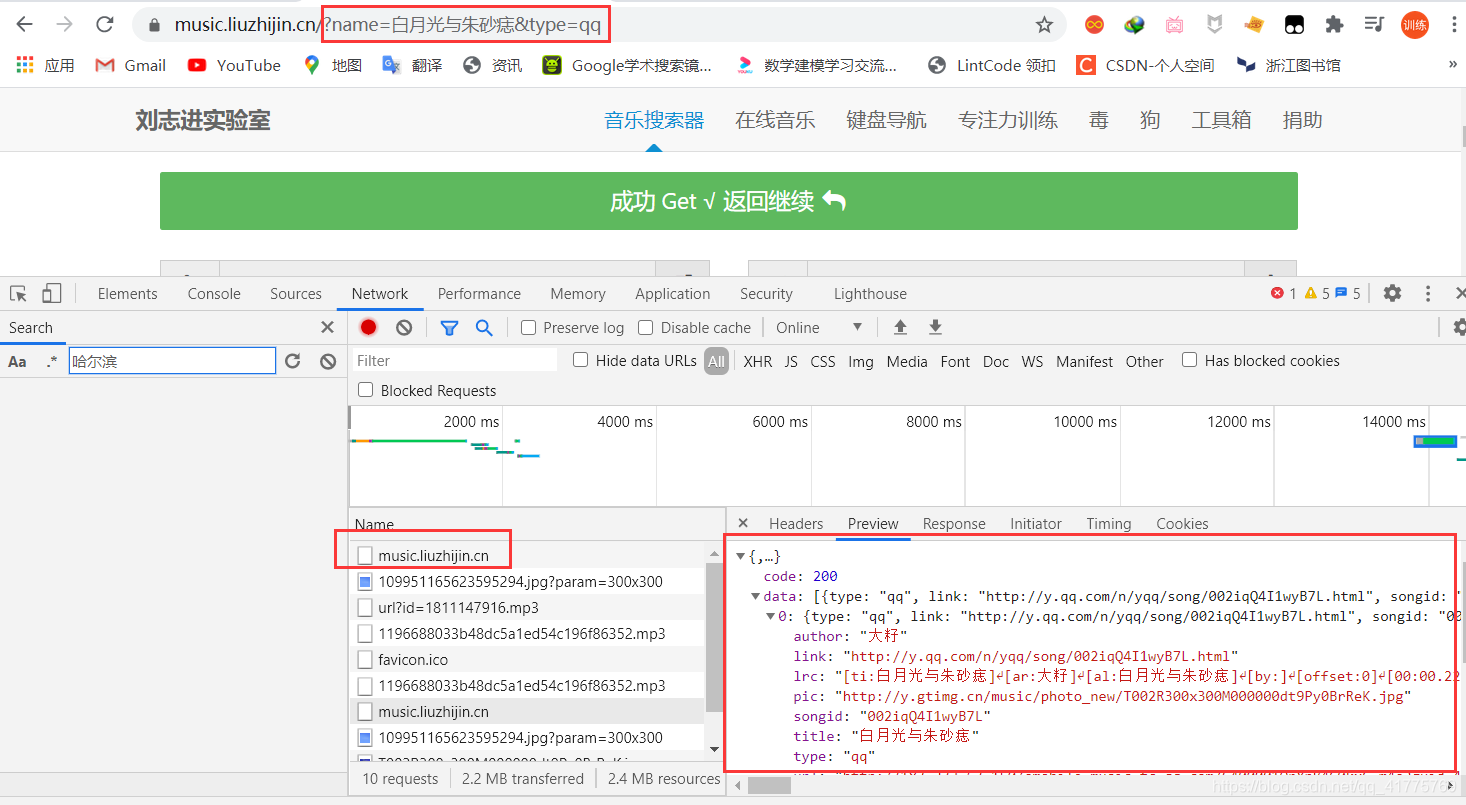
解析的结果如上,获取的数据格式是json类型,并且除了要有歌名以外,还要有音乐平台。
源代码实现如下:
import requests

import jsonpath

import os

"""

    1.url

    2.模拟浏览器请求

    3.解析网页源代码

    4.保存数据

"""

def song_download(url,title,author):

    # 创建文件夹

    os.makedirs("music",exist_ok=True)

    path = 'music\{}.mp3'.format(title)

    print('歌曲:{0}-{1},正在下载...'.format(title,author))

    # 下载(这种读写文件的下载方式适合少量文件的下载)

    content = requests.get(url).content

    with open(file = title + author + '.mp3',mode='wb') as f:

        f.write(content)

    print('下载完毕,{0}-{1},请试听'.format(title,author))

def get_music_name():

    """

    搜索歌曲名称

    :return:

    """

    name = input("请输入歌曲名称:")

    print("1.网易云:netease\n2.QQ:qq\n3.酷狗:kugou\n4.酷我:kuwo\n5.百度:baidu\n6.喜马拉雅:ximalaya")

    platfrom = input("输入音乐平台类型:")

    print("-------------------------------------------------------")

    url = 'https://music.liuzhijin.cn/'

    headers = {

        "user-agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/87.0.4280.141 Safari/537.36",

        # 判断请求是异步还是同步

        "x-requested-with":"XMLHttpRequest",

    }

    param = {

        "input":name,

        "filter":"name",

        "type":platfrom,

        "page": 1,

    }

    res = requests.post(url=url,data=param,headers=headers)

    json_text = res.json()

    title = jsonpath.jsonpath(json_text,'$..title')

    author = jsonpath.jsonpath(json_text,'$..author')

    url = jsonpath.jsonpath(json_text, '$..url')

    if title:

        songs = list(zip(title,author,url))

        for s in songs:

            print(s[0],s[1],s[2])

        print("-------------------------------------------------------")

        index = int(input("请输入您想下载的歌曲版本:"))

        song_download(url[index],title[index],author[index])

    else:

        print("对不起,暂无搜索结果!")

if __name__ == "__main__":

    get_music_name()
演示一下运行效果:
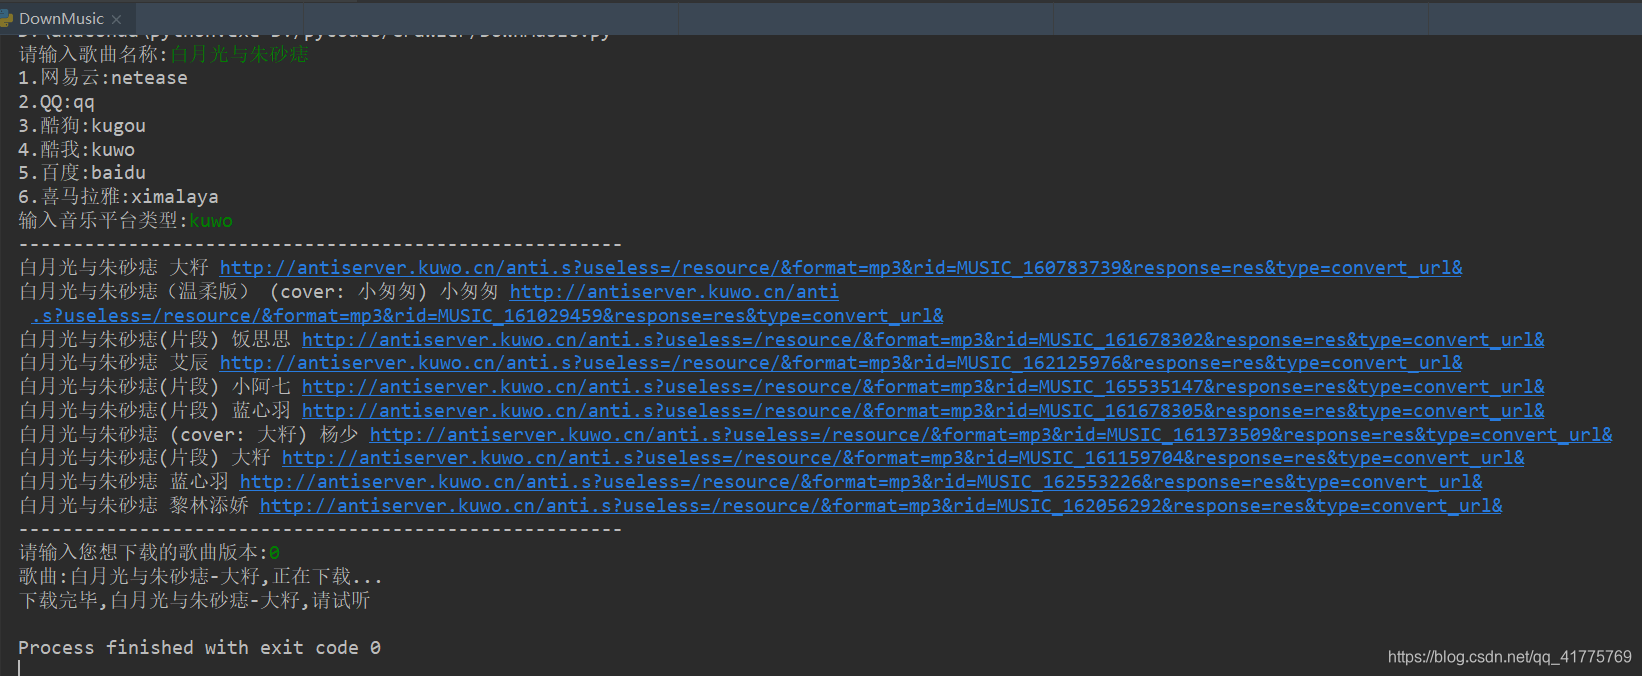
然后文件下就会出现对应的歌曲.mp3文件
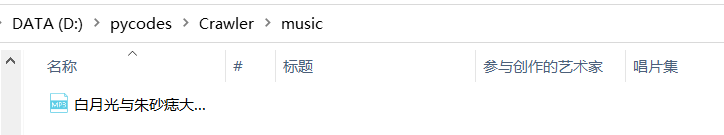
并且每次的歌曲检索都是在PyCharm专业版的控制台中进行的,这样的用户体验就非常糟糕,所以针对以上两个问题,我对源代码进行了改进。
# 导入模块

from tkinter import *

import requests

import jsonpath

import os

from urllib.request import urlretrieve

# 2.功能实现

"""

    1.url

    2.模拟浏览器请求

    3.解析网页源代码

    4.保存数据

"""

def song_download(url,title,author):

    # 创建文件夹

    os.makedirs("music",exist_ok=True)

    path = 'music\{}.mp3'.format(title)

    text.insert(END,'歌曲:{0}-{1},正在下载...'.format(title,author))

    # 文本框滑动

    text.see(END)

    # 更新

    text.update()

    # 下载

    urlretrieve(url,path)

    text.insert(END,'下载完毕,{0}-{1},请试听'.format(title,author))

    # 文本框滑动

    text.see(END)

    # 更新

    text.update()

def get_music_name():

    """

    搜索歌曲名称

    :return:

    """

    name = entry.get()

    platfrom = var.get()

    # name = '白月光与朱砂痣'

    url = 'https://music.liuzhijin.cn/'

    headers = {

        "user-agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/87.0.4280.141 Safari/537.36",

        # 判断请求是异步还是同步

        "x-requested-with":"XMLHttpRequest",

    }

    param = {

        "input":name,

        "filter":"name",

        "type":platfrom,

        "page": 1,

    }

    res = requests.post(url=url,data=param,headers=headers)

    json_text = res.json()

    title = jsonpath.jsonpath(json_text,'$..title')

    author = jsonpath.jsonpath(json_text,'$..author')

    url = jsonpath.jsonpath(json_text, '$..url')

    print(title,author,url)

    song_download(url[0],title[0],author[0])

# 1.用户界面

# 创建画板

root = Tk()

# 设置窗口标题

root.title('全网音乐下载器')

# 设置窗口大小以及出现的位置

root.geometry('560x450+400+200')

# 标签组件

label = Label(root,text="请输入下载的歌曲:",font=('楷体',20))

# 定位与布局

label.grid(row=0)

# 输入框组件

entry = Entry(root,font=('宋体',20))

entry.grid(row=0,column=1)

# 单选按钮

var = StringVar()

r1 = Radiobutton(root,text='网易云',variable=var,value='netease')

r1.grid(row=1,column=0)

r2 = Radiobutton(root,text='QQ',variable=var,value='qq')

r2.grid(row=1,column=1)

# 列表框

text = Listbox(root,font=('楷体',16),width=50,height=15)

text.grid(row=2,columnspan=2)

# 下载按钮

button1 = Button(root,text='开始下载',font=('楷体',15),command=get_music_name)

button1.grid(row=3,column=0)

button2 = Button(root,text='退出程序',font=('楷体',15),command=root.quit)

button2.grid(row=3,column=1)

# 显示界面

root.mainloop()

# 如何将.py代码打包成.exe文件
我们再来看看效果吧
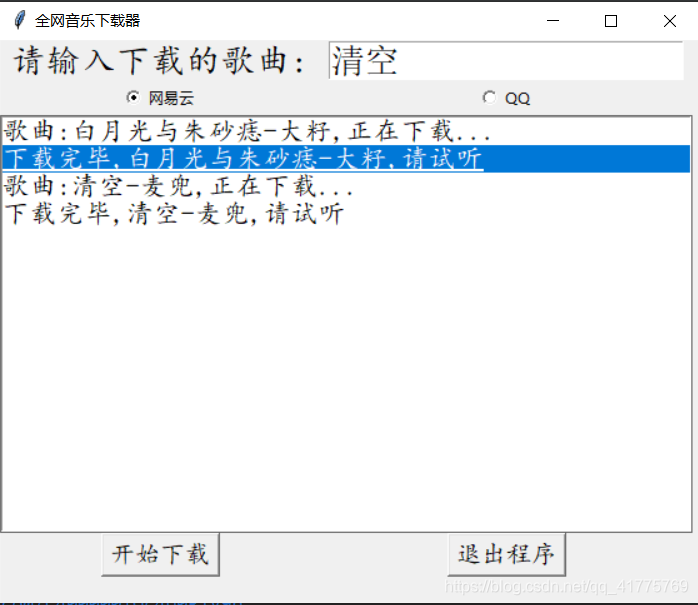
这样加上了UI界面和部分代码优化之后,就可以通过.py代码打包成.exe文件发布给用户使用了。
Python爬虫全网搜索并下载音乐的更多相关文章
- python一键电影搜索与下载
代码地址如下:http://www.demodashi.com/demo/14313.html python一键电影搜索与下载 概述 使用python搜索并爬取豆瓣电影信息,包括评分,主演,导演,类型 ...
- python爬虫之小说网站--下载小说(正则表达式)
python爬虫之小说网站--下载小说(正则表达式) 思路: 1.找到要下载的小说首页,打开网页源代码进行分析(例:https://www.kanunu8.com/files/old/2011/244 ...
- Python爬虫帮你打包下载所有抖音好听的背景音乐,还不快收藏一起听歌【华为云技术分享】
版权声明:本文为博主原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接和本声明. 本文链接:https://blog.csdn.net/devcloud/article/detai ...
- 爱奇艺用券付费VIP电影+python爬虫程序+可视化界面+下载本地
申明:本博客中的工具及源码仅供个人学习使用,请勿用作商业等其他任何违法用途!否则后果自负 直接步入正题吧! 工具开发环境:windows10,python3.6 工具界面设计:基于python 自带的 ...
- Python爬虫实战:批量下载网站图片
前言 本文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者: GitPython PS:如有需要Python学习资料的小伙伴可以 ...
- 【Python爬虫案例学习】下载某图片网站的所有图集
前言 其实很简短就是利用爬虫的第三方库Requests与BeautifulSoup. 其实就几行代码,但希望没有开发基础的人也能一下子看明白,所以大神请绕行. 基本环境配置 python 版本:2.7 ...
- Python 爬虫学习 网页图片下载
使用正则表达式匹配 # coding:utf-8 import re import urllib def get_content(url): """ Evilxr, &q ...
- python爬虫:抓取下载电影文件,合并ts文件为完整视频
目标网站:https://www.88ys.cc/vod-play-id-58547-src-1-num-1.html 反贪风暴4 对电影进行分析 我们发现,电影是按片段一点点加载出来的,我们分别抓取 ...
- python爬虫模块之HTML下载模块
HTML下载模块 该模块主要是根据提供的url进行下载对应url的网页内容.使用模块requets-HTML,加入重试逻辑以及设定最大重试次数,同时限制访问时间,防止长时间未响应造成程序假死现象. 根 ...
随机推荐
- 量子化学Gaussian技术实战课 2021年4月9号--12号 远程在线教学
材料模拟分子动力学课程 3月19号--22号 远程在线课 lammps分子动力学课程 3月12号--15号 远程在线课 第一性原理VASP实战课 3月25号-28号 远程在线课 量子化学Gaussia ...
- mysql忽略表中的某个字段不查询
业务场景 1.表中字段较多 2.查询不需要表中某个字段的数据 语句如下: SELECT CONCAT(' select ',GROUP_CONCAT(COLUMN_NAME),' from ', TA ...
- ryu—交换机
1. 代码解析 ryu/app/example_switch_13.py: from ryu.base import app_manager from ryu.controller import of ...
- 每月一更的《HelloGitHub》第 58 期,来啦!
HelloGitHub 分享 GitHub 上有趣.入门级的开源项目.欢迎大家: 贡献代码 宣传你觉得优秀的项目 Star 项目️ 本月刊是每月 28 号更新,再见月刊就是年后了.在这里提前祝大家:新 ...
- 如何讲清楚 Java 面向对象的问题与知识?(类与对象,封装,继承,多态,接口,内部类...)
写在最前面 这个项目是从20年末就立好的 flag,经过几年的学习,回过头再去看很多知识点又有新的理解.所以趁着找实习的准备,结合以前的学习储备,创建一个主要针对应届生和初学者的 Java 开源知识项 ...
- code-server scala error: object apache is not a member of package org
原因是scala缺少包,需要把spark或对应的包放入scala目录下的lib,然后重启主机,在terminal输入reboot即可. 如果不重启主机,则在交互式编程中可以成功import.但是直接在 ...
- Git提交代码规范 而且规范的Git提交历史,还可以直接生成项目发版的CHANGELOG(semantic-release)
Git提交代码规范 - 木之子梦之蝶 - 博客园 https://www.cnblogs.com/liumengdie/p/7885210.html Commit message 的格式 Git 每次 ...
- Spring 设计模式介绍
JDK 中用到了那些设计模式?Spring 中用到了那些设计模式?这两个问题,在面试中比较常见.我在网上搜索了一下关于 Spring 中设计模式的讲解几乎都是千篇一律,而且大部分都年代久远.所以,花了 ...
- Java Socket InetAddress类 Socket DatagramPacket TCP、UDP示例
java.net :为实现网络应用程序提供类. InetAddress类 方法摘要 方法摘要 boolean equals(Object obj) : 将此对象与指定对象比较. byte[] getA ...
- Maven环境搭建以及在IDEA中的配置与简单入门
目录 一.下载与安装 二.配置 1. 环境变量 2. 阿里云镜像 3. 本地仓库 三.IDEA创建Maven项目 1. 创建一个原始的Maven项目 1.2 指定模板创建(可选) 2. 配置GAV 3 ...