
SK-learn实现k近邻算法【准确率随k值的变化】-------莺尾花种类预测
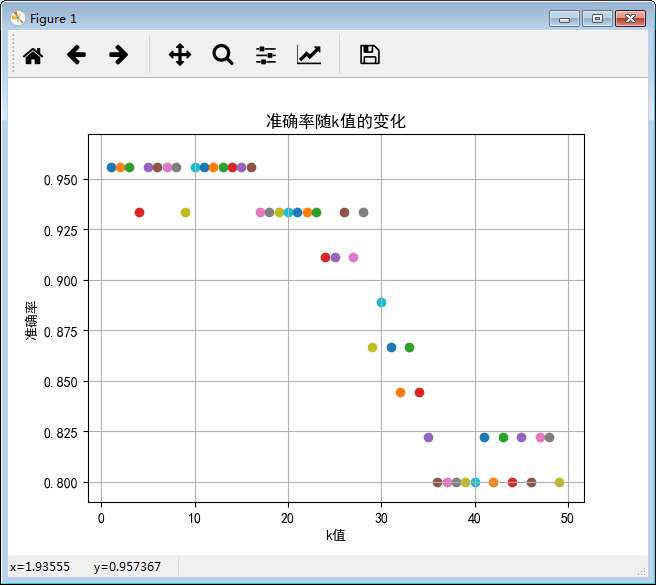
代码详解:
from sklearn.datasets import load_iris

from sklearn.model_selection import train_test_split

from sklearn.preprocessing import StandardScaler

from sklearn.neighbors import KNeighborsClassifier

import matplotlib.pyplot as plt

from pylab import mpl

# 设置显示中文字体

mpl.rcParams["font.sans-serif"] = ["SimHei"]

# 设置正常显示符号

mpl.rcParams["axes.unicode_minus"] = False

#读取数据

iris = load_iris()

#分出训练集和测试集

x_train,x_test,y_train,y_test = train_test_split(iris.data,iris.target,test_size=0.3,random_state=22)

#数据标准化,防止异常点的影响

transfer = StandardScaler()

x_train = transfer.fit_transform(x_train)

x_test = transfer.transform(x_test)

#创建画布

plt.figure()

plt.title("准确率随k值的变化")

#打开交互

plt.ion()

#网格

plt.grid()

#x轴和y轴标注

plt.ylabel("准确率")

plt.xlabel("k值")

#循环k的取值从1到50

for k in range(1,50):

    # plt.cla()

    #定义一个k分类算法对象

    estimator = KNeighborsClassifier(n_neighbors=k)

    #训练

    estimator.fit(x_train,y_train)

    #用测试集测试准确率

    y_predict = estimator.predict(x_test)

    score = estimator.score(x_test, y_test)

    #画散点图

    plt.scatter(k,score)

    plt.pause(0.1)

    print("预测结果为:",y_predict)

    print("对比真实值和预测值:",y_test)

    print("准确率:",score)

#关闭交互模式,并最后显示图像

plt.ioff()

plt.show()
SK-learn实现k近邻算法【准确率随k值的变化】-------莺尾花种类预测的更多相关文章
- 1.K近邻算法
(一)K近邻算法基础 K近邻(KNN)算法优点 思想极度简单 应用数学知识少(近乎为0) 效果好 可以解释机器学习算法使用过程中的很多细节问题 更完整的刻画机器学习应用的流程 图解K近邻算法 上图是以 ...
- Python3入门机器学习 - k近邻算法
邻近算法,或者说K最近邻(kNN,k-NearestNeighbor)分类算法是数据挖掘分类技术中最简单的方法之一.所谓K最近邻,就是k个最近的邻居的意思,说的是每个样本都可以用它最接近的k个邻居来代 ...
- 02-16 k近邻算法
目录 k近邻算法 一.k近邻算法学习目标 二.k近邻算法引入 三.k近邻算法详解 3.1 k近邻算法三要素 3.1.1 k值的选择 3.1.2 最近邻算法 3.1.3 距离度量的方式 3.1.4 分类 ...
- k近邻算法(KNN)
k近邻算法(KNN) 定义:如果一个样本在特征空间中的k个最相似(即特征空间中最邻近)的样本中的大多数属于某一个类别,则该样本也属于这个类别. from sklearn.model_selection ...
- R语言学习笔记—K近邻算法
K近邻算法(KNN)是指一个样本如果在特征空间中的K个最相邻的样本中的大多数属于某一个类别,则该样本也属于这个类别,并具有这个类别上样本的特性.即每个样本都可以用它最接近的k个邻居来代表.KNN算法适 ...
- 机器学习(四) 分类算法--K近邻算法 KNN (上)
一.K近邻算法基础 KNN------- K近邻算法--------K-Nearest Neighbors 思想极度简单 应用数学知识少 (近乎为零) 效果好(缺点?) 可以解释机器学习算法使用过程中 ...
- 机器学习(1)——K近邻算法
KNN的函数写法 import numpy as np from math import sqrt from collections import Counter def KNN_classify(k ...
- python 机器学习(二)分类算法-k近邻算法
一.什么是K近邻算法? 定义: 如果一个样本在特征空间中的k个最相似(即特征空间中最邻近)的样本中的大多数属于某一个类别,则该样本也属于这个类别. 来源: KNN算法最早是由Cover和Hart提 ...
- GridSearchCV网格搜索得到最佳超参数, 在K近邻算法中的应用
最近在学习机器学习中的K近邻算法, KNeighborsClassifier 看似简单实则里面有很多的参数配置, 这些参数直接影响到预测的准确率. 很自然的问题就是如何找到最优参数配置? 这就需要用到 ...
随机推荐
- 《闲扯Redis三》Redis五种数据类型之List型
一.前言 Redis 提供了5种数据类型:String(字符串).Hash(哈希).List(列表).Set(集合).Zset(有序集合),理解每种数据类型的特点对于redis的开发和运维非常重要. ...
- 性能计数器在.NET Core中的新玩法
传统的.NET Framework提供的System.Diagnostics.PerformanceCounter类型可以帮助我们收集Windows操作系统下物理机或者进程的性能指标,基于Perfor ...
- 编译原理:LL(1)文法的判断,递归下降分析程序
1. 文法 G(S): (1)S -> AB (2)A ->Da|ε (3)B -> cC (4)C -> aADC |ε (5)D -> b|ε 验证文法 G(S)是不 ...
- Notepad++正则表达式查找替换文本中文字符
测试需求 测试工具中xml配置文件中注释字段包含中文字符,在Win10系统下使用工具中偶尔会出现中文乱码导致配置文件失效.解决方法将配置文件中的中文注释换成英文注释或者直接替换删除.如何将配置文件中的 ...
- BurpSuit工具安装和基本使用方法
burpsuite是渗透的必备工具,使用它可以进行一些截包分析,修改包数据.暴力破解.扫描等功能,使用最多的场景应该是设置代理拦截数据包分析数据和爆破. JDK工具下载和安装(可选) 运行BurpSu ...
- 2020.4.4号全国疫情哀悼日网页变灰色前端是如何实现的?-pink老师
今天是4.4疫情哀悼日,纪念疫情期间牺牲的烈士和逝世同胞,因此大部分网站颜色都变灰色了,我们前端是如何实现的呢? 核心原理,使用css3的滤镜效果即可,filter grayscale 将整个界面变为 ...
- CVE-2020-2551复现过程
项目地址 cnsimo/CVE-2020-2551 CVE-2020-2551 weblogic iiop 反序列化漏洞 该项目的搭建脚本在10.3.6版本经过测试,12版本未测试. 环境 kali+ ...
- 学习方法,学习方式By:ラピスラズリ(Dawn)20200407
原创,转载请注明,谢谢!
- 从JDK源码学习Arraylist
从今天开始从源码去学习一些Java的常用数据结构,打好基础:) Arraylist源码阅读: jdk版本:1.8.0 首先看其构造方法: 构造方法一: 第一种支持初始化容量大小,其中声明一个对象数组, ...
- Redis 练习(二)
需求: 为购物网站实现登录状态及浏览记录的维护 进入时检查 token 是否已登录 每次进入更新 token 最新进入时间 记录用户浏览的商品信息(最多 25 个) 定时检查 token 数量,如果超 ...