
SparkSQL /DataFrame /Spark RDD谁快?
如题所示,SparkSQL /DataFrame /Spark RDD谁快?
按照官方宣传以及大部分人的理解,SparkSQL和DataFrame虽然基于RDD,但是由于对RDD做了优化,所以性能会优于RDD。
之前一直也是这么理解和操作的,直到最近遇到了一个场景,打破了这种不太准确的认识。
某些场景下,RDD要比DataFrame快,性能有天壤之别。
需求如下:
以下两份数据求交集,结果输出url。
数据一,json格式,地址我们用path_json表示,大小10T,每一行数据格式:{"id":"md5字符串", "url":"https://www.thesaurus.com/","title":"sysnonyms and antonyms",xxx},大概20来个字段;
数据二,csv格式,地址我们用path_csv表示,大小50G,每一行数据格式:name url,2个字段,用\t隔开。
拿到需求后,迅速瞟了一眼数据,爽快答应需求方分分钟搞定。
此时此刻,必须得祭出宇宙Top N的IDE,结合我30多年的人生阅历和代码经验,瞬间雷光电扇,惊雷骤起,一顿操作猛如虎,天空飘过以下几行代码:
(老铁们,请自行安装python,pyspark,pycharm)
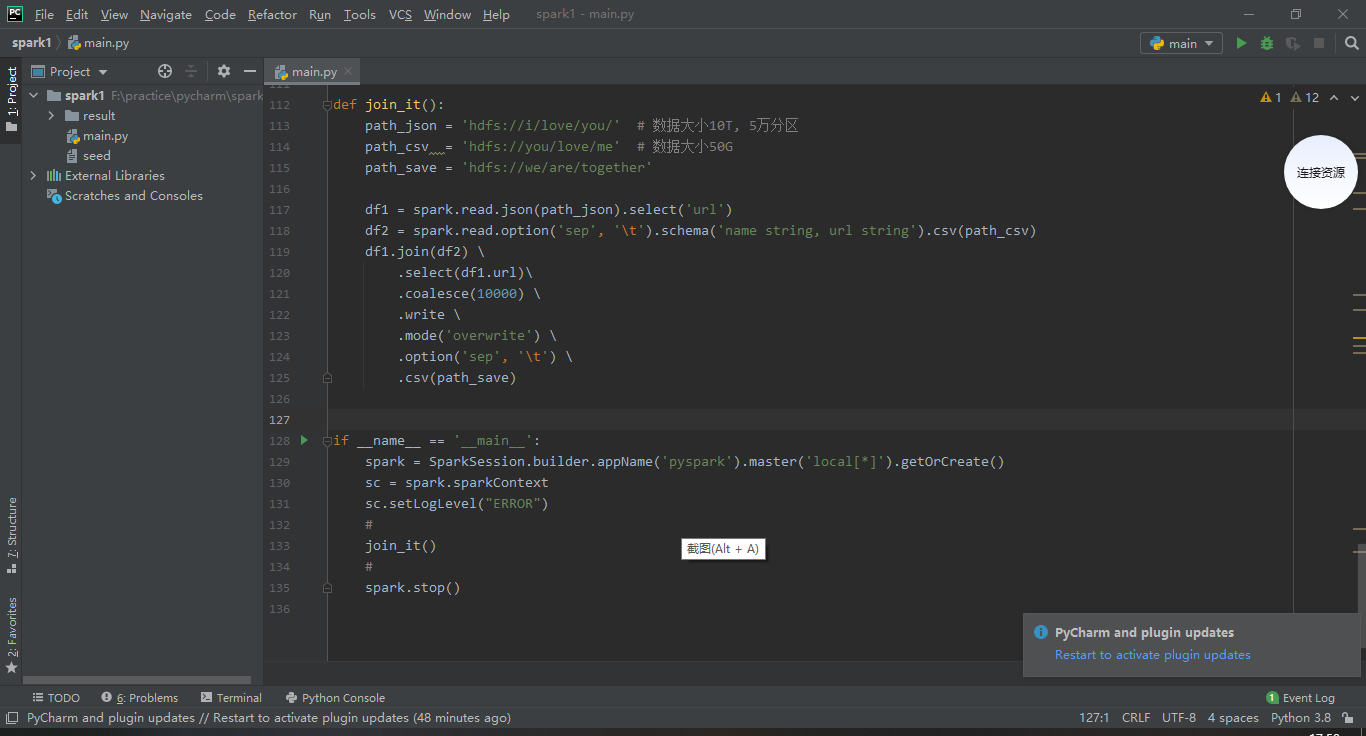
方案一
from pyspark.sql import SparkSession
def join_it():

    path_json = 'hdfs://i/love/you/'  # 数据大小10T, 5万分区

    path_csv  = 'hdfs://you/love/me'  # 数据大小50G

    path_save = 'hdfs://we/are/together'

    df1 = spark.read.json(path_json).select('url')

    df2 = spark.read.option('sep', '\t').schema('name string, url string').csv(path_csv)

    df1.join(df2) \

        .select(df1.url)\

        .coalesce(10000) \

        .write \

        .mode('overwrite') \

        .option('sep', '\t') \

        .csv(path_save)

if __name__ == '__main__':

    spark = SparkSession.builder.appName('pyspark').getOrCreate()

    sc = spark.sparkContext

    sc.setLogLevel("ERROR")

    #

    join_it()

    #

    spark.stop()
spark-submit提交任务到spark集群,参数根据自己的实际情况自行修改。
spark-submit \

    --master yarn \

    --deploy-mode client \

    --name 'i-live-you' \

    --queue 'you-love-me' \

    --driver-cores  \

    --driver-memory 30g \

    --num-executors  \

    --executor-memory 30g \

    --executor-cores  \

    --archives 'hdfs://your-python-path-on-hdfs#pkg'

    --conf spark.yarn.appMasterEnv.PYSPARK_PYTHON='集群里面的python地址' \

    --conf spark.sql.shuffle.partitions= \

    --conf spark.default.parallelism= \

    --conf spark.task.maxFailures= \

    your-spark-script.py
如果需要在本机调试代码,spark的生成需要替换成如下,然后直接运行。调试通过后,仍然需要按照上述方式spark-submit提交任务到集群运行,由于数据量很大,需要在集群运行才能看出性能差异。
spark = SparkSession.builder.appName('pyspark').master('local[*]').getOrCreate()
又是一顿猛操作,提交任务后,嗡嗡叫的肚子提醒我,要去厕所烧一根香,拜拜佛,佛祖保佑无bug。
深圳的夏天,依旧不负众望的燥热。热情似火的太阳,伴着她最爱的紫外线和电磁波,循着外太空固定的轨道,迈着30万公里/秒的矫健步伐,到达这颗承载70亿人的蓝色星球,穿透层层蓝天白云,无私的照亮着广袤的深圳大地。
酷暑让人思想活跃,思绪万千。扯得有点远了,重来 不重来了,接着写bug。
作为一个谨记厕所文化的人,蹲坑5分钟,方便你我他;蹲坑半小时,痔疮等着你。我选择了后者。
半小时过去了,时间随着大A股的大跌,瞬间来到了下午的收盘时间。果不其然,又一个下跌如期而至,就在这一刻,体内的混浊之气伴着伴随着收跌的股市排出体外。收拾干净后,我带着满身厕所的芬芳,回到了座位上。
再次打开电脑屏幕,spark任务还在慢悠悠的读取json文件,半小时才读取300G左右,10T的json文件按照这个速度,全部读完的好几天。此方案不可用。
方案二
果断改成RDD,然后用intersection求交集,果然快很多,10T跟50G求交集,12000cores,5分钟出结果。Spark任务提交同方案一,不再赘述。此方案可行
屁颠屁颠的把结果交付给需求方,大佬甚是满意地流出了开心的泪水
import json

from pyspark.sql import SparkSession

def join_it():

    path_json = 'hdfs://i/love/you/'  # 数据大小10T, 5万分区

    path_csv  = 'hdfs://you/love/me'  # 数据大小50G

    path_save = 'hdfs://we/are/together'

    #

    rdd1 = sc.textFile(path_json).map(lambda v: json.loads(v).get('url', '')).coalesce(50000)

    rdd2 = sc.textFile(path_csv).map(lambda v: v.split('\t')[1])

    rdd1.intersection(rdd2).coalesce(20000).saveAsTextFile(path_save)

if __name__ == '__main__':

    spark = SparkSession.builder.appName('pyspark').getOrCreate()

    sc = spark.sparkContext

    sc.setLogLevel("ERROR")

    #

    join_it()

    #

    spark.stop()
方案三
离下班实际还有30分钟,作为一个对技术有追求的资深码农 ,尝试用SparkSQL实现该功能。祭出代码,以资各位看官共享,新能跟RDD不相上下。此方案也可取。
import json

from pyspark.sql import SparkSession

def join_it():

    path_json = 'hdfs://i/love/you/'  # 数据大小10T, 5万分区

    path_csv  = 'hdfs://you/love/me'  # 数据大小50G

    path_save = 'hdfs://we/are/together'

    #

    sc.textFile(path_json).map(lambda v: (json.loads(v).get('url', ''),)).toDF(['url']).createOrReplaceTempView('a')

    spark.read.option('sep', '\t').schema('name string, url string').csv(path_csv).createOrReplaceTempView('b')

    sql = '''

    SELECT

        a.url

    FROM

        a

    JOIN

        b

    ON

        a.url=b.url

    '''

    spark.sql(sql).coalesce(20000).write.mode('overwrite').option('sep', '\t').csv(path_save)

if __name__ == '__main__':

    spark = SparkSession.builder.appName('pyspark').getOrCreate()

    sc = spark.sparkContext

    sc.setLogLevel("ERROR")

    #

    join_it()

    #

    spark.stop()
总结:
当遇到源数据是体量比较大的json或其他格式的时候,不要用spark.read的形式直接导入到DataFrame。
那要咋弄 ?可以先用RDD把源数据加载进来,然后再转化成DataFrame,后面用SparkSQL进行操作,如此可达到较好的性能效果。
SparkSQL /DataFrame /Spark RDD谁快?的更多相关文章
- spark RDD,DataFrame,DataSet 介绍
弹性分布式数据集(Resilient Distributed Dataset,RDD) RDD是Spark一开始就提供的主要API,从根本上来说,一个RDD就是你的数据的一个不可变的分布式元素集合,在 ...
- Spark大型电商项目实战-及其改良(1) 比对sparkSQL和纯RDD实现的结果
代码存在码云:https://coding.net/u/funcfans/p/sparkProject/git 代码主要学习https://blog.csdn.net/u012318074/artic ...
- Spark RDD、DataFrame原理及操作详解
RDD是什么? RDD (resilientdistributed dataset),指的是一个只读的,可分区的分布式数据集,这个数据集的全部或部分可以缓存在内存中,在多次计算间重用. RDD内部可以 ...
- [Spark][Python][RDD][DataFrame]从 RDD 构造 DataFrame 例子
[Spark][Python][RDD][DataFrame]从 RDD 构造 DataFrame 例子 from pyspark.sql.types import * schema = Struct ...
- [Spark][Python][DataFrame][RDD]从DataFrame得到RDD的例子
[Spark][Python][DataFrame][RDD]从DataFrame得到RDD的例子 $ hdfs dfs -cat people.json {"name":&quo ...
- Spark RDD、DataFrame和DataSet的区别
版权声明:本文为博主原创文章,未经博主允许不得转载. 目录(?)[+] 转载请标明出处:小帆的帆的专栏 RDD 优点: 编译时类型安全 编译时就能检查出类型错误 面向对象的编程风格 直接通过类 ...
- Spark SQL概念学习系列之DataFrame与RDD的区别
不多说,直接上干货! DataFrame的推出,让Spark具备了处理大规模结构化数据的能力,不仅比原有的RDD转化方式更加简单易用,而且获得了更高的计算性能.Spark能够轻松实现从MySQL到Da ...
- Spark的dataframe转rdd通用工具类
需求解决问题 当每次读取hive表或者其他数据源,获取数据,相对其进行rdd操作,遇到任何类都需要df.rdd(row>row.getstring(0))去获取,就很麻烦,所以可以实现个通用的转 ...
- 【Spark-SQL学习之二】 SparkSQL DataFrame创建和储存
环境 虚拟机:VMware 10 Linux版本:CentOS-6.5-x86_64 客户端:Xshell4 FTP:Xftp4 jdk1.8 scala-2.10.4(依赖jdk1.8) spark ...
随机推荐
- 搭建高可用kubernetes集群(keepalived+haproxy)
序 由于单master节点的kubernetes集群,存在master节点异常之后无法继续使用的缺陷.本文参考网管流程搭建一套多master节点负载均衡的kubernetes集群.官网给出了两种拓扑结 ...
- 把若依管理系统部署到Linux
一.前言 1.非常感谢若依作者为大家提供的非常优质的开源web项目,非常感谢!!! 2.若依官方文档:http://doc.ruoyi.vip/ruoyi/ 3.若依官方链接: 1)若依管理系统官方体 ...
- 深入探究JVM之垃圾回收器
@ 目录 前言 正文 一.垃圾收集算法 标记-复制 标记-清除 标记-整理 分代回收 二.常用的垃圾回收器 Serial/SerialOld ParNew Parallel Scavenge/Para ...
- python beautifulsoup基本用法-文档结构
一.BeautifulSoup概述 BeautifulSoup是python的一个库,用于接收一个HTML或XML字符串并对其进行格式化,然后使用提供的方法快速查找指定元素. 使用BeautifulS ...
- PHPSTORM断点调试配置
一.安装Xdebug xdebug官方提供了一个非常友好的安装指导: https://xdebug.org/wizard.php 打开上面的网站,将你的phpinfo页面输出的内容复制到表单中,然后点 ...
- Zookeeper集群部署及报错分析
安装 下载压缩包 解压 修改zoo.cfg文件 创建myid文件 启动 自启动配置 有时间再补hhh 报错处理 很荣幸的遇到了大部分报错,日志再zookeeper目录的bin下的zookeeper.o ...
- SpringBoot整合Mail发送邮件&发送模板邮件
整合mail发送邮件,其实就是通过代码来操作发送邮件的步骤,编辑收件人.邮件内容.邮件附件等等.通过邮件可以拓展出短信验证码.消息通知等业务. 一.pom文件引入依赖 <dependency&g ...
- PHP array_diff() 函数
实例 比较两个数组的值,并返回差集: <?php $a1=array("a"=>"red","b"=>"gree ...
- PHP count_chars() 函数
实例 返回一个字符串,包含所有在 "Hello World!" 中使用过的不同字符(模式 3): <?php高佣联盟 www.cgewang.com$str = " ...
- Python Cookbook(第3版) 中文版 pdf完整版|网盘下载内附提取码
Python Cookbook(第3版)中文版介绍了Python应用在各个领域中的一些使用技巧和方法,其主题涵盖了数据结构和算法,字符串和文本,数字.日期和时间,迭代器和生成器,文件和I/O,数据编码 ...