
笔趣阁小说 selenium爬取
import re

from time import sleep

from lxml import etree

from selenium import webdriver

options = webdriver.ChromeOptions()

#options.add_argument('--headless')

options.add_argument(

    "User-Agent=Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/80.0.3987.149 Safari/537.36")

options.add_argument("Referer=https://s.weibo.com/")

options.add_argument('--no-sandbox')

options.add_argument('--disable-dev-shm-usage')

options.add_argument('blink-settings=imagesEnabled=false')

options.add_argument('--disable-gpu')

options.add_argument('--hide-scrollbars')  # 隐藏滚动条, 应对一些特殊页面

options.add_argument(

    'Cookie: ')

class Qidian:

    def __init__(self, url, driver):

        self.url = url

        self.driver = driver

        content = self.get_content(url)

        self.file_name = self.pase_file_name(content)

    def crawl_start(self):

        content = self.get_content(self.url)

        self.parse_detail(content)

    def get_content(self,url):

        self.driver.get(url)

        content = driver.page_source

        return content

    def pase_file_name(self, content):

        html = etree.HTML(content)

        file_info = html.xpath('//*[@id="info"]/h1/text()')

        file_name = file_info[0] + ".txt"

        return file_name

    def parse_detail(self, content):

        html = etree.HTML(content)

        ul = html.xpath('//div[@id="list"]/dl//dd')

        open(self.file_name, 'w')

        for li in ul:

            item = {}

            title = li.xpath('./a/text()')

            href = li.xpath('./a/@href')

            item['title'] = title[0]

            item['href'] = "http://www.biquge.info/0_273/" + href[0]

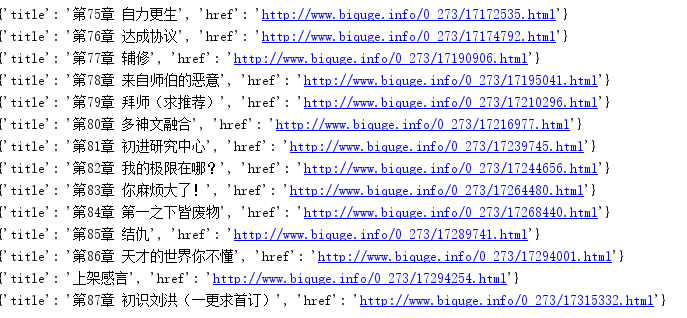
            print(item)

            driver.get(item['href'])

            html = etree.HTML(driver.page_source)

            details = html.xpath('//*[@id="content"]//text()')

            detail = ''.join(details)

            self.save_to_file(self.file_name, title[0], detail)

            sleep(3)

    def save_to_file(self, file_name, title, content):

        with open(file_name, 'a+') as f:

            f.write(title + '\n')

            f.write(content)

            f.write('\n')

            f.close()

if __name__ == "__main__":

    url = "http://www.biquge.info/0_273/"

    driver = webdriver.Chrome(options=options)

    try:

        qidian = Qidian(url, driver)

        qidian.crawl_start()

        driver.quit()

    except Exception as e:

        print(str(e))
笔趣阁小说 selenium爬取的更多相关文章
- python入门学习之Python爬取最新笔趣阁小说
Python爬取新笔趣阁小说,并保存到TXT文件中 我写的这篇文章,是利用Python爬取小说编写的程序,这是我学习Python爬虫当中自己独立写的第一个程序,中途也遇到了一些困难,但是最后 ...
- Jsoup-基于Java实现网络爬虫-爬取笔趣阁小说
注意!仅供学习交流使用,请勿用在歪门邪道的地方!技术只是工具!关键在于用途! 今天接触了一款有意思的框架,作用是网络爬虫,他可以像操作JS一样对网页内容进行提取 初体验Jsoup <!-- Ma ...
- bs4爬取笔趣阁小说
参考链接:https://www.cnblogs.com/wt714/p/11963497.html 模块:requests,bs4,queue,sys,time 步骤:给出URL--> 访问U ...
- 免app下载笔趣阁小说
第一次更新:发现一个问题,就是有时候网页排版有问题的话容易下载到多余章节,如下图所示: 网站抽风多了一个正文一栏,这样的话就会重复下载1603--1703章节. 解决办法: 于是在写入内容前加了一个章 ...
- Python爬取笔趣阁小说,有趣又实用
上班想摸鱼?为了摸鱼方便,今天自己写了个爬取笔阁小说的程序.好吧,其实就是找个目的学习python,分享一下. 1. 首先导入相关的模块 import os import requests from ...
- scrapycrawl 爬取笔趣阁小说
前言 第一次发到博客上..不太会排版见谅 最近在看一些爬虫教学的视频,有感而发,大学的时候看盗版小说网站觉得很能赚钱,心想自己也要搞个,正好想爬点小说能不能试试做个网站(网站搭建啥的都不会...) 站 ...
- python应用:爬虫框架Scrapy系统学习第四篇——scrapy爬取笔趣阁小说
使用cmd创建一个scrapy项目: scrapy startproject project_name (project_name 必须以字母开头,只能包含字母.数字以及下划线<undersco ...
- HttpClients+Jsoup抓取笔趣阁小说,并保存到本地TXT文件
前言 首先先介绍一下Jsoup:(摘自官网) jsoup is a Java library for working with real-world HTML. It provides a very ...
- scrapy框架爬取笔趣阁
笔趣阁是很好爬的网站了,这里简单爬取了全部小说链接和每本的全部章节链接,还想爬取章节内容在biquge.py里在加一个爬取循环,在pipelines.py添加保存函数即可 1 创建一个scrapy项目 ...
随机推荐
- oracle之复杂查询之一:多表连接技术
复杂查询之一:多表连接技术 7.1 简单查询的解析方法: 全表扫描:指针从第一条记录开始,依次逐行处理,直到最后一条记录结束: 横向选择+纵向投影=结果集 7.2 多表连接 交叉连接(笛卡尔积) 非等 ...
- 2017年PHP程序员未来路在何方(转)
PHP 从诞生到现在已经有20多年历史,从Web时代兴起到移动互联网退潮,互联网领域各种编程语言和技术层出不穷, Node.js . GO . Python 不断地在挑战 PHP 的地位.这些技术的推 ...
- v-charts 绘制柱状图、条形图、水球图、雷达图、折线图+柱状图,附官网地址
v-charts 官网地址:https://v-charts.js.org/#/ 柱状图: <template> <ve-histogram :data="chartDat ...
- Vant IndexBar 在小程序中的简单使用
这篇文章是老王的朋友超超提供的,上午已经更新到原创微信公众号「软件老王」,链接,欢迎各位朋友关注老王的原创公号! 先看下最终效果图,主要是渲染一个A - Z 的 通讯录.同样的,如果你要做的是城市列表 ...
- python文档翻译之概述
Python是一个使用方便且功能强大的变成语言.它具有高效的高级数据结构和面向对象编程特性.其优雅的语法.动态类型.解释型特性使得它成为大多数平台上脚本和快速应用程序开发的理想语言. Python解释 ...
- 在浏览器输入 URL 回车之后发生了什么(超详细版)
前言 这个问题已经是老生常谈了,更是经常被作为面试的压轴题出现,网上也有很多文章,但最近闲的无聊,然后就自己做了一篇笔记,感觉比之前理解更透彻了. 这篇笔记是我这两天看了数十篇文章总结出来的,所以相对 ...
- Spring Cloud Alibaba生态探索:Dubbo、Nacos及Sentinel的完美结合
@ 目录 背景 一.项目框架 1.1 采用IDEA和Maven多模块进行项目搭建 1.2 模块管理及版本管理 二.微服务公共接口 2.1 定义一个公共接口Api 2.2 pom.xml 2.3 Goo ...
- python-逻辑结构操作
0x01 大纲 逻辑结构 list dict 判断if else elif break continue while 0x02 添加 list = [i for i in range(0,10)] p ...
- Spring学习(六)bean装配详解之 【通过注解装配 Bean】【基础配置方式】
通过注解装配 Bean 1.前言 优势 1.可以减少 XML 的配置,当配置项多的时候,XML配置过多会导致项目臃肿难以维护 2.功能更加强大,既能实现 XML 的功能,也提供了自动装配的功能,采用了 ...
- Python爬虫之反爬虫---使用随机User-Agent
在编写爬虫时,大多数情况下,需要设置请求头.而在请求头中,随机更换User-Agent可以避免触发相应的反爬机制. 使用第三方库fake-useragent便可轻松生成随机User-Agent. 使用 ...