
pytorch识别CIFAR10:训练ResNet-34(自定义transform,动态调整学习率,准确率提升到94.33%)
版权声明:本文为博主原创文章,欢迎转载,并请注明出处。联系方式:460356155@qq.com
前面通过数据增强,ResNet-34残差网络识别CIFAR10,准确率达到了92.6。
这里对训练过程增加2个处理:
1、训练数据集做进一步处理:对图片随机加正方形马赛克。
2、每50个epoch,学习率降低0.1倍。
代码具体修改如下:
自定义transform:
 class Cutout(object):

     def __init__(self, hole_size):

         # 正方形马赛克的边长,像素为单位

         self.hole_size = hole_size

     def __call__(self, img):

         return cutout(img, self.hole_size)

 def cutout(img, hole_size):

     y = np.random.randint(32)

     x = np.random.randint(32)

     half_size = hole_size // 2

     x1 = np.clip(x - half_size, 0, 32)

     x2 = np.clip(x + half_size, 0, 32)

     y1 = np.clip(y - half_size, 0, 32)

     y2 = np.clip(y + half_size, 0, 32)

     imgnp = np.array(img)

     imgnp[y1:y2, x1:x2] = 0

     img = Image.fromarray(imgnp.astype('uint8')).convert('RGB')

     return img
数据集处理修改:
     transform_train = transforms.Compose([

         # 对原始32*32图像四周各填充4个0像素(40*40),然后随机裁剪成32*32

         transforms.RandomCrop(32, padding=4),

         # 随机马赛克,大小为6*6

         Cutout(6),

         # 按0.5的概率水平翻转图片

         transforms.RandomHorizontalFlip(),

         transforms.ToTensor(),

         transforms.Normalize([0.5, 0.5, 0.5], [0.5, 0.5, 0.5])])

     transform_test = tv.transforms.Compose([

         transforms.ToTensor(),

         transforms.Normalize([0.5, 0.5, 0.5], [0.5, 0.5, 0.5])])

     # 定义数据集

     train_data = tv.datasets.CIFAR10(root=ROOT, train=True, download=True, transform=transform_train)

     test_data = tv.datasets.CIFAR10(root=ROOT, train=False, download=False, transform=transform_test)
训练过程中调整学习率:
     for epoch in range(1, args.epochs + 1):

         if epoch % 50 == 0:

             lr = args.lr * (0.1 ** (epoch // 50))

             for params in optimizer.param_groups:

                 params['lr'] = lr

         net_train(net, train_load, optimizer, epoch, args.log_interval)

         # 每个epoch结束后用测试集检查识别准确度

         net_test(net, test_load, epoch)
运行结果如下:
Files already downloaded and verified
ResNet34(
(first): Sequential(
(0): Conv2d(3, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(1): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(2): ReLU(inplace)
(3): MaxPool2d(kernel_size=3, stride=1, padding=1, dilation=1, ceil_mode=False)
)
(layer1): Sequential(
(0): ResBlock(
(conv1): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn1): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(relu): ReLU(inplace)
(conv2): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn2): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
)
(1): ResBlock(
(conv1): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn1): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(relu): ReLU(inplace)
(conv2): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn2): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
)
(2): ResBlock(
(conv1): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn1): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(relu): ReLU(inplace)
(conv2): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn2): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
)
)
(layer2): Sequential(
(0): ResBlock(
(conv1): Conv2d(64, 128, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1))
(bn1): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(relu): ReLU(inplace)
(conv2): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn2): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(downsample): Sequential(
(0): Conv2d(64, 128, kernel_size=(1, 1), stride=(2, 2))
(1): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
)
)
(1): ResBlock(
(conv1): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn1): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(relu): ReLU(inplace)
(conv2): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn2): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
)
(2): ResBlock(
(conv1): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn1): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(relu): ReLU(inplace)
(conv2): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn2): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
)
(3): ResBlock(
(conv1): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn1): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(relu): ReLU(inplace)
(conv2): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn2): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
)
)
(layer3): Sequential(
(0): ResBlock(
(conv1): Conv2d(128, 256, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1))
(bn1): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(relu): ReLU(inplace)
(conv2): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn2): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(downsample): Sequential(
(0): Conv2d(128, 256, kernel_size=(1, 1), stride=(2, 2))
(1): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
)
)
(1): ResBlock(
(conv1): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn1): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(relu): ReLU(inplace)
(conv2): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn2): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
)
(2): ResBlock(
(conv1): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn1): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(relu): ReLU(inplace)
(conv2): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn2): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
)
(3): ResBlock(
(conv1): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn1): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(relu): ReLU(inplace)
(conv2): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn2): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
)
(4): ResBlock(
(conv1): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn1): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(relu): ReLU(inplace)
(conv2): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn2): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
)
(5): ResBlock(
(conv1): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn1): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(relu): ReLU(inplace)
(conv2): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn2): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
)
)
(layer4): Sequential(
(0): ResBlock(
(conv1): Conv2d(256, 512, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1))
(bn1): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(relu): ReLU(inplace)
(conv2): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn2): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(downsample): Sequential(
(0): Conv2d(256, 512, kernel_size=(1, 1), stride=(2, 2))
(1): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
)
)
(1): ResBlock(
(conv1): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn1): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(relu): ReLU(inplace)
(conv2): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn2): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
)
(2): ResBlock(
(conv1): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn1): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(relu): ReLU(inplace)
(conv2): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(bn2): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
)
)
(avg_pool): AvgPool2d(kernel_size=4, stride=4, padding=0)
(fc): Linear(in_features=512, out_features=10, bias=True)
)
one epoch spend: 0:01:11.775634
EPOCH:1, ACC:44.28
one epoch spend:
0:01:12.244757
EPOCH:2, ACC:54.46
one epoch spend:
0:01:12.360205
EPOCH:3, ACC:56.84
............
one epoch spend: 0:01:19.172188
EPOCH:198, ACC:94.2
one epoch spend:
0:01:19.213334
EPOCH:199, ACC:94.19
one epoch spend:
0:01:19.222612
EPOCH:200, ACC:94.21
CIFAR10 pytorch
ResNet34 Train: EPOCH:200, BATCH_SZ:128, LR:0.1, ACC:94.33
train spend time:
4:21:32.548834
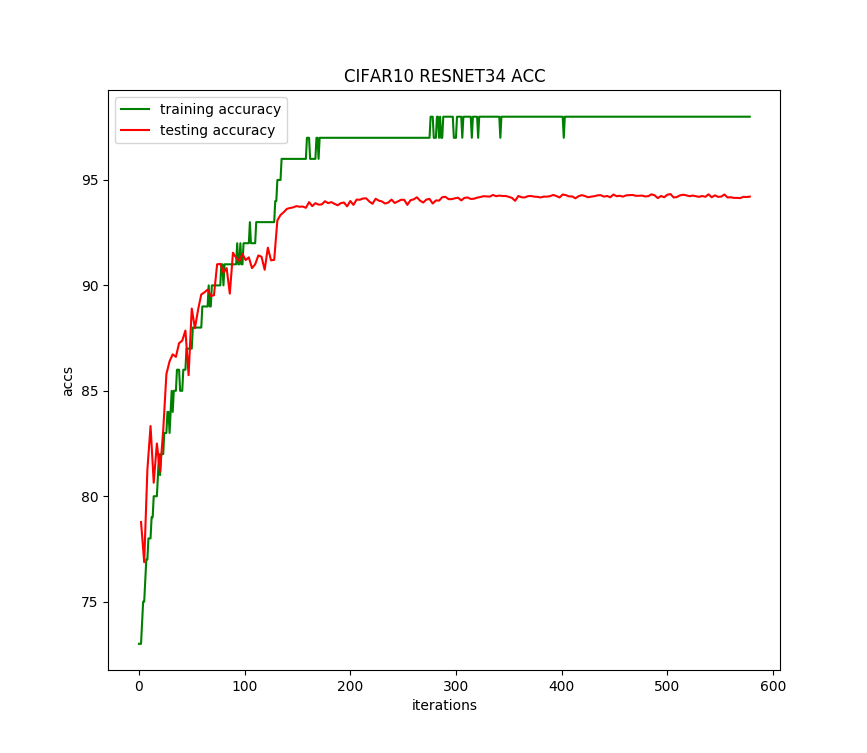
运行200个迭代,每个迭代耗时80秒,准确率提升了1.73%,达到94.33%。准确率变化曲线如下:
pytorch识别CIFAR10:训练ResNet-34(自定义transform,动态调整学习率,准确率提升到94.33%)的更多相关文章
- pytorch识别CIFAR10:训练ResNet-34(准确率80%)
版权声明:本文为博主原创文章,欢迎转载,并请注明出处.联系方式:460356155@qq.com CNN的层数越多,能够提取到的特征越丰富,但是简单地增加卷积层数,训练时会导致梯度弥散或梯度爆炸. 何 ...
- pytorch识别CIFAR10:训练ResNet-34(数据增强,准确率提升到92.6%)
版权声明:本文为博主原创文章,欢迎转载,并请注明出处.联系方式:460356155@qq.com 在前一篇中的ResNet-34残差网络,经过减小卷积核训练准确率提升到85%. 这里对训练数据集做数据 ...
- pytorch识别CIFAR10:训练ResNet-34(微调网络,准确率提升到85%)
版权声明:本文为博主原创文章,欢迎转载,并请注明出处.联系方式:460356155@qq.com 在前一篇中的ResNet-34残差网络,经过训练准确率只达到80%. 这里对网络做点小修改,在最开始的 ...
- pytorch 动态调整学习率 重点
深度炼丹如同炖排骨一般,需要先大火全局加热,紧接着中火炖出营养,最后转小火收汁.本文给出炼丹中的 “火候控制器”-- 学习率的几种调节方法,框架基于 pytorch 1. 自定义根据 epoch 改变 ...
- 深度学习识别CIFAR10:pytorch训练LeNet、AlexNet、VGG19实现及比较(二)
版权声明:本文为博主原创文章,欢迎转载,并请注明出处.联系方式:460356155@qq.com AlexNet在2012年ImageNet图像分类任务竞赛中获得冠军.网络结构如下图所示: 对CIFA ...
- 深度学习识别CIFAR10:pytorch训练LeNet、AlexNet、VGG19实现及比较(三)
版权声明:本文为博主原创文章,欢迎转载,并请注明出处.联系方式:460356155@qq.com VGGNet在2014年ImageNet图像分类任务竞赛中有出色的表现.网络结构如下图所示: 同样的, ...
- PyTorch Tutorials 4 训练一个分类器
%matplotlib inline 训练一个分类器 上一讲中已经看到如何去定义一个神经网络,计算损失值和更新网络的权重. 你现在可能在想下一步. 关于数据? 一般情况下处理图像.文本.音频和视频数据 ...
- Pytorch多GPU训练
Pytorch多GPU训练 临近放假, 服务器上的GPU好多空闲, 博主顺便研究了一下如何用多卡同时训练 原理 多卡训练的基本过程 首先把模型加载到一个主设备 把模型只读复制到多个设备 把大的batc ...
- CNN+BLSTM+CTC的验证码识别从训练到部署
项目地址:https://github.com/kerlomz/captcha_trainer 1. 前言 本项目适用于Python3.6,GPU>=NVIDIA GTX1050Ti,原mast ...
随机推荐
- redis的hash类型!!!!
Hash类型 redsi的hash是基本类型之一,键值本身又是一对键值结构,是string类型的field和value的映射表,或者说是集合,适合存储对象. Hash的增操作 127.0.0.1:63 ...
- 简单实现springmvc框架(servlet+自定义注解)
个人水平比较菜,没有这么高的实力简单实现springmvc框架,我是看了一个老哥的博客,这老哥才是大神! 原文链接:https://www.cnblogs.com/xdp-gacl/p/4101727 ...
- Python:黑板课爬虫闯关第一关
近日发现了[黑板课爬虫闯关]这个神奇的网页,练手爬虫非常的合适 地址:http://www.heibanke.com/lesson/crawler_ex00/ 第一关非常的简单 get 请求网址,在响 ...
- redis的持久化方式RDB和AOF的区别
1.前言 最近在项目中使用到Redis做缓存,方便多个业务进程之间共享数据.由于Redis的数据都存放在内存中,如果没有配置持久化,redis重启后数据就全丢失了,于是需要开启redis的持久化功能, ...
- mysql-8.0 安装教程(自定义配置文件,密码方式已修改)
下载zip安装包: MySQL8.0 For Windows zip包下载地址:https://dev.mysql.com/downloads/file/?id=476233,进入页面后可以不登录.后 ...
- Java虚拟机垃圾收集算法
1.标记-清除算法 标记-清除算法分为 "标记" 和 "清除" 两个步骤:首先标记出所有需要回收的对象,然后在标记完成后统一回收所有被标记的对象,是垃圾收集算法 ...
- PHP制作个人博客-广告位添加与调用 推荐文章数据调取
上一节博客的导航我们已经动态调取,这一节我们主讲一下如何根据页面布局,后台添加广告位,及模板上动态调取广告.博客推荐文章的数据调用. 首先我们在云码博客的后台添加10条左右的测试数据,thinkcmf ...
- H5、C3、ES6的新特性
H5的新特性 1.语义化标签 有利于SEO,有助于爬虫抓取更多的有效信息,爬虫是依赖于标签来确定上下文和各个关键字的权重. 语义化的HTML在没有CSS的情况下也能呈现较好的内容结构与代码结构 方便其 ...
- layui 轮播图动态数据不显示问题
layui.use('carousel', function() { var carousel = layui.carousel; var ins = carousel.render({ elem: ...
- 看完我身边前卫时尚女孩的手机 这几款APP强烈推荐
爱美之心,人皆有之,爱美是所有人生追求里最有价值的生活状态,美是一种能力,更是一种修养,懂得打扮自己的女人更受欢迎 因为她们懂得什么是美.想要变美的女孩们不要着急,下面几款爱美工具定会让你一见钟情. ...