
<爬虫>利用BeautifulSoup爬取百度百科虚拟人物资料存入Mysql数据库
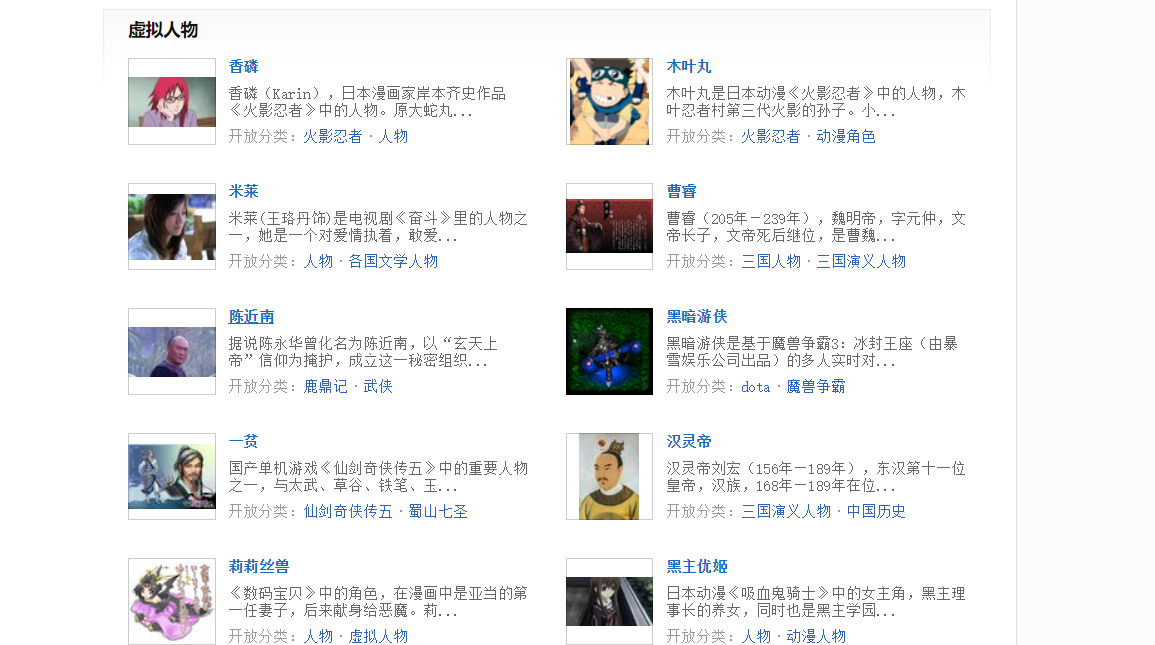
网页情况:
代码:
import requests

from requests.exceptions import RequestException

from bs4 import BeautifulSoup as bs

import re

import time

import pymysql

def get_one_page(url):

    #得到一页的内容

    try:

        headers  = {

            'user-agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/68.0.3440.106 Safari/537.36'

        }

        response = requests.get(url,headers=headers)

        response.encoding = 'utf-8'

        if response.status_code == 200:

            return response.text

        return None

    except RequestException:

        return None

def parse_one_page(html):

    #使用BeautifuSoup解析一页的内容

    soup = bs(html,'lxml')

    for data in soup.find_all('div',class_="photo"):

        name = data.a['title']

        href = "https://baike.baidu.com"+data.a['href']

        img = data.img['src']

        #有些人物没有图片,图片链接有误需要拼接

        if re.search("^/static",img):

            img ="https://baike.baidu.com" + img

        yield {

            'name':name,

            'href':href,

            'img':img

        }

def write_mysql(item):

    #写入Mysql数据库

    conn = pymysql.connect(

        host='localhost',

        user='root',

        password='',

        database='baidu',

        charset='utf8'  # 别写成utf-8

    )

    cursor = conn.cursor()  # 建立游标

    sql = "insert into baidu_baike(name,href,img) values(%s,%s,%s)"

    cursor.execute(sql,(item['name'],item['href'],item['img']))  # 注意excute的位置参数的问题

    conn.commit()  # 修改值的时候,一定需要commit

    cursor.close()  # 关闭

    conn.close()  # 关闭

def main(url):

    #主函数

    html = get_one_page(url)

    items = parse_one_page(html)

    for item in items:

        write_mysql(item)

if __name__ == '__main__':

    #分析URL构成,拼接URL

    for i in range(1,7):

        url = "http://baike.baidu.com/fenlei/虚拟人物?limit=30&index=" + str(i) + "&offset=" + str(

            30 * (int(i) - 1)) + "# gotoList"

        main(url)

        print('正在爬取第%s页'%i)

        time.sleep(1)

    print("全部写入成功!")
运行结果:
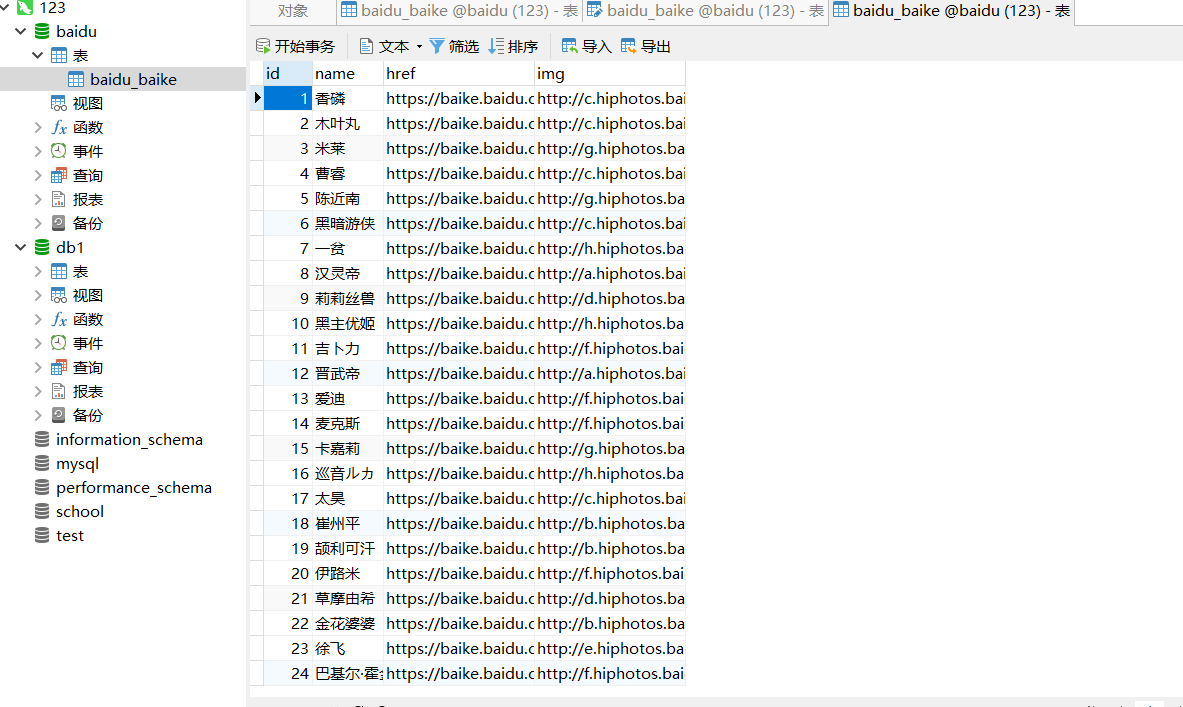
mysql数据库结果:
<爬虫>利用BeautifulSoup爬取百度百科虚拟人物资料存入Mysql数据库的更多相关文章
- python简单爬虫 用beautifulsoup爬取百度百科词条
目标:爬取“湖南大学”百科词条并处理数据 需要获取的数据: 源代码: <div class="basic-info cmn-clearfix"> <dl clas ...
- 爬虫实战(一) 用Python爬取百度百科
最近博主遇到这样一个需求:当用户输入一个词语时,返回这个词语的解释 我的第一个想法是做一个数据库,把常用的词语和词语的解释放到数据库里面,当用户查询时直接读取数据库结果 但是自己又没有心思做这样一个数 ...
- Python开发简单爬虫(二)---爬取百度百科页面数据
一.开发爬虫的步骤 1.确定目标抓取策略: 打开目标页面,通过右键审查元素确定网页的url格式.数据格式.和网页编码形式. ①先看url的格式, F12观察一下链接的形式;② 再看目标文本信息的标签格 ...
- Python——爬取百度百科关键词1000个相关网页
Python简单爬虫——爬取百度百科关键词1000个相关网页——标题和简介 网站爬虫由浅入深:慢慢来 分析: 链接的URL分析: 数据格式: 爬虫基本架构模型: 本爬虫架构: 源代码: # codin ...
- Python爬虫实战之爬取百度贴吧帖子
大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 本篇目标 对百度贴吧的任意帖子进行抓取 指定是否只抓取楼主发帖 ...
- 从0开始学爬虫8使用requests/pymysql和beautifulsoup4爬取维基百科词条链接并存入数据库
从0开始学爬虫8使用requests和beautifulsoup4爬取维基百科词条链接并存入数据库 Python使用requests和beautifulsoup4爬取维基百科词条链接并存入数据库 参考 ...
- Python爬取招聘信息,并且存储到MySQL数据库中
前面一篇文章主要讲述,如何通过Python爬取招聘信息,且爬取的日期为前一天的,同时将爬取的内容保存到数据库中:这篇文章主要讲述如何将python文件压缩成exe可执行文件,供后面的操作. 这系列文章 ...
- python爬虫—爬取百度百科数据
爬虫框架:开发平台 centos6.7 根据慕课网爬虫教程编写代码 片区百度百科url,标题,内容 分为4个模块:html_downloader.py 下载器 html_outputer.py 爬取数 ...
- java 如何爬取百度百科词条内容(java如何使用webmagic爬取百度词条)
这是老师所布置的作业 说一下我这里的爬去并非能把百度词条上的内容一字不漏的取下来(而是它分享链接的一个主要内容概括...)(他的主要内容我爬不到 也不想去研究大家有好办法可以call me) 例如 互 ...
随机推荐
- Android开发 navigation入门详解
前言 Google 在2018年推出了 Android Jetpack,在Jetpack里有一种管理fragment的新架构模式,那就是navigation. 字面意思是导航,但是除了做APP引导页面 ...
- 安装rancher以及使用rancher倒入kubernetes集群和添加及管理集群
1.docker安装rancher [root@rancher ~]# docker run -d --name rancher --restart=unless-stopped -p : -p : ...
- 跨域问题The value of the 'Access-Control-Allow-Origin' header in the response must not be the wildcard '*' when the request's credentials mode is 'include'. The credentials mode of requests initiated by t
withCredentials 属性 上面说到,CORS请求默认不发送Cookie和HTTP认证信息.如果要把Cookie发到服务器,一方面要服务器同意,指定Access-Control-Allow- ...
- springMVC 400 错误
1. 今天发现一个奇葩的问题, springMVC出现400错误, 查了很久发现是因为一个参数为int型,而前台传得是String. 这是bug么.
- PandorBox 中安装aria2失败的解决办法
来自:http://www.right.com.cn/forum/thread-174358-1-1.html 不论luci界面还是opkg中安装,都提示缺少依赖包uclibc,pandorabox默 ...
- Eclipse 连接MySql数据库总结
Eclipse 连接MySql数据库总结 一.在MySql中创建数据库,并创建表,向表中插入数据 1.创建数据库 create database select_test 2.创建表 create ta ...
- ajax无刷新上传
我们在使用上传控件的时候,会遇到刷新的问题,最近使用ajax做的上传,觉得效果还是很不错. 首先,我们需要在页面上放上上传控件:需要注意的是,我们必须放在form里面,实现表单上传. <for ...
- 一次bug死磕经历之Hbase堆内存小导致regionserver频繁挂掉
环境如下: Centos6.5 Apache Hadoop2.7.1 Apache Hbase0.98.12 Apache Zookeeper3.4.6 JDK1.7 Ant1.9.5 Maven3. ...
- linux系统使用小记
1.解决Ubuntu不能正常使用vi的问题.sudo apt-get remove vim-common sudo apt-get install vim 2.备份linux系统,注意,有的优盘单 ...
- 【学术篇】oj.jzxx.net2701 无根树
这是一道来自OIerBBS的题目.. 原帖地址:http://www.oierbbs.com/forum.php?mod=viewthread&tid=512?fromuid=71 (似乎是个 ...