
爬取博主的所有文章并保存为PDF文件
继续改进上一个项目,上次我们爬取了所有文章,但是保存为TXT文件,查看不方便,而且还无法保存文章中的代码和图片。
所以这次保存为PDF文件,方便查看。
需要的工具:
1、wkhtmltopdf安装包,下载并安装到电脑上,可使用 pip安装 ,注意环境变量的配置。具体参见下面的资料。
2、pdfkit文件(whl文件),下载并安装到pycharm上。
注意安装 whl 文件时:最好吧把 保存 whl文件的文件夹的路径 D:\learning python\Scripts 添加到环境变量里面,然后在此文件夹下打开cmd,直接 pip install XXX.whl 即可。
调用顺序:程序代码会使用pdfkit,pdfkit会调用wkhtmltopdf,而wkhtmltopdf会调用windows中的wkhtmltopdf.exe来转化html为pdf。
1、在我们原理项目的基础上,修改 get_body 方法,直接返回str(div),而不是div.text。
def get_body(url):

    """

    获取url下文章的正文内容

    :param url:

    :return:

    """

    html_page = get_html(url)

    soup = BeautifulSoup(html_page,'html.parser')   #HTML文档解析器

    div = soup.find(id = "cnblogs_post_body")

    return str(div)
2、然后就是主要的下载方法了:
和之前一样,先创建一个文件夹,然后吧PDF文件下载到刚刚创建的文件夹下面。
def save_single_file_to_PDF(url):

    """

    首先在py文件同目录下创建一个以博主名字为名的文件,用来存放爬取的所有文章

    将文章正文保存在txt文件中,名字为文章标题

    有些文章的标题可能不适合直接作为txt文件名,我们可以忽略这些文章

    :param url:

    :return:

    """

    global article_count    #使用全局变量,需要在函数中进行标识

    title = get_title(url)

    body = get_body(url)

    #获取当前目录文件,截取目录后,并自动创建文件

    FILE_PATH = os.getcwd()[:-0]+author

    if not os.path.exists(FILE_PATH):

        os.makedirs(FILE_PATH)

    options = {

        'page-size':'Letter',

        'encoding':"UTF-8",

        'custom-header':[('Accept-Encoding','gzip')]

    }

    try:

        filename = title + '.pdf'

        # 由于wkhtmltopdf软件的版本问题,只能手动设置软件目录,不然无法调用该软件。

        config = pdfkit.configuration(wkhtmltopdf=r"D:\learning python\wkhtmltopdf\bin\wkhtmltopdf.exe")

        #输出PDF文件

        pdfkit.from_string(body, 'D:\learning python\coding_python3.6\cnblog\\Andrew\\'+filename, options=options, configuration=config)

        article_count += 1  # 计数变量加1,统计总的下载文件数

        print(filename + "  file have saved...")     #提示文章下载完毕

    except:

        pass
但是需要注意的是:如果以上步骤有缺失,可能碰到的问题是:

1.关于no such file or directory:b'' 这种错误在python中出现时,意味着有.exe文件需要被调用,
而该.exe文件没有被安装或者在控制面板的环境变量中没有添加该.exe的路径。另外,有时候需要改pdfkit代码为下列两句,才可消除错误:
        # 由于wkhtmltopdf软件的版本问题,只能手动设置软件目录,不然无法调用该软件。

        config = pdfkit.configuration(wkhtmltopdf=r"D:\learning python\wkhtmltopdf\bin\wkhtmltopdf.exe")

        #输出PDF文件

        pdfkit.from_string(body, 'D:\learning python\coding_python3.6\cnblog\\Andrew\\'+filename, options=options, configuration=config)
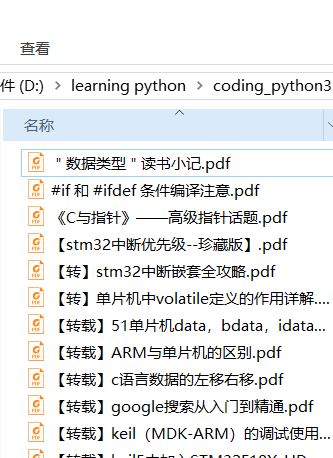
运行结果:
项目完整代码:我的码云
参考资料:
项目启发:http://www.cnblogs.com/xingzhui/p/7887212.html
pdfkit安装:https://blog.csdn.net/appleyuchi/article/details/70947138
爬取博主的所有文章并保存为PDF文件的更多相关文章
- python:爬取博主的所有文章的链接、标题和内容
以爬取我自己的博客为例:https://www.cnblogs.com/Mr-choa/ 1.获取所有的文章的链接: 博客文章总共占两页,比如打开第一页:https://www.cnblogs.com ...
- python爬取博客圆首页文章链接+标题
新人一枚,初来乍到,请多关照 来到博客园,不知道写点啥,那就去瞄一瞄大家都在干什么好了. 使用python 爬取博客园首页文章链接和标题. 首先当然是环境了,爬虫在window10系统下,python ...
- 使用Python爬取微信公众号文章并保存为PDF文件(解决图片不显示的问题)
前言 第一次写博客,主要内容是爬取微信公众号的文章,将文章以PDF格式保存在本地. 爬取微信公众号文章(使用wechatsogou) 1.安装 pip install wechatsogou --up ...
- 爬取博主所有文章并保存到本地(.txt版)--python3.6
闲话: 一位前辈告诉我大学期间要好好维护自己的博客,在博客园发布很好,但是自己最好也保留一个备份. 正好最近在学习python,刚刚从py2转到py3,还有点不是很习惯,正想着多练习,于是萌生了这个想 ...
- 爬虫---lxml爬取博客文章
上一篇大概写了下lxml的用法,今天我们通过案例来实践,爬取我的博客博客并保存在本地 爬取博客园博客 爬取思路: 1.首先找到需要爬取的博客园地址 2.解析博客园地址 # coding:utf-8 i ...
- Scrapy爬取伯乐在线的所有文章
本篇文章将从搭建虚拟环境开始,爬取伯乐在线上的所有文章的数据. 搭建虚拟环境之前需要配置环境变量,该环境变量的变量值为虚拟环境的存放目录 1. 配置环境变量 2.创建虚拟环境 用mkvirtualen ...
- 『Scrapy』爬取斗鱼主播头像
分析目标 爬取的是斗鱼主播头像,示范使用的URL似乎是个移动接口(下文有提到),理由是网页主页属于动态页面,爬取难度陡升,当然爬取斗鱼主播头像这么恶趣味的事也不是我的兴趣...... 目标URL如下, ...
- python连续爬取多个网页的图片分别保存到不同的文件夹
python连续爬取多个网页的图片分别保存到不同的文件夹 作者:vpoet mail:vpoet_sir@163.com #coding:utf-8 import urllib import ur ...
- python爬取当当网的书籍信息并保存到csv文件
python爬取当当网的书籍信息并保存到csv文件 依赖的库: requests #用来获取页面内容 BeautifulSoup #opython3不能安装BeautifulSoup,但可以安装Bea ...
随机推荐
- 安装MySQL-python: EnvironmentError:mysql config not found
1执行 sudo yum install python-devel 2 find / -name mysql_config 在/usr/bin/下发现了这个文件 3. 后修改MySQL-python- ...
- php扩展yaf 按照配置
Yaf,全称 Yet Another Framework,是一个C语言编写的PHP框架,是一个用PHP扩展形式提供的PHP开发框架, 相比于一般的PHP框架, 它更快. 它提供了Bootstrap, ...
- Java获取一维数组的最小值
编写程序,实现接受用户在文本框中输入的单行数据.这些数据都是整数数字,以空格进行分隔,空格数量不限.并将这些数据分割成一维数组,再从数组中提取最小值显示在界面中.思路是先对用户的输入进行验证,即先用t ...
- JVM内存结构与GC
JVM内存模型总体架构图 程序计数器多线程时,当线程数超过CPU数量或CPU内核数量,线程之间就要根据时间片轮询抢夺CPU时间资源.因此每个线程有要有一个独立的程序计数器,记录下一条要运行的指令.线程 ...
- Linux+Redis实战教程_day02_Linux系统上安装MySQL
Linux系统上安装MySQL 安装MySQL 卸载自带mysql 查询mysql的安装情况,可以直接使用了 rpm -qa | grep -i mysql –-color 卸载原生的MySQL rp ...
- Lab6: Paxos
Introduction In labs 6 and 7, you will replicate the lock service using the replicated state machine ...
- 使用 requests 维持会话
什么是 Cookie 和 Session: 简单来说,我们访问每一个互联网页面,都是通过 HTTP 协议进行的,而 HTTP 协议是一个无状态协议,所谓的无状态协议即无法维持会话之间的状态.比如,仅使 ...
- 分析JobInProgress中Map/Reduce任务分配
1.JobTracker能否决定给当前的TaskTracker节点分配一个Job的具体的哪一个任务? 2.什么是map本地任务? 3.nonRunningMapCache的作用是什么? 4.从Task ...
- mybatis 之 resultType="HashMap" parameterType="list"
public ServiceMessage<List<Map<String, Object>>> queryGoodsStockInfo(List<Long& ...
- 《利用Python 进行数据分析》 - 笔记(4)----json
解决方案: 读写文本格式的数据: pandas 提供了一些用于将表格型数据读取为DataFrame对象的函数 pandas 中的解析函数 函数的选项可以划分为以下几个大类 索引:将一个或多个列当做返回 ...