
TensorFlow自编码器(AutoEncoder)之MNIST实践
自编码器可以用于降维,添加噪音学习也可以获得去噪的效果。
以下使用单隐层训练mnist数据集,并且共享了对称的权重参数。
模型本身不难,调试的过程中有几个需要注意的地方:
- 模型对权重参数初始值敏感,所以这里对权重参数w做了一些限制
- 需要对数据标准化
- 学习率设置合理(Adam,0.001)
1,建立模型
import numpy as np

import tensorflow as tf

class AutoEncoder(object):

    '''

    使用对称结构,解码器重用编码器的权重参数

    '''

    def __init__(self, input_shape, h1_size, lr):

        tf.reset_default_graph()# 重置默认计算图,有时出错后内存还一团糟

        with tf.variable_scope('auto_encoder', reuse=tf.AUTO_REUSE):

            self.W1 = self.weights(shape=(input_shape, h1_size), name='h1')

            self.b1 = self.bias(h1_size)

            self.W2 = tf.transpose(tf.get_variable('h1'))  # 共享参数,使用其转置

            self.b2 = self.bias(input_shape)

        self.lr = lr

        self.input = tf.placeholder(shape=(None, input_shape),

                                    dtype=tf.float32)

        self.h1_out = tf.nn.softplus(tf.matmul(self.input, self.W1) + self.b1)# softplus,类relu

        self.out = tf.matmul(self.h1_out, self.W2) + self.b2

        self.optimizer = tf.train.AdamOptimizer(learning_rate=self.lr)

        self.loss = 0.1 * tf.reduce_sum(

            tf.pow(tf.subtract(self.input, self.out), 2))

        self.train_op = self.optimizer.minimize(self.loss)

        self.sess = tf.Session()

        self.sess.run(tf.global_variables_initializer())

    def fit(self, X, epoches=100, batch_size=128, epoches_to_display=10):

        batchs_per_epoch = X.shape[0] // batch_size

        for i in range(epoches):

            epoch_loss = []

            for j in range(batchs_per_epoch):

                X_train = X[j * batch_size:(j + 1) * batch_size]

                loss, _ = self.sess.run([self.loss, self.train_op],

                                        feed_dict={self.input: X_train})

                epoch_loss.append(loss)

            if i % epoches_to_display == 0:

                print('avg_loss at epoch %d :%f' % (i, np.mean(epoch_loss)))

#         return self.sess.run(W1)

#     权重初始化参考别人的,这个居然很重要!用自己设定的截断正态分布随机没有效果

    def weights(self, shape, name, constant=1):

        fan_in = shape[0]

        fan_out = shape[1]

        low = -constant * np.sqrt(6.0 / (fan_in + fan_out))

        high = constant * np.sqrt(6.0 / (fan_in + fan_out))

        init = tf.random_uniform_initializer(minval=low, maxval=high)

        return tf.get_variable(name=name,

                               shape=shape,

                               initializer=init,

                               dtype=tf.float32)

    def bias(self, size):

        return tf.Variable(tf.constant(0, dtype=tf.float32, shape=[size]))

    def encode(self, X):

        return self.sess.run(self.h1_out, feed_dict={self.input: X})

    def decode(self, h):

        return self.sess.run(self.out, feed_dict={self.h1_out: h})

    def reconstruct(self, X):

        return self.sess.run(self.out, feed_dict={self.input: X})
2,加载数据及预处理
from keras.datasets import mnist

(X_train, y_train), (X_test, y_test) = mnist.load_data()

import random

X_train = X_train.reshape(-1, 784)

# 测试集里随机10个图片用做测试

test_idxs = random.sample(range(X_test.shape[0]), 10)

data_test = X_test[test_idxs].reshape(-1, 784)

# 标准化

import sklearn.preprocessing as prep

processer = prep.StandardScaler().fit(X_train) # 这里还是用全部数据好,这个也很关键!

X_train = processer.transform(X_train)

X_test = processer.transform(data_test)

# 随机5000张图片用做训练

idxs = random.sample(range(X_train.shape[0]), 5000)

data_train = X_train[idxs]
3,训练
model = AutoEncoder(784, 200, 0.001)  # 学习率对loss影响也有点大

model.fit(data_train, batch_size=128, epoches=200)  # 200轮即可
4,测试,可视化对比图
decoded_test = model.reconstruct(X_test)

import matplotlib.pyplot as plt

%matplotlib inline

shape = (28, 28)

fig, axes = plt.subplots(2,10,

                         figsize=(10, 2),

                         subplot_kw={

                             'xticks': [],

                             'yticks': []

                         },

                         gridspec_kw=dict(hspace=0.1, wspace=0.1))

for i in range(10):

    axes[0][i].imshow(np.reshape(X_test[i], shape))

    axes[1][i].imshow(np.reshape(decoded_test[i], shape))

plt.show()
结果如下:
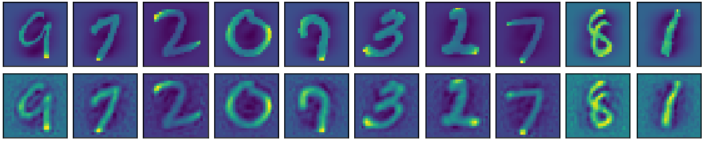
以上,可以在输入中添加点高斯噪音,增加鲁棒性。
TensorFlow自编码器(AutoEncoder)之MNIST实践的更多相关文章
- 用tensorflow搭建RNN(LSTM)进行MNIST 手写数字辨识
用tensorflow搭建RNN(LSTM)进行MNIST 手写数字辨识 循环神经网络RNN相比传统的神经网络在处理序列化数据时更有优势,因为RNN能够将加入上(下)文信息进行考虑.一个简单的RNN如 ...
- 吴裕雄 PYTHON 神经网络——TENSORFLOW 双隐藏层自编码器设计处理MNIST手写数字数据集并使用TENSORBORD描绘神经网络数据2
import os import tensorflow as tf from tensorflow.examples.tutorials.mnist import input_data os.envi ...
- 吴裕雄 PYTHON 神经网络——TENSORFLOW 单隐藏层自编码器设计处理MNIST手写数字数据集并使用TensorBord描绘神经网络数据
import os import numpy as np import tensorflow as tf import matplotlib.pyplot as plt from tensorflow ...
- 学习笔记TF061:分布式TensorFlow,分布式原理、最佳实践
分布式TensorFlow由高性能gRPC库底层技术支持.Martin Abadi.Ashish Agarwal.Paul Barham论文<TensorFlow:Large-Scale Mac ...
- 深度学习之自编码器AutoEncoder
原文地址:https://blog.csdn.net/marsjhao/article/details/73480859 一.什么是自编码器(Autoencoder) 自动编码器是一种数据的压缩算法, ...
- Tesorflow-自动编码器(AutoEncoder)
直接附上代码: import numpy as np import sklearn.preprocessing as prep import tensorflow as tf from tensorf ...
- tensorflow学习笔记五:mnist实例--卷积神经网络(CNN)
mnist的卷积神经网络例子和上一篇博文中的神经网络例子大部分是相同的.但是CNN层数要多一些,网络模型需要自己来构建. 程序比较复杂,我就分成几个部分来叙述. 首先,下载并加载数据: import ...
- tensorflow学习笔记四:mnist实例--用简单的神经网络来训练和测试
刚开始学习tf时,我们从简单的地方开始.卷积神经网络(CNN)是由简单的神经网络(NN)发展而来的,因此,我们的第一个例子,就从神经网络开始. 神经网络没有卷积功能,只有简单的三层:输入层,隐藏层和输 ...
- Tensorflow学习笔记(对MNIST经典例程的)的代码注释与理解
1 #coding:utf-8 # 日期 2017年9月4日 环境 Python 3.5 TensorFlow 1.3 win10开发环境. import tensorflow as tf from ...
随机推荐
- 开启防火墙如何部署k8s
你可以不关闭防火墙,只需要开启这些端口就行了MASTER节点6443* Kubernetes API server 2379-2380 etcd server client API 10250 Kub ...
- select * from a,b探讨
select * from a,b探讨 今天看同事代码里使用了select * from a,b where a.id=b.id,而我平时都是使用select * from a inner join ...
- 04 vue-cli 脚手架、webpack-simple模板项目生成、组件使用
alice https://www.cnblogs.com/alice-bj/p/9317504.html https://www.cnblogs.com/alice-bj/p/9318069.htm ...
- vue插件开发的两种方法:以通知插件toastr为例
方法一: 1.写插件: 在 src 文件夹下面建 lib 文件夹用于存放插件,lib 文件夹下再建toastr文件夹,在toastr文件夹下新建 toastr.js 和 toastr.vue两个文件. ...
- 微信公众号开发不能使用session原因
今天做微信公众号开发整合功能的时候,使用session保存记录.用postman测试好使,但是一旦用手机就不好使.上网查了好久才明白,微信开发是不能用session的.具体原因如下:因为微信的所有请求 ...
- jpa单向一对多
单向一对多是一个类中的一条记录可对应另一个类的多条记录: 比如一个部门可对应多个员工: jpa中的实现步骤: one-to-many的one类中添加一个many类类型的set;比如部门类D ...
- js中声明函数的区别
在JS中有两种定义函数的方式, 1是var aaa=function(){...} 2是function aaa(){...} var 方式定义的函数,不能先调用函数,后声明,只能先声明函数,然后调用 ...
- Nmap简单的漏扫
转载至 https://www.4hou.com/technology/10481.html 导语:Nmap本身内置有丰富的NSE脚本,可以非常方便的利用起来,当然也可以使用定制化的脚本完成个人的 ...
- Java读取根据HTML模板生成HTML页面
首先,我们需要一个html模板: <html> <head> <title>###title###</title> <meta http-equi ...
- VNC连接Ubuntu 16.04桌面灰色的问题解决
1.安装gnome apt-get install --no-install-recommends ubuntu-desktop gnome-panel gnome-settings-daem ...