
python2.7 urllib2 爬虫
# _*_ coding:utf-8 _*_
import urllib2
import cookielib
import random
import re
from bs4 import BeautifulSoup
import datetime
dax = datetime.datetime.now().strftime('%Y-%m-%d')
print(dax)
url = 'http://ww=singlemessage&isappinstalled=0'
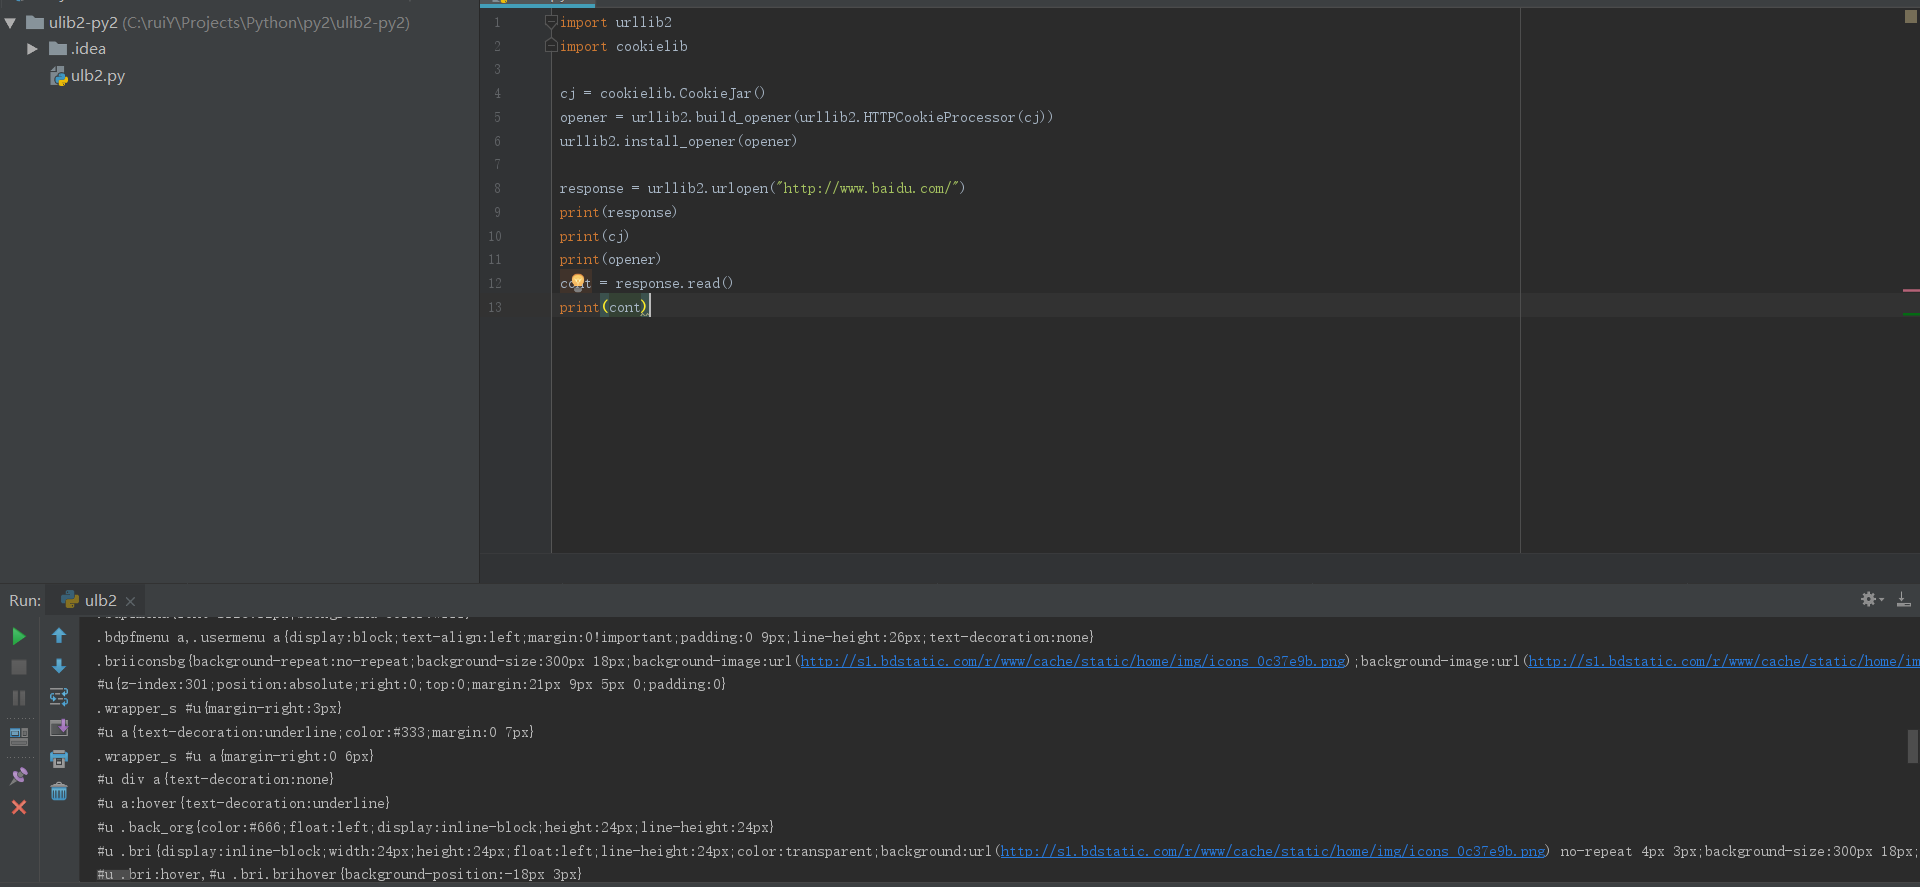
cj = cookielib.CookieJar()
opener = urllib2.build_opener(urllib2.HTTPCookieProcessor(cj))
urllib2.install_opener(opener)
request = urllib2.Request(url)
headers = [
'Mozilla/4.0 (compatible; MSIE 7.0; Windows NT 5.1; 360SE)',
'Mozilla/4.0 (compatible; MSIE 7.0; Windows NT 5.1; Maxthon 2.0)',
'Opera/9.80 (Windows NT 6.1; U; en) Presto/2.8.131 Version/11.11',
'Mozilla/5.0 (compatible; MSIE 9.0; Windows NT 6.1; Trident/5.0',
'Mozilla/5.0 (Macintosh; U; Intel Mac OS X 10_6_8; en-us) AppleWebKit/534.50 (KHTML, like Gecko) Version/5.1 Safari/534.50'
]
hds = random.choice(headers)
# print(hds)
request.add_header('User-Agent','%s' % hds)
#response = urllib2.urlopen("http://www.hn1m=singlemessage&isappinstalled=0")
response = urllib2.urlopen(request)
cont = response.read()
#print(cont)
soup = BeautifulSoup(cont,'html.parser',from_encoding='utf-8')
# print(soup)
# listyj = soup.find_all('dl')
# for listyjx in listyj:
# print(listyjx.name,listyjx.attrs,listyjx.gettext())
# # if dax in listyjx:
# # print(listyjx)

python2.7 urllib2 爬虫的更多相关文章
- python2下经典爬虫(第一卷)
python2.7的爬虫个人认为比较经典在此我将会用书中的网站http://example.webscraping.com作为案例 爬虫第一步:进行背景调研 了解网站的结构资源在网站的robots.t ...
- Python2和Python3 爬虫 转换
由于Python3的不断完善,很多新入Python的小伙伴选择了Python3的阵营,很多人选择了爬虫这一热门话题,但是网络上大部分教程都是Python2 教程,Python3这一块做了些许的改动,对 ...
- 关于urllib、urllib2爬虫伪装的总结
站在网站管理的角度,如果在同一时间段,大家全部利用爬虫程序对自己的网站进行爬取操作,那么这网站服务器能不能承受这种负荷?肯定不能啊,如果严重超负荷则会时服务器宕机(死机)的,对于一些商业型的网站,宕机 ...
- [Selenium2+python2.7][Scrap]爬虫和selenium方式下拉滚动条获取简书作者目录并且生成Markdown格式目录
预计阅读时间: 15分钟 环境: win7 + Selenium2.53.6+python2.7 +Firefox 45.2 (具体配置参考 http://www.cnblogs.com/yoyok ...
- python2与python3爬虫中get与post对比
python2中的urllib2改为python3中的urllib.request 四种方式对比: python2的get: # coding=utf-8 import urllib import u ...
- python2.x urllib2和urllib的使用
1.最简单用法 urlopen(url, data=None, timeout=socket._GLOBAL_DEFAULT_TIMEOUT,...) import urllib2 import ur ...
- Python2 基于urllib2 的HTTP请求类
一个利用urllib2模块编写的下载器,虽然有了requests模块,但是毕竟标准库 import urllib2,random class strong_down(): def __init__(s ...
- python2中urllib2模块带cookies使用方法
#!/usr/bin/python # coding=utf-8 #############方式1######################### import urllib2 cookie = & ...
- python3--网络爬虫--爬取图片
网上大多爬虫仍旧是python2的urllib2写的,不过,坚持用python3(3.5以上版本可以使用异步I/O) 相信有不少人爬虫第一次爬的是Mm图,网上很多爬虫的视频教程也是爬mm图,看了某人的 ...
随机推荐
- PHP中的插件机制原理和实例
PHP项目中很多用到插件的地方,更尤其是基础程序写成之后很多功能由第三方完善开发的时候,更能用到插件机制,现在说一下插件的实现.特点是无论你是否激活,都不影响主程序的运行,即使是删除也不会影响. 从一 ...
- WebService发布到IIS
发布WebService 第一步:选择项目右键发布 第二步:选择文件系统.目标位置(即,发布后文件保存位置) 单击发布 将WebService发布至IIS 第一步:打开IIS 右键添加网站--填写网站 ...
- WebGL和ThreeJs学习6--射线法确定3D空间中所选物体
一.在 threejs 中如何确定下图3D空间中鼠标点击位置的 object 对象? 二.射线法确定步骤及代码 //Three.js提供一个射线类Raycaster来拾取场景里面的物体.更方便的使用鼠 ...
- ALGO-115_蓝桥杯_算法训练_和为T(枚举)
问题描述 从一个大小为n的整数集中选取一些元素,使得它们的和等于给定的值T.每个元素限选一次,不能一个都不选. 输入格式 第一行一个正整数n,表示整数集内元素的个数. 第二行n个整数,用空格隔开. 第 ...
- 【linux】之内核升级
安装docker要满足一定的条件,对于cents系统,要求必须是64位,并且内核版本是3.10以上. 如果你的centos操作系统内核低于3.10,需要升级到这个版本以上,才能安装docker. 第一 ...
- Qt布局管理: 停靠窗口QDockWidget类(纯代码实现)
转载:好儿郎~志在四方 详细描述: QDockWidget类提供了一个窗体部件,其可以停靠在QMainWindow,或其本身作为一个在桌面上的顶级窗口(也就是父窗体). QDockWidget类提供了 ...
- U3d 注意
设置layer :不要使用go.layer= intMM;要使用Nguitool.Setlayer(go,intLayer); static public void SetLayer (GameObj ...
- Scrapy学习篇(五)之Spiders
Spiders Spider类定义了如何爬取某个网站.包括了爬取的动作(例如:是否跟进链接)以及如何从网页的内容中提取结构化数据(爬取item).简而言之,Spider就是你定义爬取的动作及分析某个网 ...
- Zabbix系统中的历史数据和趋势数据
原文:http://blog.chinaunix.net/uid-9411004-id-4139807.html 或许读者还记得,我们在介绍如何创建一个监控项目时,我们介绍过在“配置项目”表单页面上有 ...
- fragment--的生命周期
官网帮助文档链接: http://developer.Android.com/guide/components/fragments.html 主要看两张图,和跑代码 1,Fragment的生命周: 2 ...