
RDD编程
一、词频统计
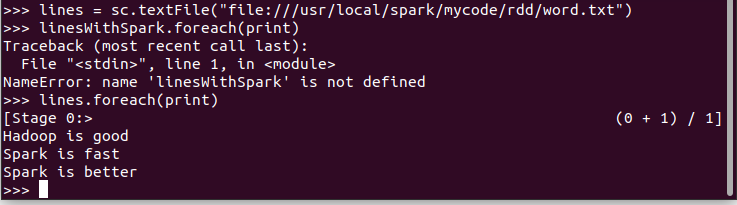
1.读文本文件生成RDD lines
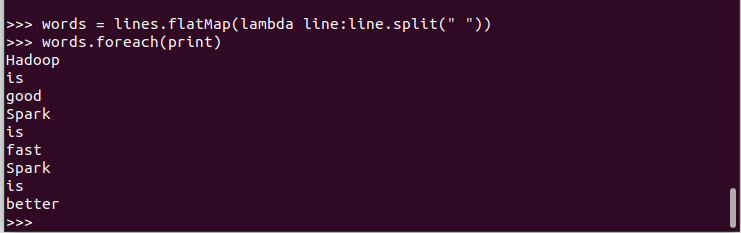
2.将一行一行的文本分割成单词 words flatmap()
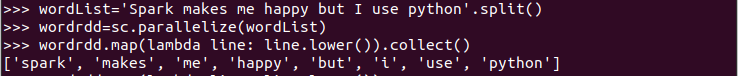
3.全部转换为小写 lower()
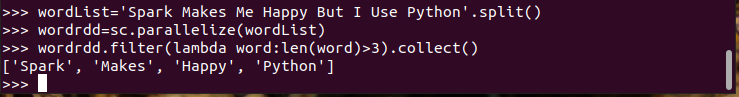
4.去掉长度小于3的单词 filter()
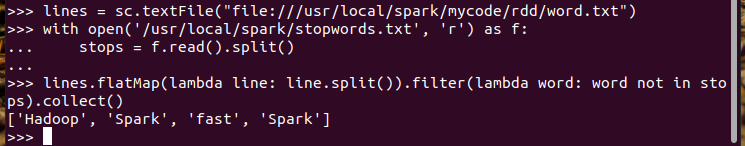
5.去掉停用词
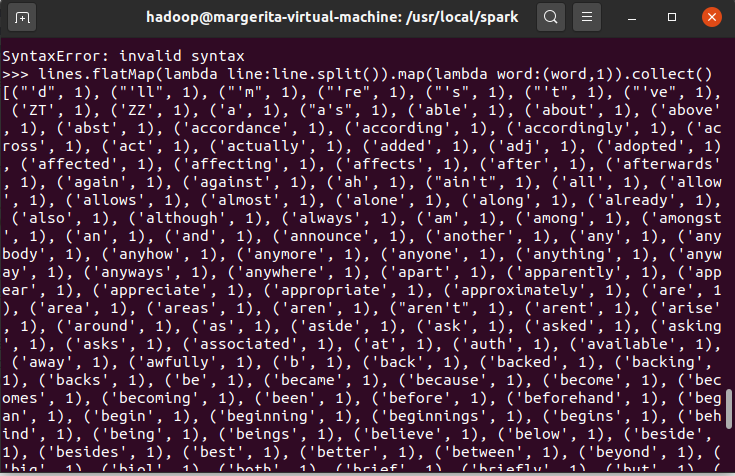
6.转换成键值对 map()
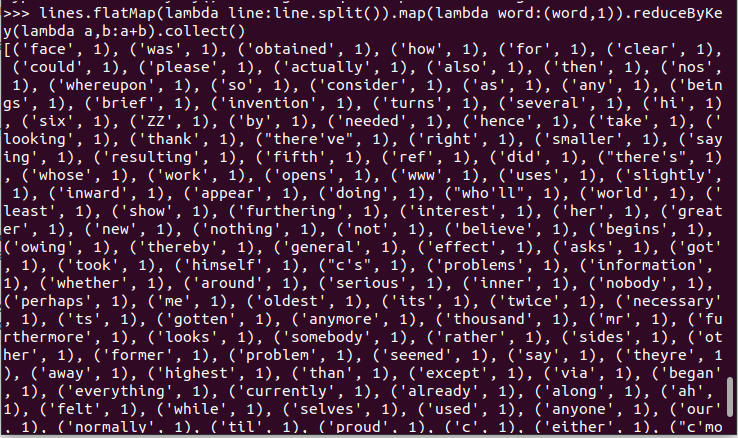
7.统计词频 reduceByKey()
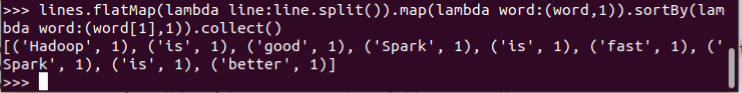
8.按字母顺序排序 sortBy(f)
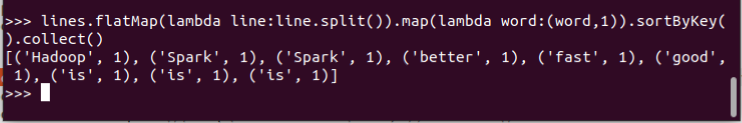
9.按词频排序 sortByKey()
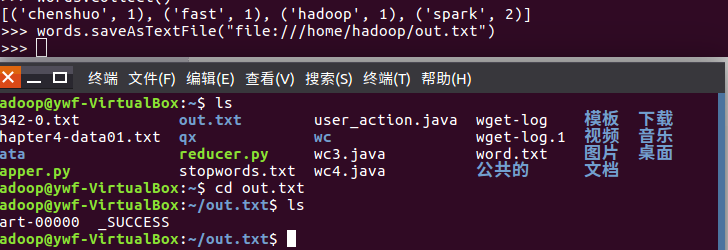
10.结果文件保存 saveAsTextFile(out_url)
words.saveAsTextFile("file:///home/hadoop/out.txt")
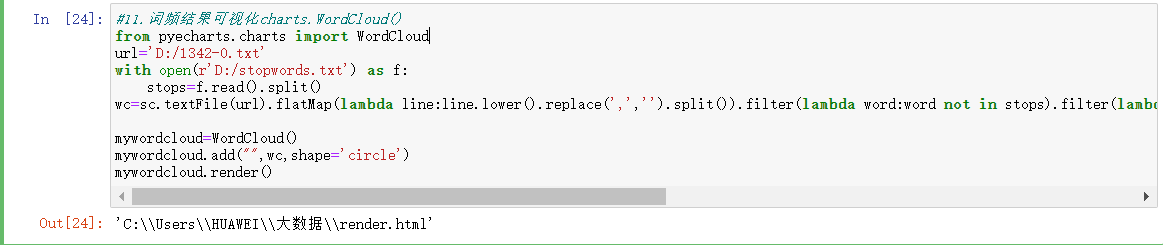
11.词频结果可视化charts.WordCloud()

#11.词频结果可视化charts.WordCloud()

from pyecharts.charts import WordCloud

url='D:/1342-0.txt'

with open(r'D:/stopwords.txt') as f:

    stops=f.read().split()

wc=sc.textFile(url).flatMap(lambda line:line.lower().replace(',','').split()).filter(lambda word:word not in stops).filter(lambda word:len(word)>2).map(lambda word:(word,1)).reduceByKey(lambda a,b:a+b).sortBy(lambda x:x[1],False).take(100)

mywordcloud=WordCloud()

mywordcloud.add("",wc,shape='circle')

mywordcloud.render()
二、学生课程分数案例
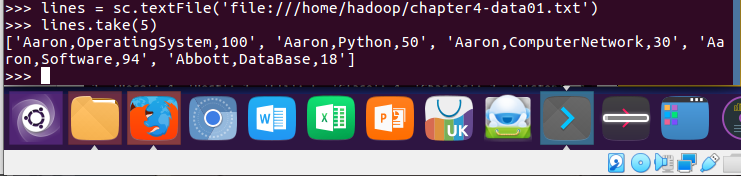
lines = sc.textFile('file:///home/hadoop/chapter4-data01.txt')
lines.take(5)
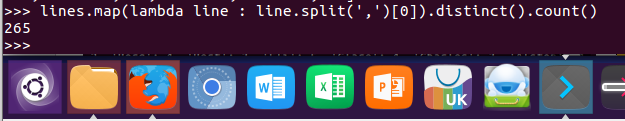
1.总共有多少学生?map(), distinct(), count()
lines.map(lambda line : line.split(',')[0]).distinct().count()
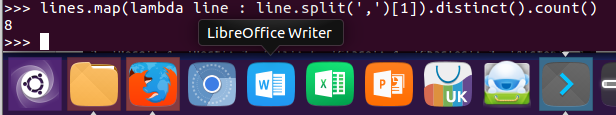
2.开设了多少门课程?
lines.map(lambda line : line.split(',')[1]).distinct().count()
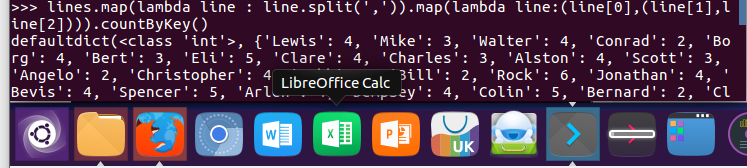
3.每个学生选修了多少门课?map(), countByKey()
lines.map(lambda line : line.split(',')).map(lambda line:(line[0],(line[1],line[2]))).countByKey()
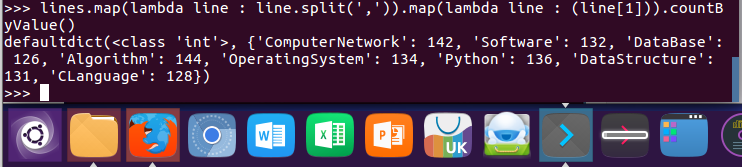
4.每门课程有多少个学生选?map(), countByValue()
lines.map(lambda line : line.split(',')).map(lambda line : (line[1])).countByValue()
5.Les选修了几门课?每门课多少分?filter(), map() RDD
lines.filter(lambda line:"Les" in line).map(lambda line:line.split(',')).collect()
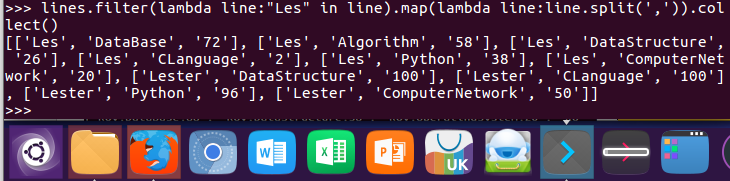
6.Les选修了几门课?每门课多少分?map(),lookup() list
lines.map(lambda line:line.split(',')).map(lambda line:(line[0],line[1])).lookup("Les")

lines.map(lambda line:line.split(',')).map(lambda line:(line[0],line[2])).lookup("Les")
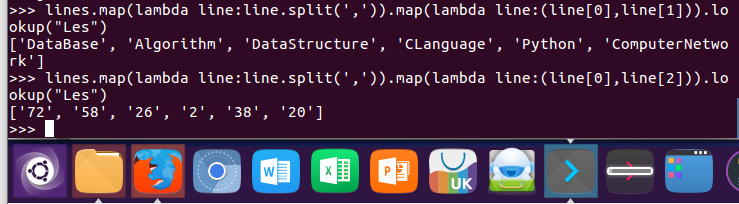
7.Les的成绩按分数大小排序。filter(), map(), sortBy()
lines.filter(lambda line:"Les" in line).map(lambda line:line.split(',')).sortBy(lambda line:(line[2])).collect()
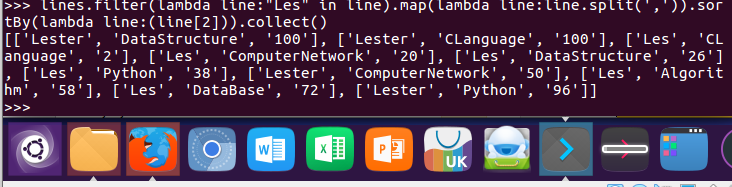
8.Les的平均分。map(),lookup(),mean()
import numpy as np

meanlist=lines.map(lambda line:line.split(',')).map(lambda line:(line[0],line[2])).lookup("Les")

np.mean([int(x) for x in meanlist])
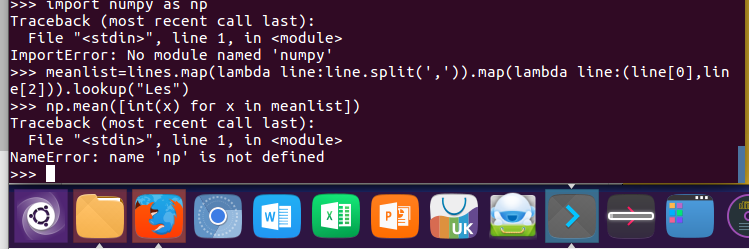
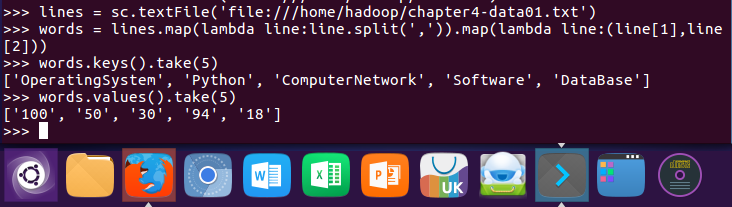
9.生成(课程,分数)RDD,观察keys(),values()
lines = sc.textFile('file:///home/hadoop/chapter4-data01.txt')

words = lines.map(lambda line:line.split(',')).map(lambda line:(line[1],line[2]))

words.keys().take(5)

words.values().take(5)
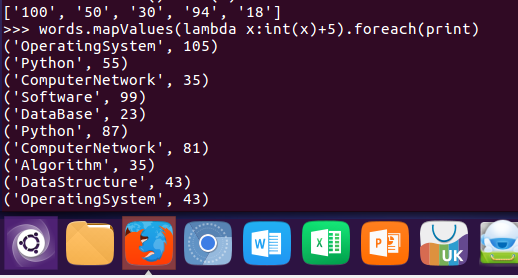
10.每个分数+5分。mapValues(func)
words.mapValues(lambda x:int(x)+5).foreach(print)
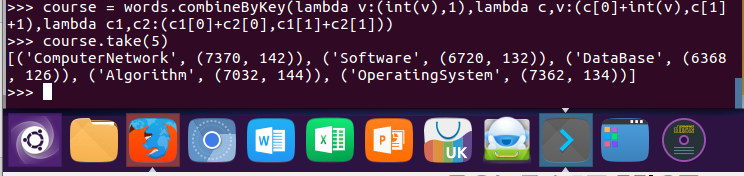
11.求每门课的选修人数及所有人的总分。combineByKey()
course = words.combineByKey(lambda v:(int(v),1),lambda c,v:(c[0]+int(v),c[1]+1),lambda c1,c2:(c1[0]+c2[0],c1[1]+c2[1]))
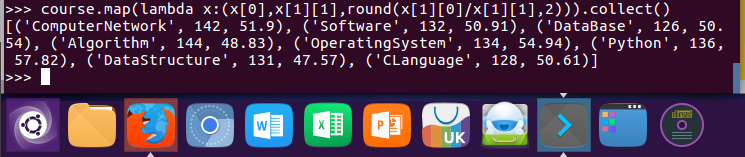
12.求每门课的选修人数及平均分,精确到2位小数。map(),round()
course.map(lambda x:(x[0],x[1][1],round(x[1][0]/x[1][1],2))).collect()
13.求每门课的选修人数及平均分。用reduceByKey()实现,并比较与combineByKey()的异同。
lines.map(lambda line:line.split(',')).map(lambda x:(x[1],(int(x[2]),1))).reduceByKey(lambda a,b:(a[0]+b[0],a[1]+b[1])).foreach(print)

14.结果可视化。charts,Bar()
from pyecharts.charts import Bar

from pyecharts import options as opts

bar = Bar()

bar.add_xaxis(cs.keys().collect())

bar.add_yaxis('avg',cs.map(lambda x:x[2]).collect())

#bar.set_global_opts(title_opts=opts.TitleOpts(title="各课程",subtitle="平均分"),xaxis_opts=opts.AxisOpts(axislabel_opt=opts.LabelOpts(rotate=30)))

bar.set_global_opts()

bar.render_notebook()
X轴设置斜体的方法忘记了不会写

RDD编程的更多相关文章
- Spark菜鸟学习营Day3 RDD编程进阶
Spark菜鸟学习营Day3 RDD编程进阶 RDD代码简化 对于昨天练习的代码,我们可以从几个方面来简化: 使用fluent风格写法,可以减少对于中间变量的定义. 使用lambda表示式来替换对象写 ...
- Spark菜鸟学习营Day1 从Java到RDD编程
Spark菜鸟学习营Day1 从Java到RDD编程 菜鸟训练营主要的目标是帮助大家从零开始,初步掌握Spark程序的开发. Spark的编程模型是一步一步发展过来的,今天主要带大家走一下这段路,让我 ...
- Spark学习笔记2:RDD编程
通过一个简单的单词计数的例子来开始介绍RDD编程. import org.apache.spark.{SparkConf, SparkContext} object word { def main(a ...
- Spark编程模型(RDD编程模型)
Spark编程模型(RDD编程模型) 下图给出了rdd 编程模型,并将下例中用 到的四个算子映射到四种算子类型.spark 程序工作在两个空间中:spark rdd空间和 scala原生数据空间.在原 ...
- 02、体验Spark shell下RDD编程
02.体验Spark shell下RDD编程 1.Spark RDD介绍 RDD是Resilient Distributed Dataset,中文翻译是弹性分布式数据集.该类是Spark是核心类成员之 ...
- Spark学习之RDD编程(2)
Spark学习之RDD编程(2) 1. Spark中的RDD是一个不可变的分布式对象集合. 2. 在Spark中数据的操作不外乎创建RDD.转化已有的RDD以及调用RDD操作进行求值. 3. 创建RD ...
- 5.1 RDD编程
一.RDD编程基础 1.创建 spark采用textFile()方法来从文件系统中加载数据创建RDD,该方法把文件的URL作为参数,这个URL可以是: 本地文件系统的地址 分布式文件系统HDFS的地址 ...
- 2. RDD编程
2.1 编程模型 在Spark中,RDD被表示为对象,通过对象上的方法调用来对RDD进行转换.经过一系列的transformations定义RDD之后,就可以调用actions触发RDD的计算,act ...
- spark实验(四)--RDD编程(1)
一.实验目的 (1)熟悉 Spark 的 RDD 基本操作及键值对操作: (2)熟悉使用 RDD 编程解决实际具体问题的方法. 二.实验平台 操作系统:centos6.4 Spark 版本:1.5.0 ...
- 第2章 RDD编程(2.3)
第2章 RDD编程(2.3) 2.3 TransFormation 基本RDD Pair类型RDD (伪集合操作 交.并.补.笛卡尔积都支持) 2.3.1 map(func) 返回一个新的RDD,该 ...
随机推荐
- shell_Day04
grep程序 Linux下有文本处理三剑客 -- grep sed awk grep:文本 行过滤工具 sed: 文本 行编辑器(流编辑器) awk:报告生成器(做文本输出格式化) grep 包含三个 ...
- (已解决)nginx+tp,怎么设置 省略index.php的url访问。
打开vhosts.conf,在localhost / {}里面加入下面的代码: if (!-e $request_filename) { rewrite ^(.*)$ /index.php?s=$1 ...
- 12组-Alpha冲刺-6/6
12组-Alpha冲刺-6/6 一.基本情况 队名:字节不跳动 组长博客:https://www.cnblogs.com/147258369k/p/15573118.html 小组人数:10人 二.冲 ...
- 一个因为windows系统缺失文件而导致的pyspark的BUG
背景: 在windows 系统中开发pyspark程序. 一个简单的WC程序: from pyspark.sql import SparkSession spark = SparkSession.bu ...
- sap软件功能介绍及主要功能(模块)有哪些?
SAP 成立于 1972 年,最初称为 System Analysis Program Development (Systemanalyse Programmentwicklung),后来采用缩写 S ...
- 《TensorFlow+Keras自然语言处理实战》图书介绍
#好书推荐##好书奇遇季#<TensorFlow+Keras自然语言处理实战>.当当京东天猫均有发售. https://item.jd.com/12788707.html 文后有本书配套源 ...
- Centos7 安装Seata,注册中心选择nocas
前言 1.什么是分布式事务,分布式事务包含哪些角色 分布式事务主要包含,事务参与者,事务管理者,资源服务器三个角色.分布式事务是指着三个角色分别位于不同的分布式系统的不同节点之上.简单的说,就是一次大 ...
- Windows Defender 实时防护打不开,你的IT管理员已经限制对此应用一些区域的访问
最近在使用电脑的时候,Windows Defender实时防护不能使用,一打开就自动关闭,并且显示 该页面不可用 你的IT管理员已经限制对此应用一些区域的访问,实时防护页面显示 正在使用其他防护软件. ...
- Java 接口内容小结
Java接口学习:https://www.cnblogs.com/mlllily/p/14923837.html 小结内容: 在Java9+版本中,接口内容可以有常量.抽象方法.默认方法.静态方法.私 ...
- PHP 8 Apache 2.4
PHP 8 一.下载 官网:PHP For Windows: Binaries and sources Releases 切记要下载Thread Safe版本,不然后面不能够连接Apache服务 ...