
安装Hadoop单节点伪分布式集群
安装Hadoop单节点伪分布式集群
操作系统:Ubuntu server 20.04
参考文档:http://apache.github.io/hadoop/hadoop-project-dist/hadoop-common/SingleCluster.html
系统准备
开启SSH
系统支持SSH远程登陆.
如未安装可使用下面命令安装:
sudo apt-get install ssh
安装JDK
参考网址:https://cwiki.apache.org/confluence/display/HADOOP/Hadoop+Java+Versions
官方文档:
- Apache Hadoop 3.3 and upper supports Java 8 and Java 11 (runtime only)
- Please compile Hadoop with Java 8. Compiling Hadoop with Java 11 is not supported: HADOOP-16795 - Java 11 compile support OPEN
- Apache Hadoop from 3.0.x to 3.2.x now supports only Java 8
- Apache Hadoop from 2.7.x to 2.10.x support both Java 7 and 8
根据官方文档,目前支持JDK8和JDK11,我们安装JDK8即可
操作步骤如下:
# 更新软件包

sudo apt-get update

sudo apt-get upgrade

# 安装JDK8

sudo apt install openjdk-8-jdk

# 验证是否安装成功

java -version

# 输出

openjdk version "1.8.0_362"

OpenJDK Runtime Environment (build 1.8.0_362-8u372-ga~us1-0ubuntu1~22.04-b09)

OpenJDK 64-Bit Server VM (build 25.362-b09, mixed mode)
查看JAVA安装信息
# 查看安装目录

which java

# 输出:/usr/bin/java

# 查看具体路径

ll /usr/bin/java

# 输出:... /usr/bin/java -> /etc/alternatives/java*
设置JAVA_HOME
# 查找系统中可用的JAVA版本

update-alternatives --config java

# 输出:

# There is only one alternative in link group java (providing /usr/bin/java): /usr/lib/jvm/java-8-openjdk-amd64/jre/bin/java

# Nothing to configure.

# 通过上面输出信息安装路径为:/usr/lib/jvm/java-8-openjdk-amd64/jre/bin/java

# 编辑profile文件

vim /etc/profile

# 在文件中添加下面代码

export JAVA_HOME=/usr/lib/jvm/java-8-openjdk-amd64

export JRE_HOME=$JAVA_HOME/jre

export CLASSPATH=$JAVA_HOME/lib:$JRE_HOME/lib:$CLASSPATH

export PATH=$JAVA_HOME/bin:$JRE_HOME/bin:$PATH

# 生效环境变量

source /etc/profile

# 验证是否设置成功

echo $JAVA_HOME

# 到这里如果停的话,就会出现一种情况,每次打开终端,就需要source /etc/profile一下才能使用java环境,所以参考博客https://blog.csdn.net/RABCDXB/article/details/123243868 做法如下:

# 输入vim ~/.bashrc,在对应文件中输入上面相同的配置数据。
安装Hadoop
下载
目前最新版本为:3.3.6,安装最新版本,可从官网下载。
下载地址:https://dlcdn.apache.org/hadoop/common/hadoop-3.3.6/hadoop-3.3.6.tar.gz
# 进入软件下载目录,如果该目录不存在则可创建此目录

cd /root/software

# 下载安装包

wget https://dlcdn.apache.org/hadoop/common/hadoop-3.3.6/hadoop-3.3.6.tar.gz
准备启动
# 将软件复制到安装目录,如果该目录不存在可创建

cd /root/program

# 复制安装包

cp /root/software/hadoop-3.3.6.tar.gz .

# 解压

tar -zxvf hadoop-3.3.6.tar.gz

# 设置JavaHome

vim /root/program/hadoop-3.3.6/etc/hadoop/hadoop-env.sh

# 修改JAVA_HOME变量,大约在54行

export JAVA_HOME=/usr/lib/jvm/java-8-openjdk-amd64

# 保存后测试启动

cd /root/program/hadoop-3.3.6

bin/hadoop

# 此命令输出相关操作说明
接下来,将有三种启动模式部署:
Local (Standalone) Mode:单机模式
Pseudo-Distributed Mode:伪分布式
Fully-Distributed Mode:分布式
下面以伪分布式模式进行说明,其他模式部署方式请参考官方文档。
伪分布式模式安装
Hadoop可以以伪分布式的方式部署在一台机器上。
配置
配置core-site.xml文件.
# 进入Hadoop软件目录

cd /root/program/hadoop-3.3.6

# 编辑配置文件

vim etc/hadoop/core-site.xml

# 在文件的configuration节点添加下面配置文件(第19行):
<configuration>

    <property>

        <name>fs.defaultFS</name>

        <value>hdfs://localhost:9000</value>

    </property>

</configuration>
配置etc/hadoop/hdfs-site.xml文件.
# 进入Hadoop软件目录

cd /root/program/hadoop-3.3.6

# 编辑配置文件

vim etc/hadoop/hdfs-site.xml

# 在文件的configuration节点添加下面配置文件(第19行):
<configuration>

    <property>

        <name>dfs.replication</name>

        <value>1</value>

    </property>

</configuration>
配置sbin/start-dfs.sh文件中启动用户为root.
# 进入Hadoop软件目录

cd /root/program/hadoop-3.3.6

# 编辑配置文件

vim sbin/start-dfs.sh

# 文件顶部添加以下参数

#!/usr/bin/env bash

HDFS_DATANODE_USER=root

HADOOP_SECURE_DN_USER=hdfs

HDFS_NAMENODE_USER=root

HDFS_SECONDARYNAMENODE_USER=root
配置sbin/stop-dfs.sh文件中启动用户为root.
# 进入Hadoop软件目录

cd /root/program/hadoop-3.3.6

# 编辑配置文件

vim sbin/stop-dfs.sh

# 文件顶部添加以下参数

#!/usr/bin/env bash

HDFS_DATANODE_USER=root

HADOOP_SECURE_DN_USER=hdfs

HDFS_NAMENODE_USER=root

HDFS_SECONDARYNAMENODE_USER=root
配置sbin/start-yarn.sh文件中启动用户为root.
# 进入Hadoop软件目录

cd /root/program/hadoop-3.3.6

# 编辑配置文件

vim sbin/start-yarn.sh

# 文件顶部添加以下参数

#!/usr/bin/env bash

YARN_RESOURCEMANAGER_USER=root

HADOOP_SECURE_DN_USER=yarn

YARN_NODEMANAGER_USER=root
配置sbin/stop-yarn.sh文件中启动用户为root.
# 进入Hadoop软件目录

cd /root/program/hadoop-3.3.6

# 编辑配置文件

vim sbin/stop-yarn.sh

# 文件顶部添加以下参数

#!/usr/bin/env bash

YARN_RESOURCEMANAGER_USER=root

HADOOP_SECURE_DN_USER=yarn

YARN_NODEMANAGER_USER=root
配饰SSH免密登录本机
# 检查是否已支持免密登录

ssh localhost

# 如果未配置,可使用下面命令配置,注意当前登录用户为root

ssh-keygen -t rsa -P '' -f ~/.ssh/id_rsa

cat ~/.ssh/id_rsa.pub >> ~/.ssh/authorized_keys

chmod 0600 ~/.ssh/authorized_keys
测试启动
截至到目前配置,可以测试启动Hadoop,此种方式可手动执行MapReduce任务,该部分仅验证是否可正常启动。
后面将会介绍Yarn配置,并使用Yarn运行任务。
# 进入应用安装目录

cd /root/program/hadoop-3.3.6

# 文件系统格式化

bin/hdfs namenode -format

# 启动NameNode和DataNode

sbin/start-dfs.sh

# 浏览器打开终端进行查看运行状态,注意防火墙端口是否打开,NameNode网址如下:

http://192.168.40.134:9870/

# 现状状态 Active 即为运行成功

# 停止NameNode和DataNode

sbin/stop-dfs.sh
单节点安装YARN
在保证上面测试启动运行正常情况下,可以按照下面步骤配置启动YARN.
配置etc/hadoop/mapred-site.xml文件.
# 进入Hadoop软件目录

cd /root/program/hadoop-3.3.6

# 编辑配置文件

vim etc/hadoop/mapred-site.xml

# 在文件的configuration节点添加下面配置文件(第19行):

<configuration>

    <property>

        <name>mapreduce.framework.name</name>

        <value>yarn</value>

    </property>

    <property>

        <name>mapreduce.application.classpath</name>

        <value>$HADOOP_MAPRED_HOME/share/hadoop/mapreduce/*:$HADOOP_MAPRED_HOME/share/hadoop/mapreduce/lib/*</value>

    </property>

</configuration>
配置etc/hadoop/yarn-site.xml文件.
# 进入Hadoop软件目录

cd /root/program/hadoop-3.3.6

# 编辑配置文件

vim etc/hadoop/yarn-site.xml

# 在文件的configuration节点添加下面配置文件(第16行):

<configuration>

    <property>

        <name>yarn.nodemanager.aux-services</name>

        <value>mapreduce_shuffle</value>

    </property>

    <property>

        <name>yarn.nodemanager.env-whitelist</name>

        <value>JAVA_HOME,HADOOP_COMMON_HOME,HADOOP_HDFS_HOME,HADOOP_CONF_DIR,CLASSPATH_PREPEND_DISTCACHE,HADOOP_YARN_HOME,HADOOP_HOME,PATH,LANG,TZ,HADOOP_MAPRED_HOME</value>

    </property>

</configuration>
服务启动与停止:
# 进入Hadoop软件目录

cd /root/program/hadoop-3.3.6

# 服务启动

sbin/start-yarn.sh

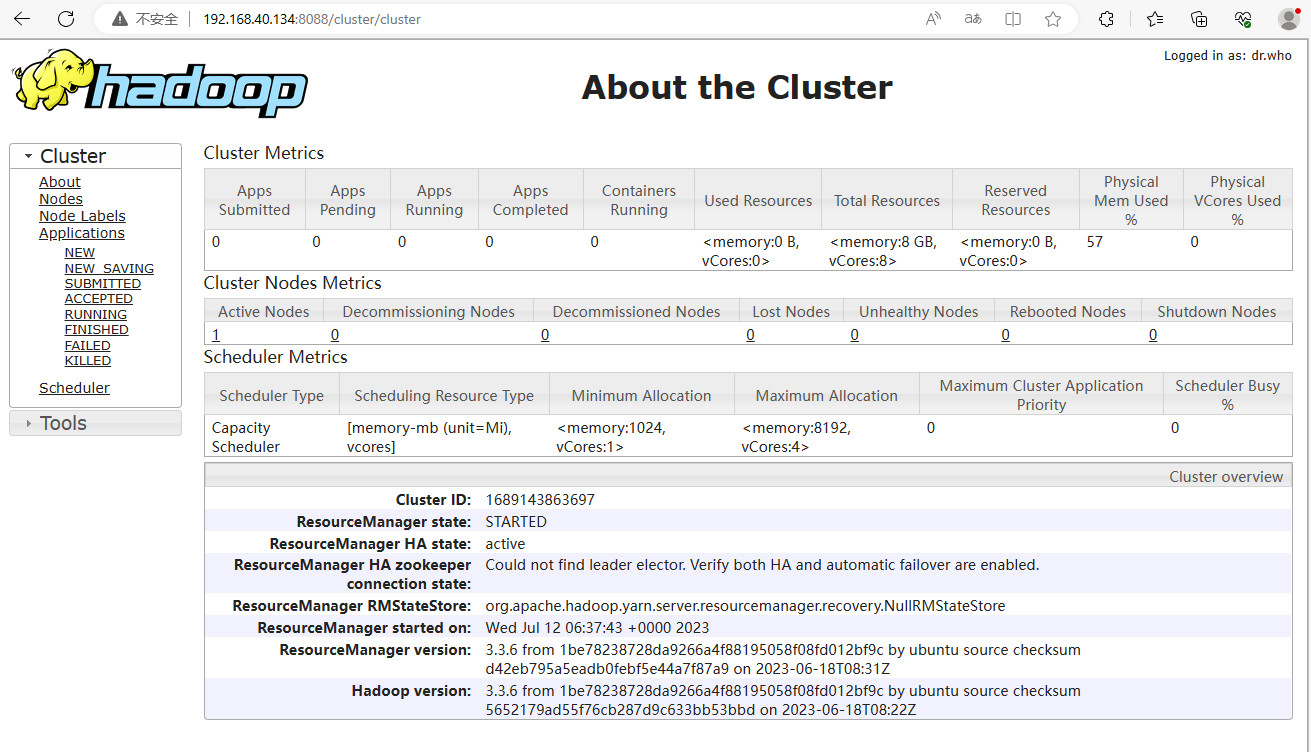
# 浏览器打开终端进行查看运行状态,注意防火墙端口是否打开,资源管理网址如下:

http://192.168.40.134:8088/

# 服务停止

sbin/stop-yarn.sh
伪分布式集群启动与停止
# 进入Hadoop软件目录

cd /root/program/hadoop-3.3.6

# 启动,注意顺序

sbin/start-dfs.sh

sbin/start-yarn.sh

# 停止,注意顺序

sbin/stop-dfs.sh

sbin/stop-yarn.sh

安装Hadoop单节点伪分布式集群的更多相关文章
- kafka系列一:单节点伪分布式集群搭建
Kafka集群搭建分为单节点的伪分布式集群和多节点的分布式集群两种,首先来看一下单节点伪分布式集群安装.单节点伪分布式集群是指集群由一台ZooKeeper服务器和一台Kafka broker服务器组成 ...
- Hadoop 单节点(或集群)基本配置信息
1. 默认配置文件: 存放于Hadoop对应的jar包中 core-default.xml hdfs-default.xml yarn-default.xml mapred-default.xml 2 ...
- Win10环境下Hadoop(单节点伪分布式)的安装与配置--bug(yarn的8088端口打不开+)
一.本文思路 [1].配置java环境–JDK12(Hadoop的底层实现语言是java,hadoop运行需要JDK环境) [2].安装Hadoop 1.解压hadop 2.配置hadoop环境变量 ...
- 单节点伪分布集群(weekend110)的HBase子项目启动顺序
伪分布模式下,如(weekend110)hbase-env.sh配置文档中的HBASE_MANAGES_ZK的默认值是true,它表示HBase使用自身自带的Zookeeper实例.但是,该实例只能为 ...
- CentOS7 下 Hadoop 单节点(伪分布式)部署
Hadoop 下载 (2.9.2) https://hadoop.apache.org/releases.html 准备工作 关闭防火墙 (也可放行) # 停止防火墙 systemctl stop f ...
- 在Ubuntu14.10中部署Hadoop2.6.0单节点伪分布集群
1. 环境信息如下: ubuntu:14.10 jdk:openjdk-1.7.0 hadoop:2.6.0 2. 下载hadoop2.6.0, http://apache.fayea.com/had ...
- 单节点伪分布集群(weekend110)的Hive子项目启动顺序
因为,我的mysql是用root用户,在/home/hadoop/app/目录下,创建的. 第一步:开启mysql服务 第二步:启动hive [hadoop@weekend110 app]$ su r ...
- 吴裕雄--天生自然HADOOP操作实验学习笔记:单节点伪分布式安装
实验目的 了解java的安装配置 学习配置对自己节点的免密码登陆 了解hdfs的配置和相关命令 了解yarn的配置 实验原理 1.Hadoop安装 Hadoop的安装对一个初学者来说是一个很头疼的事情 ...
- hadoop伪分布式集群搭建与安装(ubuntu系统)
1:Vmware虚拟软件里面安装好Ubuntu操作系统之后使用ifconfig命令查看一下ip; 2:使用Xsheel软件远程链接自己的虚拟机,方便操作.输入自己ubuntu操作系统的账号密码之后就链 ...
- Hadoop学习---CentOS中hadoop伪分布式集群安装
注意:此次搭建是在ssh无密码配置.jdk环境已经配置好的情况下进行的 可以参考: Hadoop完全分布式安装教程 CentOS环境下搭建hadoop伪分布式集群 1.更改主机名 执行命令:vi / ...
随机推荐
- odoo 开发入门教程系列-模块交互
模块交互 在上一章中,我们使用继承来修改模块的行为.在我们的房地产场景中,我们希望更进一步,能够为客户生成发票.Odoo提供了一个开发票模块,因此直接从我们的房地产模块创建发票是很简单的,也就是说,一 ...
- Spring原理探究篇
spring ioc原理 首先了解一下ioc 的特征,控制反转,就是把之前手动去new对象的操作,现在来交给ioc来实现了,完成代码相对的接偶. 那么,它是怎么去创建bean对象的呐? 原理: 底层依 ...
- Django笔记二十八之数据库查询优化汇总
本文首发于公众号:Hunter后端 原文链接:Django笔记二十八之数据库查询优化汇总 这一篇笔记将从以下几个方面来介绍 Django 在查询过程中的一些优化操作,有一些是介绍如何获取 Django ...
- 牛客网:华为机试题(python版本)
输入一行:input() 输入的一行有多个信息:input().split() 有多组测试用例(多组同时输入): while true try except... 1.计算字符串最后一个单词的长度,单 ...
- dos命令、变量、字符编码、注释、用户输入
一.dos命令 1.dos命令 c: 切换盘符 cd c:\pthon 切换路径 dir 查看目录下的文件 cd .. 返回到上一层目录 cd ../.. 返回到上一层的上一层目录 二.环境变量的配置 ...
- Github 自动化部署
github action 自动化部署 一.创建github 账户 官方地址 点击进入 注册/登录 二.在项目目录下创建文件 .github\workflows固定不变 develop.yml文件名自 ...
- 2022-01-15:中心对称数 III。 中心对称数是指一个数字在旋转了 180 度之后看起来依旧相同的数字(或者上下颠倒地看)。 写一个函数来计算范围在 [low, high] 之间中心对称数的个
2022-01-15:中心对称数 III. 中心对称数是指一个数字在旋转了 180 度之后看起来依旧相同的数字(或者上下颠倒地看). 写一个函数来计算范围在 [low, high] 之间中心对称数的个 ...
- 2021-07-11:给定一个棵完全二叉树,返回这棵树的节点个数,要求时间复杂度小于O(树的节点数)。
2021-07-11:给定一个棵完全二叉树,返回这棵树的节点个数,要求时间复杂度小于O(树的节点数). 福大大 答案2021-07-11: 右树最左节点层数==左树最左节点层数,左树是满二叉树,统计左 ...
- WPF入门教程系列二十四——DataGrid使用示例(1)
WPF入门教程系列二--Application介绍 WPF入门教程系列三--Application介绍(续) WPF入门教程系列四--Dispatcher介绍 WPF入门教程系列五--Window 介 ...
- transaction.atomic装饰器
from django.shortcuts import renderfrom django.http import HttpResponsefrom django.views.generic imp ...