
算法与数据结构基础 - 合并查找(Union Find)
Union Find算法基础
Union Find算法用于处理集合的合并和查询问题,其定义了两个用于并查集的操作:
- Find: 确定元素属于哪一个子集,或判断两个元素是否属于同一子集
- Union: 将两个子集合并为一个子集
并查集是一种树形的数据结构,其可用数组或unordered_map表示:
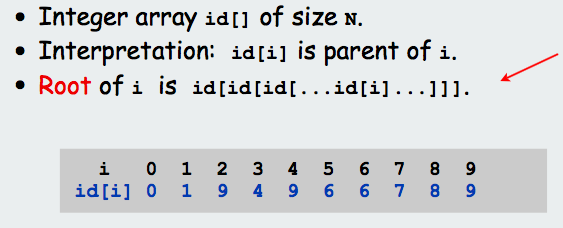
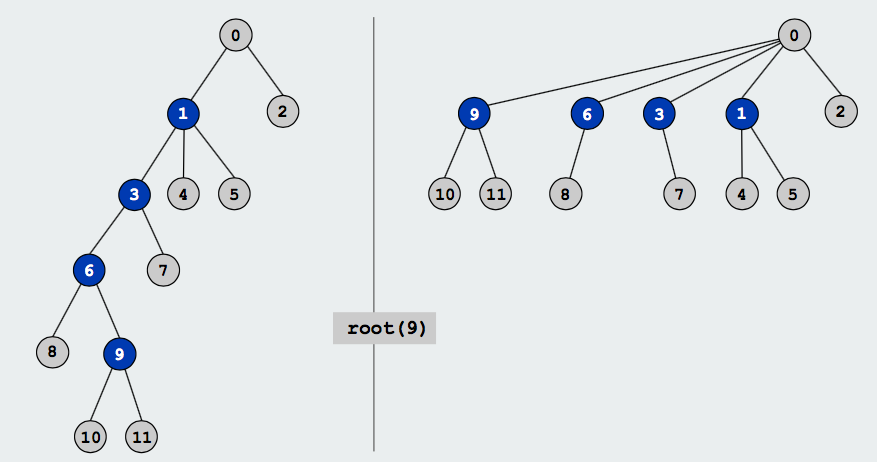
Find操作即查找元素的root,当两元素root相同时判定他们属于同一个子集;Union操作即通过修改元素的root(或修改parent)合并子集,下面两个图展示了id[6]由6修改为9的变化:
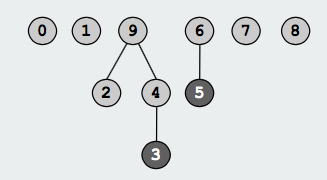
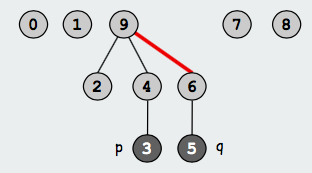
图片来源 这里
Union Find算法应用
Union Find可用于解决集合相关问题,如判断某元素是否属于集合、两个元素是否属同一集合、求解集合个数等,算法框架如下:
    //261. Graph Valid Tree
    bool validTree(int n, vector<pair<int, int>>& edges) {
        vector<);
        for(auto edge:edges){
            //find查看两点是否已在同一集合
            int x=find(num,edge.first);
            int y=find(num,edge.second);
            if(x==y) return false;  //两点已在同一集合情况下则出现环
            //union让两点加入同一集合
            num[x]=y;
        }
        ==edges.size();
    }
    int find(vector<int>&num,int i){
        ) return i;
        return find(num,num[i]);  //id[id[...id[i]...]]
    }
一些情况下为清晰和解偶会将Uinon Find实现为一个类,独立出明显的Union和Find两个操作。
相关LeetCode题:
947. Most Stones Removed with Same Row or Column 题解
算法优化
有两种常用的方法用来降低并查集树形结构的高度、以减少Uinon Find算法的时间复杂度,这两种方法是:
Weighting(或称作Ranking): 使用多一个数组记录每个集合的size,Uinon时将size小的集合挂到size大的集合下,例如:
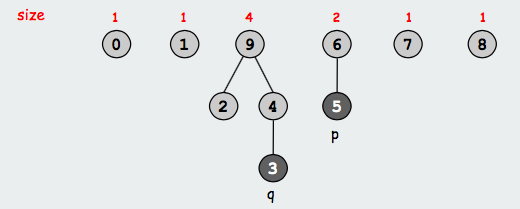
对3、5 Uinon,因3所在集合元素size 4大于5所在集合元素size 2,将6挂到9下而不是将9挂到6下。
Path compression: 对一个集合下的元素直接挂到root之下,而不是挂到其parent,path compression实现很简单只需在Find中加一行代码:
    string find(unordered_map<string,string>& root,string s){
        if(root[s]!=s)
            root[s]=find(root,root[s]);
        return root[s];
    }
加入path compression也能实现减少并查集树高度的效果,图示如下:
Weighting和Path compression两种方法可以同时使用,这样使得对N个元素进行M次Union Find操作的时间复杂度可以减少到 (M+N)lgN。因lgN随N的增长变化很小,所以整体算法时间复杂度接近于线性的时间复杂度。
相关LeetCode题:
924. Minimize Malware Spread 题解
算法与数据结构基础 - 合并查找(Union Find)的更多相关文章
- 算法与数据结构基础 - 折半查找(Binary Search)
Binary Search基础 应用于已排序的数据查找其中特定值,是折半查找最常的应用场景.相比线性查找(Linear Search),其时间复杂度减少到O(lgn).算法基本框架如下: //704. ...
- 算法与数据结构基础 - 图(Graph)
图基础 图(Graph)应用广泛,程序中可用邻接表和邻接矩阵表示图.依据不同维度,图可以分为有向图/无向图.有权图/无权图.连通图/非连通图.循环图/非循环图,有向图中的顶点具有入度/出度的概念. 面 ...
- 算法与数据结构基础 - 分治法(Divide and Conquer)
分治法基础 分治法(Divide and Conquer)顾名思义,思想核心是将问题拆分为子问题,对子问题求解.最终合并结果,分治法用伪代码表示如下: function f(input x size ...
- 算法与数据结构基础 - 数组(Array)
数组基础 数组是最基础的数据结构,特点是O(1)时间读取任意下标元素,经常应用于排序(Sort).双指针(Two Pointers).二分查找(Binary Search).动态规划(DP)等算法.顺 ...
- 算法与数据结构基础 - 堆(Heap)和优先级队列(Priority queue)
堆基础 堆(Heap)是具有这样性质的数据结构:1/完全二叉树 2/所有节点的值大于等于(或小于等于)子节点的值: 图片来源:这里 堆可以用数组存储,插入.删除会触发节点shift_down.shif ...
- 算法与数据结构基础 - 广度优先搜索(BFS)
BFS基础 广度优先搜索(Breadth First Search)用于按离始节点距离.由近到远渐次访问图的节点,可视化BFS 通常使用队列(queue)结构模拟BFS过程,关于queue见:算法与数 ...
- 算法与数据结构基础 - 哈希表(Hash Table)
Hash Table基础 哈希表(Hash Table)是常用的数据结构,其运用哈希函数(hash function)实现映射,内部使用开放定址.拉链法等方式解决哈希冲突,使得读写时间复杂度平均为O( ...
- 算法与数据结构基础 - 二叉树(Binary Tree)
二叉树基础 满足这样性质的树称为二叉树:空树或节点最多有两个子树,称为左子树.右子树, 左右子树节点同样最多有两个子树. 二叉树是递归定义的,因而常用递归/DFS的思想处理二叉树相关问题,例如Leet ...
- 算法与数据结构基础 - 双指针(Two Pointers)
双指针基础 双指针(Two Pointers)是面对数组.链表结构的一种处理技巧.这里“指针”是泛指,不但包括通常意义上的指针,还包括索引.迭代器等可用于遍历的游标. 同方向指针 设定两个指针.从头往 ...
随机推荐
- JcApiHelper 简单好用的.Net ApiHelper
一 背景 随着前端技术的不断发展,各种框架逐渐成熟,前端 Angular,React,Vue 三分天下.再加上移动端的崛起,前后端分离开发成为主流,前端后端代码混合开发的方式沦为被淘汰的局面.如今 M ...
- c++学习书籍推荐《Exceptional C++ Style》下载
百度云及其他网盘下载地址:点我 编辑推荐 软件“风格”所要讨论的主题是如何在开销与功能之间.优雅与可维护性之间.灵活.性与过分灵活之间寻找完美的平街点.在本书中,著名的C++大师Herb Sutter ...
- 3. Django每日一码 之 Serializers 源码
2019-7-6 今日源码:rest-framework 序列化Serializers 序列化组件Serializers 源码分析 首先,它需要 data .many . instance,其中 in ...
- Java实现LRU算法
一.LRU算法简介 LRU(Least Recently Used)最近最久未使用算法 常见应用场景:内存管理中的页面置换算法.缓存淘汰中的淘汰策略等 二.实现理论 底层结构:双向链表 + HashM ...
- python接口自动化(三十四)-封装与调用--函数和参数化(详解)
简介 前面虽然实现了参数的关联,但是那种只是记流水账的完成功能,不便于维护,也没什么可读性,随着水平和技能的提升,再返回头去看前边写的代码,简直是惨不忍睹那样的代码是初级入门的代码水平都达不到.接下来 ...
- Element ui colorpicker在Vue中的使用
首先要有一个color-picker组件 <el-color-picker v-model="headcolor"></el-color-picker> 在 ...
- ZIP:ZipEntry
ZipEntry: /* 此类用于表示 ZIP 文件条目. */ ZipEntry(String name) :使用指定名称创建新的 ZIP 条目. ZipEntry(ZipEntry e) :使用从 ...
- Scrum是脆弱的,不敏捷的
正如标题所示,这篇文章是关于 Scrum 的两个不同方面.第一部分涉及 Scrum 不敏捷,第二部分涉及 Scrum 脆弱. 在详细介绍之前,简短的免责声明:我在这篇文章(以及一般博客中)中提出的所有 ...
- c++中利用宏定义简化for循环使用
话不多说,上方法 #define _for(i,a,b) for( int i=(a); i<(b); ++i) #define _rep(i,a,b) for( int i=(a); i< ...
- 【Go】类似csv的数据日志组件设计
原文链接:https://blog.thinkeridea.com/201907/go/csv_like_data_logs.html 我们业务每天需要记录大量的日志数据,且这些数据十分重要,它们是公 ...