
jieba库的应用
#!/usr/bin/python
# -*- coding:utf-8 -*-
import imp,sys
imp.reload(sys)
from matplotlib.font_manager import FontProperties
import jieba.analyse
import matplotlib.pyplot as plt
if __name__ == "__main__":
word_lst = []
key_list = []
for line in open('D://jieba_new.txt'): # 1.txt是需要分词统计的文档
item = line.strip('\n\r').split('\t') # 制表格切分
tags = jieba.analyse.extract_tags(item[0]) # jieba分词
for t in tags:
word_lst.append(t)
word_dict = {}
with open("D://word.txt", 'w') as wf2: # 打开文件
for item in word_lst:
if item not in word_dict: # 统计数量
word_dict[item] = 1
else:
word_dict[item] += 1
orderList = list(word_dict.values())
orderList.sort(reverse=True)
# print orderList
for i in range(len(orderList)):
for key in word_dict:
if word_dict[key] == orderList[i]:
if word_dict[key] > 1:
wf2.write(key + ' ' + str(word_dict[key]) + '\n') # 写入txt文档
tmp = open('D://word.txt').readlines() # 把内容一次性全部读取出来 是一个列表
set(tmp)
A = []
B = []
file = open('D:\\word1.txt')
for r in file:
imporkey = r.split(' ')[0]
sumnumber = r.split(' ')[1]
int_imporkey = str(imporkey)
int_sumnumber = str(sumnumber)
A.append(int_imporkey)
B.append(int_sumnumber)
fig = plt.figure()
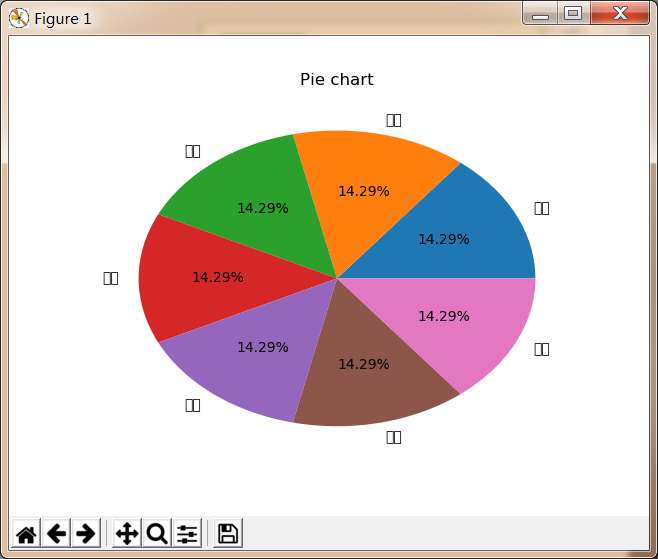
plt.pie(B,labels=A,autopct='%1.2f%%') #画饼图(数据,数据对应的标签,百分数保留两位小数点)
plt.title("Pie chart")
plt.show()
jieba库的应用的更多相关文章
- jieba库词频统计练习
在sypder上运行jieba库的代码: import matplotlib.pyplot as pltfracs = [2,2,1,1,1]labels = 'houqin', 'jiemian', ...
- 如何运用jieba库分词
使用jieba库分词 一.什么是jieba库 1.jieba库概述 jieba是优秀的中文分词第三方库,中文文本需要通过分词获得单个词语. 2.jieba库的使用:(jieba库支持3种分词模式) 通 ...
- jieba库
Note of Jieba ( 词云图实例 ) Note of Jieba jieba库是python 一个重要的第三方中文分词函数库,但需要用户自行安装. 一.jieba 库简介 (1) jieba ...
- jieba库与好玩的词云的学习与应用实现
经过了一些学习与一些十分有意义的锻(zhe)炼(mo),我决定尝试一手新接触的python第三方库 ——jieba库! 这是一个极其优秀且强大的第三方库,可以对一个文本文件的所有内容进行识别,分词,甚 ...
- jieba库的使用与词频统计
1.词频统计 (1)词频分析是对文章中重要词汇出现的次数进行统计与分析,是文本 挖掘的重要手段.它是文献计量学中传统的和具有代表性的一种内容分析方法,基本原理是通过词出现频次多少的变化,来确定热点及其 ...
- 广师大学习笔记之文本统计(jieba库好玩的词云)
1.jieba库,介绍如下: (1) jieba 库的分词原理是利用一个中文词库,将待分词的内容与分词词库进行比对,通过图结构和动态规划方法找到最大概率的词组:除此之外,jieba 库还提供了增加自定 ...
- jieba 库的使用和好玩的词云
jieba库的使用: (1) jieba库是一款优秀的 Python 第三方中文分词库,jieba 支持三种分词模式:精确模式.全模式和搜索引擎模式,下面是三种模式的特点. 精确模式:试图将语句最精 ...
- 用jieba库统计文本词频及云词图的生成
一.安装jieba库 :\>pip install jieba #或者 pip3 install jieba 二.jieba库解析 jieba库主要提供提供分词功能,可以辅助自定义分词词典. j ...
- jieba库和好玩的词云
首先,通过pip3 install jieba安装jieba库,随后在网上下载<斗破>. 代码如下: import jieba.analyse path = '小说路径' fp = ope ...
- jieba库初级应用
1.jieba库基本介绍 (1).jieba库概述 jieba是优秀的中文分词第三方库 - 中文文本需要通过分词获得单个的词语 - jieba是优秀的中文分词第三方库,需要额外安装 - ...
随机推荐
- 【Mac 快捷键】 (不定时持续更新)
显示/取消显示隐藏文件 command + shift + .
- SQL Server 2008 R2 Express Profiler
I successfully installed SQL Server Profiler 2008 R2 Profiler without uninstalling SQL 2008 R2 Expre ...
- maven第二天——重要概念与其它操作
一.在eclipse中建立工程 在day01中我们搭建了eclipse的maven环境,接下来我们开始建立maven项目 1.在eclipse中建立JAVA工程 file->new->ma ...
- lxml etree xpath
from lxml import etree #####################基本用法: ##################### html = ''' <h1 class=&quo ...
- SpringMVC初写(三)Controller的生命周期
Spring框架默认创建的对象的方式是单例,所以业务控制器Controller也是一个单例对象 由此可证明,无论是同一次请求还是同一次会话和不同请求它的对象都是相同的 然而由于对象是单例的,随之而来的 ...
- 【转载】D3DXMatrixLookAtLH视图变换函数详解
原文:D3DXMatrixLookAtLH视图变换函数详解 /*D3DXMatrixLookAtLH函数返回的是世界->视图变换矩阵. 视图坐标系和局部坐标系是一样的,都是世界坐标系转换为指定的 ...
- 【LG3722】[HNOI2017]影魔
[LG3722][HNOI2017]影魔 题面 洛谷 题解 先使用单调栈求出\(i\)左边第一个比\(i\)大的位置\(lp_i\),和右边第一个比\(i\)大的位置\(rp_i\). 考虑\(i\) ...
- wget和curl方式下载JDK
有时候我们需要在Linux服务器上安装Oracle JDK,这时候我们发现直接复制网页上面的地址是不能下载的 以下载jdk-8u101-linux-i586.tar.gz为例,右键查看到的地址为htt ...
- FileCopy方法
复制文件. 语法 FileCopy源,目标 FileCopy 语句语法包含以下命名参数: 部分 说明 source 必需. 指定要复制的文件的名称的字符串表达式. _源_可能包含目录或文件夹,和驱动器 ...
- Python之Django的Model详解
一.创建数据库 创建数据库 进入数据库: mysql -uroot -p 创建数据库: CREATE DATABASE test1 CHARSET=utf8; 连接数据库 虚拟环境中安装数据库模块:p ...