
58同城二手车数据爬虫——数字加密解码(Python原创)
一、基础首页爬取
def crawler():

  # 设置cookie

    cookie = '''cisession=19dfd70a27ec0e                                                                                                                                           t_f805f7762a9a237a0deac37015e9f6d9=1483926368'''

    header = {

        'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/53.0.2785.143 Safari/537.36',

        'Connection': 'keep-alive',

        'accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8',

        'Cookie': cookie}

    # 设置请求头,模仿浏览器访问

    # headers = {

    #     'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/80.0.3987.149 Safari/537.36'

    # }

    headers = {

        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/80.0.3987.149 Safari/537.36',

        'Referer': 'https://sg.58.com/ershouche/?spm=242729801700.bd_vid&utm_source=sem-esc-baidu-pc'}

    # 设置想要爬取的网页链接

    url = 'https://sg.58.com/ershouche/?spm=242729801700.bd_vid&utm_source=sem-esc-baidu-pc'

    response = requests.get(url, headers=headers)

    return response
二、寻找获取加密方法
2.1页面分析:
如下图页面数据展示可以看出,该数字数据被加密成特定的其他字符表示,因此我们先找到起加密方式

通过F12查看该前端样式发现,取消勾选font-family页面前后展示数据对比:


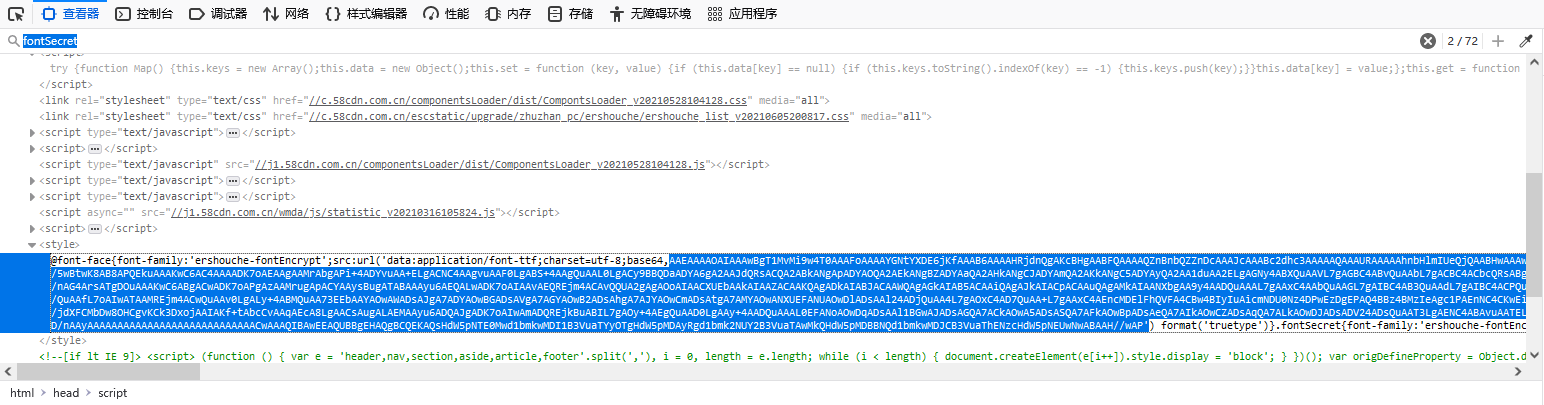
通过Ctrl+F搜索fontSecret可以看到如下内容,就是该页面的加密方式,并且经过测试发现该页面每刷新一次加密方式就会发生变化,因此我们需要通过爬虫获取每次刷新后的新加密方法:
2.2编写代码:
def parse_one_page(html):

    #使用正则表达式获取每次加密的新加密内容

    pattern = re.compile(

        '<style>.*?(AAEAAAAO.*?wAP.*?).*?</style>',

        re.S)

    items = re.findall(pattern, html)

    str = "'" + items[0].strip() + "'"

    #根据此加密内容输出woff字体文件

    bin_data = base64.decodebytes(str.encode())

    with open('58font.woff', 'wb') as f:

        f.write(bin_data)

    # print('第' + str(page_num) + '次访问网页,字体文件保存成功!')

    # 获取字体文件,将其转换为xml文件

    font = TTFont('58font.woff')

    font.saveXML('58font.xml')
三、解析xml文件
3.1文件内容
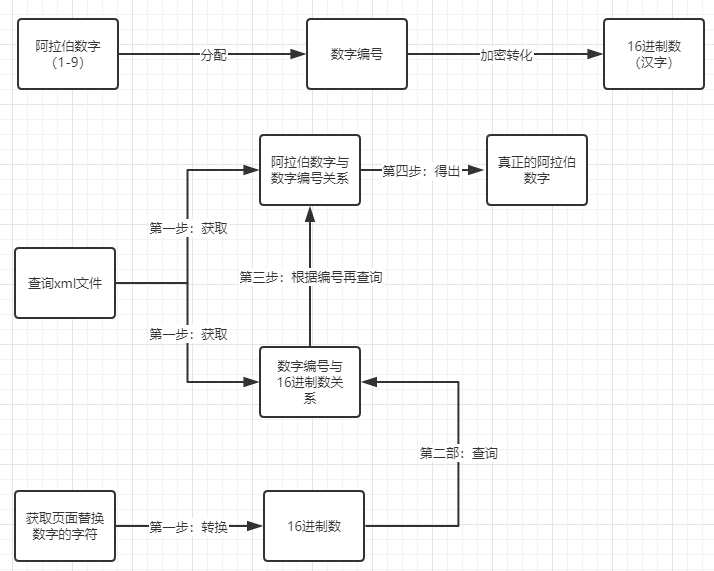
在xml文件中存在阿拉伯数字和与之对应的数字编码,需要注意的是在58同城页面升级后,这些数字编码并不捆绑阿拉伯数字,而是每次刷新进行随机分配,且(阿拉伯数字-1)=页面展示数字。
例如:在红框中id=5,其对应的uni002B反应给前台的显示数据是4,其他也是同理。

在下图中这是数字编码对应的16进制数,且数字编码也是每次刷新后重新分配给16进制数:

3.2设计代码思路
上半部分为粗略猜想的58加密方法,下半部分为解密思路
3.3代码
根据以上思路代码分为两块:
    #建立列表

    all_Price=[]

    #遍历所有汽车价格信息的列表将其转化为16进制数字后放入新的列表中

    for price in  price_list:

        str = price.get_text().replace("\n", "")

        Zu_list=[]

        #将每个汽车的价格拆封,然后一个个进行节码

        #例如“¥.-起”拆分成“¥”、“.”、“-”、“起”然后逐个解码

        for i in range(len(str)-1):

            decode_num = ord(str[i])

            # 转成16进制

            priceBaser64_Str = hex(decode_num)
       #传入方法中

            find_result=find_font(priceBaser64_Str)

            #合并解码后的阿拉伯数字得到真正的价格数字

            Zu_list.append(find_result)

        #类型转化,放入新的列表中

        all_Price.append("".join(Zu_list))

    print(all_Price)
#传入16进制数

def find_font(priceBaser64_Str):

    # 利用xpath语法匹配xml文件内容,查询以glyph开头的编码对应的数字

    font_data = etree.parse('./58font.xml')

    num_code = ['1','2','3','4','5','6','7','8','9','10']

    # 建立字典存储每次,数字编码码对应的数字编号

    # 样例格式:{'uni002B': 4, 'uni00A5': 5, 'uni65F6': 0, 'uni002D': 3, 'uni002F': 6, 'uni6298': 8, 'uni0025': 7, 'uni5143': 9, 'uni8D77': 1, 'uni4E07': 2}

    glyph_list ={}

    for number in num_code:

        glyph_reslut=font_data.xpath("//GlyphOrder//GlyphID[@id='{}']/@name".format(number))[0]

        glyph_list[glyph_reslut] = int(number)-1

    # 除了随机的数字编码对应的16进制数外,还有“.”则固定对应0x2e

    # 依次循环查找xml文件里code对应的name

    if priceBaser64_Str == '0x2e':

        result='.'

        return result

        #num_list.append(result)

        #print(result)

    else:

        #使用xpath查询方式根据传进来的16进制数寻找对应的数字编号,再通过数字编号去遍历建立好的glyph_list找出对应的阿拉伯数字

        result = font_data.xpath("//cmap_format_4//map[@code='{}']/@name".format(priceBaser64_Str))[0]

        # 循环字典的key,如果code对应的name与字典的key相同,则得到key对应的value

        for key in glyph_list.keys():

            if result == key:

                familly_result = str(glyph_list[key])

                return familly_result

    #print('已成功找到编码所对应的数字!')
四、最终写出xml文件保存
全部代码:
from fontTools.misc import etree

from fontTools.ttLib import TTFont

import base64

import xlsxwriter

import re

import requests

from bs4 import BeautifulSoup

#传入16进制数

def find_font(priceBaser64_Str):

    # 利用xpath语法匹配xml文件内容,查询以glyph开头的编码对应的数字

    font_data = etree.parse('./58font.xml')

    num_code = ['1','2','3','4','5','6','7','8','9','10']

    # 建立字典存储每次,数字编码码对应的数字编号

    # 样例格式:{'uni8D77': '2', 'uni0025': '8', 'uni5143': '10', 'uni002B': '5', 'uni4E07': '3', 'uni6298': '9', 'uni00A5': '6', 'uni65F6': '1', '.notdef': '0', 'uni002F': '7', 'uni002D': '4'}

    glyph_list ={}

    for number in num_code:

        glyph_reslut=font_data.xpath("//GlyphOrder//GlyphID[@id='{}']/@name".format(number))[0]

        glyph_list[glyph_reslut] = int(number)-1

    # 除了随机的数字编码对应的16进制数外,还有“.”则固定对应0x2e

    # 依次循环查找xml文件里code对应的name

    if priceBaser64_Str == '0x2e':

        result='.'

        return result

        #num_list.append(result)

        #print(result)

    else:

        #使用xpath查询方式根据传进来的16进制数寻找对应的数字编号,再通过数字编号去遍历建立好的glyph_list找出对应的阿拉伯数字

        result = font_data.xpath("//cmap_format_4//map[@code='{}']/@name".format(priceBaser64_Str))[0]

        # 循环字典的key,如果code对应的name与字典的key相同,则得到key对应的value

        for key in glyph_list.keys():

            if result == key:

                familly_result = str(glyph_list[key])

                return familly_result

    #print('已成功找到编码所对应的数字!')

def parse_one_page(html):

    #使用正则表达式获取每次加密的新加密内容

    pattern = re.compile(

        '<style>.*?(AAEAAAAO.*?wAP.*?).*?</style>',

        re.S)

    items = re.findall(pattern, html)

    str = "'" + items[0].strip() + "'"

    #根据此加密内容输出woff字体文件

    bin_data = base64.decodebytes(str.encode())

    with open('58font.woff', 'wb') as f:

        f.write(bin_data)

    # print('第' + str(page_num) + '次访问网页,字体文件保存成功!')

    # 获取字体文件,将其转换为xml文件

    font = TTFont('58font.woff')

    font.saveXML('58font.xml')

    # for item in items:

    #     print(item)

    #     yield {

    #         'index':items[0],

    #         'image':items[1].,

    #         'title':items[2],

    #     }

def crawler():

    cookie = '''cisession=19dfd70a27ec0                                                                                                     t_f805f7762a9a237a0deac37015e9f6d9=1482722012,1483926313;Hm_lpvt_f805f7762a9a237a0deac37015e9f6d9=1483926368'''

    header = {

        'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/53.0.2785.143 Safari/537.36',

        'Connection': 'keep-alive',

        'accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8',

        'Cookie': cookie}

    # 设置请求头,模仿浏览器访问

    # headers = {

    #     'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/80.0.3987.149 Safari/537.36'

    # }

    headers = {

        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/80.0.3987.149 Safari/537.36',

        'Referer': 'https://sg.58.com/ershouche/?spm=242729801700.bd_vid&utm_source=sem-esc-baidu-pc'}

    # 设置想要爬取的网页链接

    # url = 'https://nn.58.com/ershouche/?utm_source=market&spm=u-2d2yxv86y3v43nkddh1.BDPCPZ_BT&PGTID=0d100000-0034-d9f8-fe87-cbe415320007&ClickID=4'

    url = 'https://sg.58.com/ershouche/?spm=242729801700.bd_vid&utm_source=sem-esc-baidu-pc'

    response = requests.get(url, headers=headers)

    return response

#爬虫数据转为xmlx文本写出

def writer_xml(response,sheetHeaders):

    #转化为文本格式

    content = response.content

    soup = BeautifulSoup(content, 'lxml')

    # 创建名为58car.xlsx的excel文件

    workbook = xlsxwriter.Workbook('19ar.xlxs')

    # 在excel文件中添加一个sheet工作表

    worksheet = workbook.add_worksheet('韶关')

    # 获取所有的汽车名称,并存储在一个列表里

    name_list = soup.find_all('span', attrs={'class': 'info_link'})

    # 获取所有的汽车描述信息,并存储在一个列表里

    describe_list = soup.find_all('div', attrs={'class': 'info_params'})

    # 获取所有的汽车价格信息,并存储在一个列表里

    price_list = soup.find_all('div', attrs={'class': 'info--price'})

    #建立列表

    all_Price=[]

    #遍历所有汽车价格信息的列表将其转化为16进制数字后放入新的列表中

    for price in  price_list:

        str = price.get_text().replace("\n", "")

        Zu_list=[]

        #将每个汽车的价格拆封,然后一个个进行节码

        #例如“¥.-起”拆分成“¥”、“.”、“-”、“起”然后逐个节码

        for i in range(len(str)-1):

            decode_num = ord(str[i])

            # 转成16进制

            priceBaser64_Str = hex(decode_num)

            find_result=find_font(priceBaser64_Str)

            #合并解码后的阿拉伯数字得到真正的价格数字

            Zu_list.append(find_result)

        #类型转化,放入新的列表中

        all_Price.append("".join(Zu_list))

    print(all_Price)

    # 设置表头

    for i in range(0,len(sheetHeaders)):

        worksheet.write(0, i, sheetHeaders[i])

    # 通过len()方法得到汽车信息个数并进行遍历

    for i in range(len(name_list)):

        # 在第i行第1列写入第i辆汽车的名称

        worksheet.write(i + 1, 0, name_list[i].get_text().replace("\n", ""))

        # 在第i行第2列写入第i辆汽车的描述信息

        worksheet.write(i + 1, 1, describe_list[i].get_text())

        # 在第i行第3列写入第i辆汽车的价格信息

        worksheet.write(i + 1, 2, all_Price[i])

    # 数据写入完毕后将表格关闭

    workbook.close()

if __name__ == '__main__':

    sheetHeaders = ["汽车名称","描述信息","价格信息"]

    html = crawler()

    parse_one_page(html.text)

    writer_xml(html,sheetHeaders)
五、注意事项(可能出现的错误)
由于每次都需要重新导出xml文件并对其进行解析,因此建议使用者在对所有需要导出的文件命名时采用“随机码”或“时间”的方式对其进行命名,或则在运行前删除代码存放目录下所有之前导出的文件,否则重新运行会因为旧的xml无法被覆盖而导致解析出来的的是旧的对应关系,出现实际解码后的数据错误。
58同城二手车数据爬虫——数字加密解码(Python原创)的更多相关文章
- 利用python爬取58同城简历数据
利用python爬取58同城简历数据 利用python爬取58同城简历数据 最近接到一个工作,需要获取58同城上面的简历信息(http://gz.58.com/qzyewu/).最开始想到是用pyth ...
- 养只爬虫当宠物(Node.js爬虫爬取58同城租房信息)
先上一个源代码吧. https://github.com/answershuto/Rental 欢迎指导交流. 效果图 搭建Node.js环境及启动服务 安装node以及npm,用express模块启 ...
- 用Python写爬虫爬取58同城二手交易数据
爬了14W数据,存入Mongodb,用Charts库展示统计结果,这里展示一个示意 模块1 获取分类url列表 from bs4 import BeautifulSoup import request ...
- python3爬虫-爬取58同城上所有城市的租房信息
from fake_useragent import UserAgent from lxml import etree import requests, os import time, re, dat ...
- Python爬虫(四)——开封市58同城数据模型训练与检测
前文参考: Python爬虫(一)——开封市58同城租房信息 Python爬虫(二)——对开封市58同城出租房数据进行分析 Python爬虫(三)——对豆瓣图书各模块评论数与评分图形化分析 数据的构建 ...
- 转载:MongoDB 在 58 同城百亿量级数据下的应用实践
为什么要使用 MongoDB? MongoDB 这个来源英文单词“humongous”,homongous 这个单词的意思是“巨大的”.“奇大无比的”,从 MongoDB 单词本身可以看出它的目标是提 ...
- 【原创】Python 二手车之家车辆档案数据爬虫
本文仅供学习交流使用,如侵立删! 二手车之家车辆档案数据爬虫 先上效果图 环境 win10 python3.9 lxml.retrying.requests 需求分析 需求: 主要是需要车辆详情页中车 ...
- 58同城AES签名接口分析
背景:需要获取58同城上面发布的职位信息,其中的包括职位的招聘要求,薪资福利,公司的信息,招聘者的联系方式.(中级爬虫的难度系数) 职位详情页分析 某个职位详情页的链接 https://qy.m.58 ...
- 58同城高性能移动Push推送平台架构演进之路
本文详细讲述58同城高性能移动Push推送平台架构演进的三个阶段,并介绍了什么是移动Push推送,为什么需要,原理和方案对比:移动Push推送第一阶段(单平台)架构如何设计:移动Push推送典型性能问 ...
- 转: 58同城高性能移动Push推送平台架构演进之路
转: http://geek.csdn.net/news/detail/58738 文/孙玄 本文详细讲述58同城高性能移动Push推送平台架构演进的三个阶段,并介绍了什么是移动Push推送,为什么需 ...
随机推荐
- 手记系列之五 ----- SQL使用经验分享
前言 本篇文章主要介绍的关于本人从刚工作到现在使用Sql一些使用方法和经验,从最基本的SQL函数使用,到一些场景的业务场景SQL编写. SQL基础函数使用 1.字段转换 CASE WHEN 意义: ...
- 如何吃透一个Java项目?
现在Austin的文档我觉得还是比较全的,但到了看代码的时候,可能有的同学就不知道应该怎么看,有想知道模块之间的调用链路,有想一点一点把细节给全看了.这时候就很可能在项目里犯迷糊了,绕不出不来了. J ...
- Rust 通用编程概念
通用编程概念 变量.基本类型.函数.控制流 变量与可变性 rust中的变量默认是不可变的,这样是为了能够让你安全并且方便地写出复杂.甚至并行的代码. 当一个变量是不可变时,一旦它绑定到了某个值上面,这 ...
- docker部署springboot项目到服务器
docker部署springboot demo到vps docker安装 首先检查docker是否安装 docker version 出现上述界面就是安装成功 如果没有安装docker的话,运行以下命 ...
- JavaCV的摄像头实战之八:人脸检测
欢迎访问我的GitHub 这里分类和汇总了欣宸的全部原创(含配套源码):https://github.com/zq2599/blog_demos 本篇概览 本文是<JavaCV的摄像头实战> ...
- Python 标准类库-并发执行之multiprocessing-基于进程的并行
实践环境 Python3.6 介绍 multiprocessing是一个支持使用类似于线程模块的API派生进程的包.该包同时提供本地和远程并发,通过使用子进程而不是线程,有效地避开了全局解释器锁.因此 ...
- Transformer编码器和解码器被广泛应用于自然语言处理、计算机视觉、语音识别等领域。下面是一些Trans
目录 1. 引言 2. 技术原理及概念 2.1 基本概念解释 2.1.1 编码器 2.1.2 解码器 2.2 技术原理介绍 2.2.1 编码器 2.2.2 解码器 2.3 相关技术比较 3. 实现步骤 ...
- 11k+ Star 一款更适合中国用户的开源 BI 工具
在当今数字化时代,数据分析和可视化成为企业决策和发展的重要支撑,很多 BI 工具昂贵的许可费用,让许多中小型企业用户和个人用户望而却步,开源 BI 工具的出现,让其成为很多用户进行数据分析展示的首选. ...
- mysql处理delete后不释放磁盘空间
myisam:optimize table table_name innodb:alter table table.name engine='innodb' 1. 问题描述在使用mysql的时候有时候 ...
- 【Oracle】当条件中存在空值时,同时将空值和非空值的结果查询出来
[Oracle]当条件中存在空值时,同时将空值和非空值的结果查询出来 如果不是一定要用这个存在空值的条件的话,最好还是不用为好,省的麻烦 正常的查询结果如下 select * from ttt2023 ...