
数据挖掘算法——K-means算法
k-means中文称为K均值聚类算法,在1967年就被提出 所谓聚类就是将物理或者抽象对象的集合分组成为由类似的对象组成的多个簇的过程
聚类生成的组成为簇 簇内部任意两个对象之间具有较高的相似度,不同簇的两个对象之间具有较高的相异度
相异度和相似度可以根据描述的对象的属性值来计算 对象间的距离是最常采用的相异度度量指标
常用的距离方法有
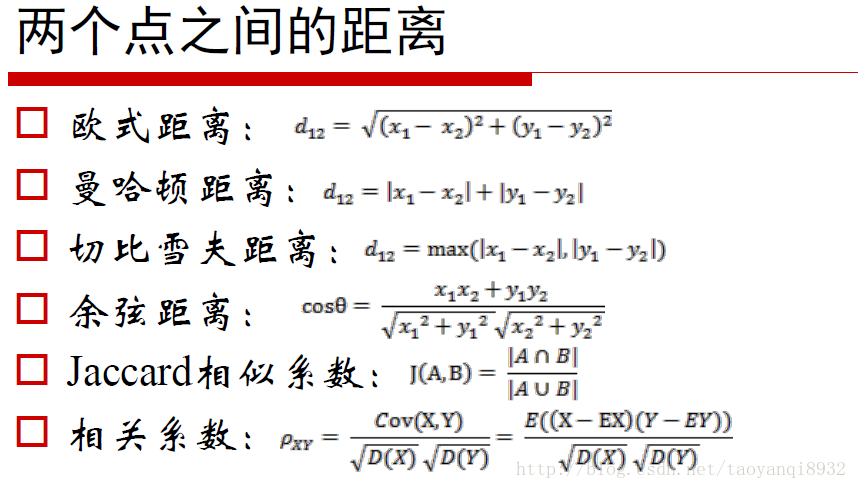
k-means是基于划分的方法 就是通过迭代将数据对象划分为k个组每个组为一个簇
每个分组至少包含一个对象
每个对象属于且仅属于某个分组
输入:簇的数目K和包含n个对象的数据集D
输出:K个簇的集合
方法:
1.从D中任意选择K个对象作为初始簇的质心;
2.计算每个对象与各簇质心的距离,并且将对象划分到距离其更近的簇
3.更新每个新簇的质心
4.重复2.3步骤,直到簇中的对象不再变化
对K-means算法的几点说明
1.簇的质心就是簇中所有对象在每一维属性的举止组合成的虚拟点 并非实际存在的数据点
2.对噪声和离群(孤立)点数据是敏感,因为它们的存在会对均值的计算产生极大的影响
3.对象到质心的距离通常使用欧式距离来计算
4.要求用户实现给出生成的数目,要求K值已直
5.算法收敛的速度和结果容易受初始质心的影响
来个例子:
数据集:
n = 8, k = 2;取1和3为初始点
|
序号 |
属性1 |
属性2 |
|
1 |
1 |
1 |
|
2 |
2 |
1 |
|
3 |
1 |
2 |
|
4 |
2 |
2 |
|
5 |
4 |
3 |
|
6 |
5 |
3 |
|
7 |
4 |
4 |
|
8 |
5 |
4 |
 #include<bits/stdc++.h>

 using namespace std;

 struct Node

 {

     int id;

     double a, b;

 }node[];

 vector<int>beginn[],endd[];

 int flag = ;

 double distance(pair<double,double>a, Node b){

     return (b.a - a.first) * (b.a - a.first) + (b.b - a.second) * (b.b - a.second);

 }

 bool check(int k )

 {

     if(flag == )

     {

         flag = ;

         return false;

     }

     for(int i =  ; i < k ; i ++)

     {

         if(beginn[i].size() != endd[i].size())

             return false;

         for(int j =  ; j < endd[i].size(); j++)

         {

             if(endd[i][j] != beginn[i][j])

                 return false;

         }

     }

     return true;

 }

 int main()

 {

     int n, k;

     cin >> n >> k;

     for(int i = ; i <= n; i ++)

         cin >> node[i].id >> node[i].a >> node[i].b;

     vector<double>vec[];

     vector< pair<double, double> > gg;

     for(int i = ; i <= k; i ++)

     {

         int x;

         cin >> x;

         gg.push_back(make_pair(node[x].a,node[x].b));

     }//只要把这些点当作是初始点就可以  与其他的点无关即可

     while(true)

     {

         for(int i =  ; i < k; i++)

         {

             beginn[i].assign(endd[i].begin(), endd[i].end());

             endd[i].clear();

         }

         for(int i = ; i < k; i ++) //表示有k个堆 计算每个堆里面的值

         {

             vec[i].clear();

             for(int j = ; j <= n ; j ++)

                 vec[i].push_back(distance(gg[i] , node[j]));//计算的是每个点到初始点的距离

         }

         for(int i =  ;i < n ; i ++)

         {

             double minn = 0x3f3f3f3f;

             int u = -;

             for(int j = ; j < k; j ++){

                 if(vec[j][i] < minn){

                     minn = vec[j][i];

                     u = j;//表示的是哪个簇的

                 }

             }

             endd[u].push_back(i + );

         }

         cout<<"新计算得到的"<<endl;

         for(int i =  ; i < k ; i ++)

         {

             for(int j =  ; j < endd[i].size(); j ++)

                 printf("%d ",endd[i][j]);

             printf("\n");

         }

         cout<<"原本的"<<endl;

         for(int i =  ; i < k ; i ++)

         {

             for(int j =  ; j < beginn[i].size(); j ++)

                 printf("%d ",beginn[i][j]);

             printf("\n");

         }

         gg.clear();

         for(int i =  ; i < k ; i ++)

         {

             double sum1 = , sum2 = ;

             for(int j =  ; j < endd[i].size(); j ++)

             {

                 sum1 += node[endd[i][j]].a;

                 sum2 += node[endd[i][j]].b;

             }

             sum1 = sum1 / endd[i].size();

             sum2 = sum2 / endd[i].size();

             gg.push_back(make_pair(sum1,sum2));     //得到的新的值

         }

         cout<<"新的平均值:"<<endl;

         for(int i =  ; i < k ;i ++)

             cout<<gg[i].first <<"        " << gg[i].second<<endl;

         cout<<endl;

         if(check(k))

             return ;

     }

     return ;

 }
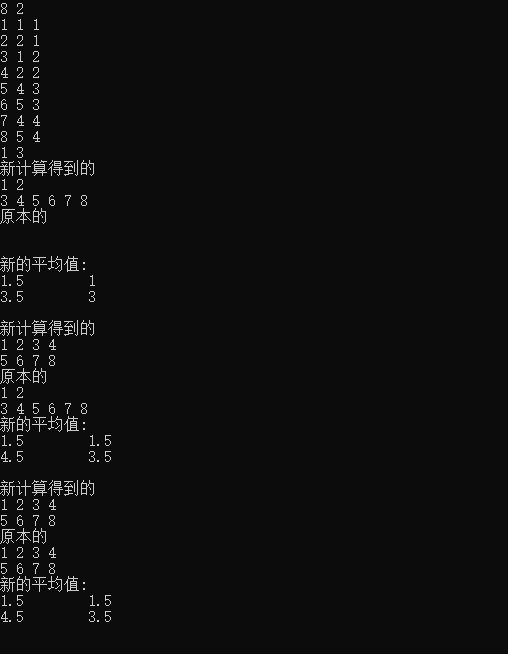
结果可得
参考来自:
https://www.jianshu.com/p/4f032dccdcef
https://www.icourse163.org/course/CUG-1003556007?utm_campaign=share&utm_medium=androidShare&utm_source=
数据挖掘算法——K-means算法的更多相关文章
- 第4章 最基础的分类算法-k近邻算法
思想极度简单 应用数学知识少 效果好(缺点?) 可以解释机器学习算法使用过程中的很多细节问题 更完整的刻画机器学习应用的流程 distances = [] for x_train in X_train ...
- 聚类算法:K-means 算法(k均值算法)
k-means算法: 第一步:选$K$个初始聚类中心,$z_1(1),z_2(1),\cdots,z_k(1)$,其中括号内的序号为寻找聚类中心的迭代运算的次序号. 聚类中心的向量值可任意设 ...
- 分类算法----k近邻算法
K最近邻(k-Nearest Neighbor,KNN)分类算法,是一个理论上比较成熟的方法,也是最简单的机器学习算法之一.该方法的思路是:如果一个样本在特征空间中的k个最相似(即特征空间中最邻近)的 ...
- 机器学习(四) 机器学习(四) 分类算法--K近邻算法 KNN (下)
六.网格搜索与 K 邻近算法中更多的超参数 七.数据归一化 Feature Scaling 解决方案:将所有的数据映射到同一尺度 八.scikit-learn 中的 Scaler preprocess ...
- 机器学习(四) 分类算法--K近邻算法 KNN (上)
一.K近邻算法基础 KNN------- K近邻算法--------K-Nearest Neighbors 思想极度简单 应用数学知识少 (近乎为零) 效果好(缺点?) 可以解释机器学习算法使用过程中 ...
- python 机器学习(二)分类算法-k近邻算法
一.什么是K近邻算法? 定义: 如果一个样本在特征空间中的k个最相似(即特征空间中最邻近)的样本中的大多数属于某一个类别,则该样本也属于这个类别. 来源: KNN算法最早是由Cover和Hart提 ...
- KNN 与 K - Means 算法比较
KNN K-Means 1.分类算法 聚类算法 2.监督学习 非监督学习 3.数据类型:喂给它的数据集是带label的数据,已经是完全正确的数据 喂给它的数据集是无label的数据,是杂乱无章的,经过 ...
- 分类算法——k最近邻算法(Python实现)(文末附工程源代码)
kNN算法原理 k最近邻(k-Nearest Neighbor)算法是比较简单的机器学习算法.它采用测量不同特征值之间的距离方法进行分类,思想很简单:如果一个样本在特征空间中的k个最近邻(最相似)的样 ...
- 【学习笔记】分类算法-k近邻算法
k-近邻算法采用测量不同特征值之间的距离来进行分类. 优点:精度高.对异常值不敏感.无数据输入假定 缺点:计算复杂度高.空间复杂度高 使用数据范围:数值型和标称型 用例子来理解k-近邻算法 电影可以按 ...
- 【机器学习】聚类算法——K均值算法(k-means)
一.聚类 1.基于划分的聚类:k-means.k-medoids(每个类别找一个样本来代表).Clarans 2.基于层次的聚类:(1)自底向上的凝聚方法,比如Agnes (2)自上而下的分裂方法,比 ...
随机推荐
- 一次面试留下的实际应用问题。关于HttpModule,IIS集成模式。
资料来自<IIS7开发与管理完全手册> 周五面试时有点紧张,没能静下心思考,当时隐约想到这个解决方案,但因面试环境和心态确未能明确的表述. 回家的地铁上已经找到解决办法. 要点:1基于IH ...
- 转发: python3.7下 Flask-SQLAlchemy中解决1366报错
原链接:https://segmentfault.com/a/1190000010596306 详情: 安装MySQL驱动(我升级过Python,所以要再装一遍) 本想安装MySQL官方驱动mysql ...
- Java 中Enum的使用与分析
https://www.cnblogs.com/softidea/p/3760235.html https://blog.csdn.net/qq_27093465/article/details/52 ...
- Ionic3学习笔记(十)实现夜间模式功能
本文为原创文章,转载请标明出处 目录 创建主题样式 导入 variables.scss 创建 provider 创建 page 在 App 入口处应用主题 效果图 1. 创建主题样式 在 ./src/ ...
- Appium移动自动化测试实例-基于python
一.环境搭建 安装Android 环境变量.SDK.Android API.ADT等. 步骤1 安装SDK:下载地址为https://pan.baidu.com/s/1mi6PT9m.如提示错误:' ...
- XML的四种解析器(dom_sax_jdom_dom4j)原理及性能比较[收藏]
1)DOM(JAXP Crimson解析器) DOM是用与平台和语言无关的方式表示XML文档的官方W3C标准.DOM是以层次结构组织的节点或信息片断的集合.这个层次结构允许开发人员在树中寻找特定 ...
- 北京VS上海:“活着为了工作”还是“工作为了生活”?
Costco开业你去现场了吗?人口普查似的排队场面对于上海人来说已经不稀奇,毕竟当新鲜的商品或是业态来到中国时,上海常常是第一站.但当Costco的新闻不断发酵的同时,在互联网的角落里也有一群人提出了 ...
- GDB调试指南-单步调试
前言 前面通过<启动调试>,<断点设置>,<变量查看>,我们已经了解了GDB基本的启动,设置断点,查看变量等,如果这些内容你还不知道,建议先回顾一下前面的内容.在启 ...
- nGrinder 介绍与安装
nGrinder是基于Grinder开源项目,但由NHN公司的nGrinder开发团队进行了重新设计和完善(所以叫做nGrinder). 它是由一个controller和连接它的多个agent组成,用 ...
- 浅谈在ES5环境下实现const
最近看到一个面试题--用ES5实现const.作为JS初学者的笔者知道在ES6中有const命令,可以用来声明常量,一旦声明,常量的值就不可改变.例如: 1234567891011 const Pi ...