
Python爬虫教程-03-使用 chardet 检测编码
Spider-03-使用chardet
继续学习python爬虫,我们经常出现解码问题,因为所有的页面编码都不统一,我们使用chardet检测页面的编码,尽可能的减少编码问题的出现
网页编码问题解决
- 使用chardet 可以自动检测页面文件的编码格式,但是也有可能出错
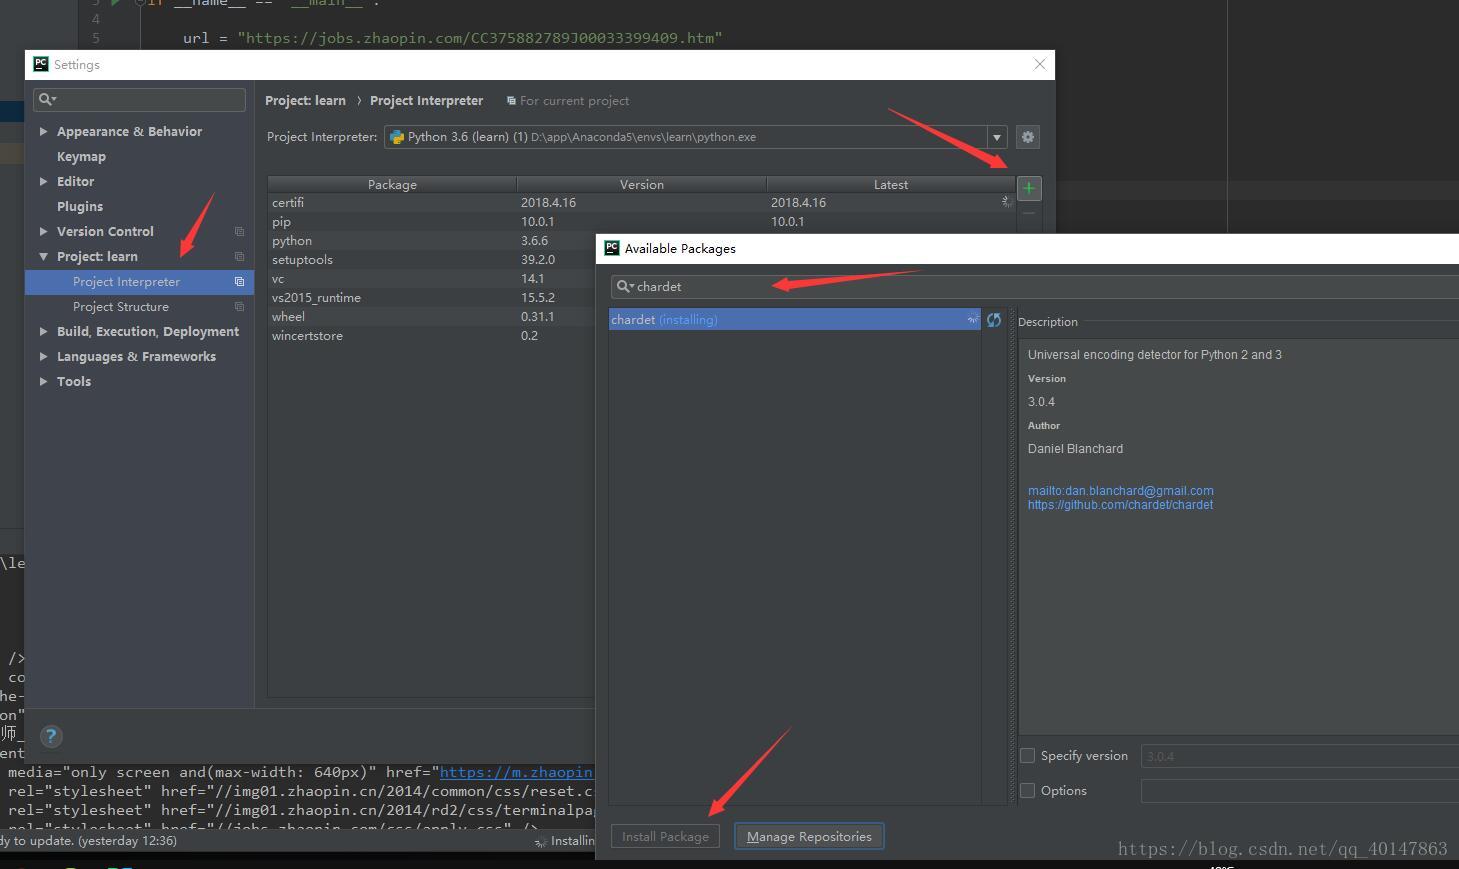
- 需要安装chardet,
- 如果使用Anaconda环境,使用下面命令:
conda install chardet
- 如果不是,就自己手动在【PyCharm】>【file】>【settings】>【Project Interpreter】>【+】>【chardet】>【install】
具体操作截图:
案例v2
- py03chardet.py文件:https://xpwi.github.io/py/py爬虫/py03chardet.py
# py03chardet.py

# 使用request下载页面,并自动检测页面编码

from urllib import request

import chardet

if __name__ == '__main__':

    url = 'https://jobs.zhaopin.com/CC375882789J00033399409.htm'

    rsp = request.urlopen(url)

    # 按住Ctrl键不送,同时点击urlopen,可以查看文档,有函数的具体参数和使用方法

    html = rsp.read()

    cs = chardet.detect(html)

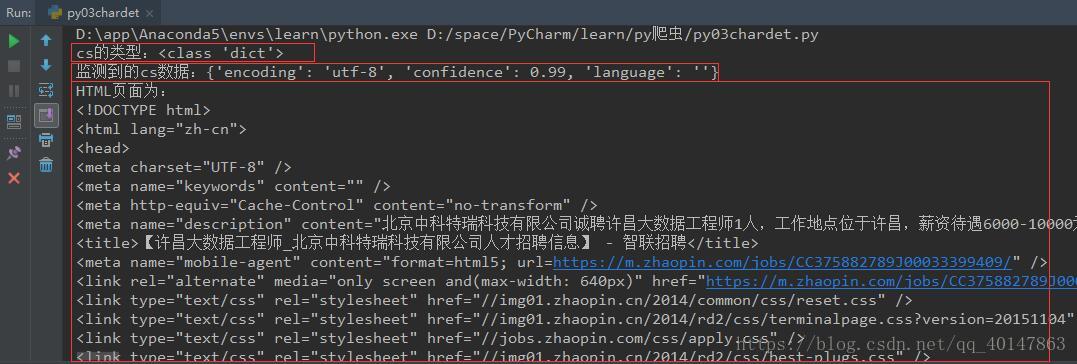
    print("cs的类型:{0}".format(type(cs)))

    print("监测到的cs数据:{0}".format(cs))

    html = html.decode(cs.get("encoding", "utf-8"))

    # 意思是监测到就使用监测到的,监测不到就使用utf-8

    print("HTML页面为:\n%s" % html)
右键运行,截图如下
编码检测就介绍完了,最要的功能是检测页面的编码,尽可能的减少编码问题的出现
更多文章链接:Python 爬虫随笔
- 本笔记不允许任何个人和组织转载
Python爬虫教程-03-使用 chardet 检测编码的更多相关文章
- Python爬虫教程-01-爬虫介绍
Spider-01-爬虫介绍 Python 爬虫的知识量不是特别大,但是需要不停和网页打交道,每个网页情况都有所差异,所以对应变能力有些要求 爬虫准备工作 参考资料 精通Python爬虫框架Scrap ...
- Python爬虫教程-00-写在前面
鉴于好多人想学Python爬虫,缺没有简单易学的教程,我将在CSDN和大家分享Python爬虫的学习笔记,不定期更新 基础要求 Python 基础知识 Python 的基础知识,大家可以去菜鸟教程进行 ...
- Python爬虫教程-31-创建 Scrapy 爬虫框架项目
本篇是介绍在 Anaconda 环境下,创建 Scrapy 爬虫框架项目的步骤,且介绍比较详细 Python爬虫教程-31-创建 Scrapy 爬虫框架项目 首先说一下,本篇是在 Anaconda 环 ...
- Python爬虫教程-30-Scrapy 爬虫框架介绍
从本篇开始学习 Scrapy 爬虫框架 Python爬虫教程-30-Scrapy 爬虫框架介绍 框架:框架就是对于相同的相似的部分,代码做到不出错,而我们就可以将注意力放到我们自己的部分了 常见爬虫框 ...
- Python爬虫教程-08-post介绍(百度翻译)(下)
Python爬虫教程-08-post介绍(下) 为了更多的设置请求信息,单纯的通过urlopen已经不太能满足需求,此时需要使用request.Request类 构造Request 实例 req = ...
- Python爬虫教程-07-post介绍(百度翻译)(上)
Python爬虫教程-07-post介绍(百度翻译)(上) 访问网络两种方法 get: 利用参数给服务器传递信息 参数为dict,使用parse编码 post :(今天给大家介绍的post) 一般向服 ...
- Python爬虫教程-28-Selenium 操纵 Chrome
我觉得本篇是很有意思的,闲着没事来看看! Python爬虫教程-28-Selenium 操纵 Chrome PhantomJS 幽灵浏览器,无界面浏览器,不渲染页面.Selenium + Phanto ...
- Python爬虫教程-23-数据提取-BeautifulSoup4(一)
Beautiful Soup是python的一个库,最主要的功能是从网页抓取数据,查看文档 https://www.crummy.com/software/BeautifulSoup/bs4/doc. ...
- Python爬虫教程-19-数据提取-正则表达式(re)
本篇主页内容:match的基本使用,search的基本使用,findall,finditer的基本使用,匹配中文,贪婪与非贪婪模式 Python爬虫教程-19-数据提取-正则表达式(re) 正则表达式 ...
随机推荐
- Github概念理解备忘录
总结: add就是用来建立跟踪,添加文件到缓存区: commit就是把文件缓存区的文件正式加到本地库中: push就是把本地库更新到远程库中: git命令的操作要在仓库所在目录下进行才有效: 在Git ...
- scrapyd的安装
.安装 pip3 install scrapyd 二.配置 安装完毕之后,需要新建一个配置文件/etc/scrapyd/scrapyd.conf,Scrapyd在运行的时候会读取此配置文件. 在Scr ...
- How to install Jenkins on CentOS 7
How to install Jenkins on CentOS 7 on March 3, 2018 by AmirLeave a comment Introduction Jenkins is a ...
- Mac下使用PF进行端口转发和防火墙配置(类似Linux的iptables)
在Mac没有iptables这些,替代的软件为PF,命令为pfctl.在早些版本用ipfw(<=10.10),后面改为PF.还有一些可以使用OpenBsd,不过这个不太好用. 网上关于pfctl ...
- Hello Jexus(转并修改)
一.关于 CentOS CentOS(Community ENTerprise Operating System)是Linux发行版之一,它是来自于Red Hat Enterprise Linux依照 ...
- Jexus进程守护工具jws.guard
一个运行中的进程,难免会因为各种各样的原因无缘无故的宕掉(比如网站瞬间的负载过高.内存不足等),而Jexus宕掉的后果往往只有一个:对外提供服务的网站无法访问了.因此,我们需要最大限度的保障我们的网站 ...
- PHPStorm操作小技巧
1.围绕选中字符输入引号或者括号 2.设置服务器部署 3.隐藏Project快捷键 Shift + Esc 4.IDE内窗口切换 Ctrl + TAB 5.关闭当前项目 File -> Clos ...
- StackMapTable属性说明
(1)StackMapTable属性的说明 https://docs.oracle.com/javase/specs/jvms/se7/html/jvms-4.html#jvms-4.7.4 (2)S ...
- js关闭当前页面
<a href="javascript:window.opener=null;window.open('','_self');window.close();">关闭&l ...
- CSS小技巧(一)
左右布局 将内部的子元素加浮动,父元素清除浮动即可. 代码: <!DOCTYPE html> <html> <head> <title>test< ...