
Flink JobManager HA模式部署(基于Standalone)
参考文章:https://ci.apache.org/projects/flink/flink-docs-release-1.3/setup/jobmanager_high_availability.html#bootstrap-zookeeper
Flink典型的任务处理过程如下所示:

很容易发现,JobManager存在单点故障(SPOF:Single Point Of Failure),因此对Flink做HA,主要是对JobManager做HA,根据Flink集群的部署模式不同,分为Standalone、OnYarn,本文主要涉及Standalone模式。
JobManager的HA,是通过Zookeeper实现的,因此需要先搭建好Zookeeper集群,同时HA的信息,还要存储在HDFS中,因此也需要Hadoop集群,最后修改Flink中的配置文件。
一、部署Zookeeper集群
参考博文:http://www.cnblogs.com/liugh/p/6671460.html
二、部署Hadoop集群
参考博文:http://www.cnblogs.com/liugh/p/6624872.html
三、部署Flink集群
参考博文:http://www.cnblogs.com/liugh/p/7446295.html
四、conf/flink-conf.yaml修改
4.1 必选项
high-availability: zookeeper

high-availability.zookeeper.quorum: DEV-SH-MAP-:,DEV-SH-MAP-:,DEV-SH-MAP-:

high-availability.zookeeper.storageDir: hdfs:///flink/ha
4.2 可选项
high-availability.zookeeper.path.root: /flink

high-availability.zookeeper.path.cluster-id: /map_flink
修改完后,使用scp命令将flink-conf.yaml文件同步到其他节点
五、conf/masters修改
设置要启用JobManager的节点及端口:
dev-sh-map-:

dev-sh-map-:
修改完后,使用scp命令将masters文件同步到其他节点
六、conf/zoo.cfg修改
# ZooKeeper quorum peers

server.=DEV-SH-MAP-::

server.=DEV-SH-MAP-::

server.=DEV-SH-MAP-::
修改完后,使用scp命令将masters文件同步到其他节点
七、启动HDFS
[root@DEV-SH-MAP- conf]# start-dfs.sh

Starting namenodes on [DEV-SH-MAP-]

DEV-SH-MAP-: starting namenode, logging to /usr/hadoop-2.7./logs/hadoop-root-namenode-DEV-SH-MAP-.out

DEV-SH-MAP-: starting datanode, logging to /usr/hadoop-2.7./logs/hadoop-root-datanode-DEV-SH-MAP-.out

DEV-SH-MAP-: starting datanode, logging to /usr/hadoop-2.7./logs/hadoop-root-datanode-DEV-SH-MAP-.out

DEV-SH-MAP-: starting datanode, logging to /usr/hadoop-2.7./logs/hadoop-root-datanode-DEV-SH-MAP-.out

Starting secondary namenodes [0.0.0.0]

0.0.0.0: starting secondarynamenode, logging to /usr/hadoop-2.7./logs/hadoop-root-secondarynamenode-DEV-SH-MAP-.out
八、启动Zookeeper集群
[root@DEV-SH-MAP- conf]# start-zookeeper-quorum.sh

Starting zookeeper daemon on host DEV-SH-MAP-.

Starting zookeeper daemon on host DEV-SH-MAP-.

Starting zookeeper daemon on host DEV-SH-MAP-.
【注】这里使用的命令start-zookeeper-quorum.sh是FLINK_HOME/bin中的脚本
九、启动Flink集群
[root@DEV-SH-MAP- conf]# start-cluster.sh

Starting HA cluster with  masters.

Starting jobmanager daemon on host DEV-SH-MAP-.

Starting jobmanager daemon on host DEV-SH-MAP-.

Starting taskmanager daemon on host DEV-SH-MAP-.

Starting taskmanager daemon on host DEV-SH-MAP-.

Starting taskmanager daemon on host DEV-SH-MAP-.
可以看到,启动了两个JobManager,一个Leader,一个Standby
十、测试HA
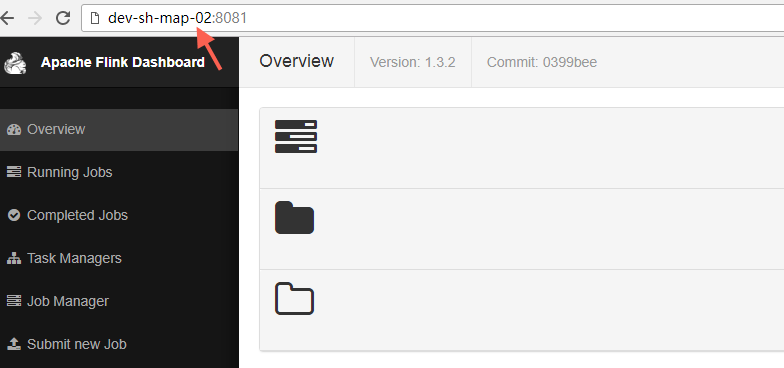
10.1 访问Leader的WebUI:

10.2 访问StandBy的WebUI
这时也会跳转到Leader的WebUI
10.3 Kill掉Leader
[root@DEV-SH-MAP- flink-1.3.]# jps

 Jps

 TaskManager

 DataNode

 SecondaryNameNode

 JobManager

 FlinkZooKeeperQuorumPeer

 NameNode

[root@DEV-SH-MAP- flink-1.3.]# kill -9 34562

[root@DEV-SH-MAP- flink-1.3.]# jps

 TaskManager

 DataNode

 SecondaryNameNode

 Jps

 FlinkZooKeeperQuorumPeer

 NameNode
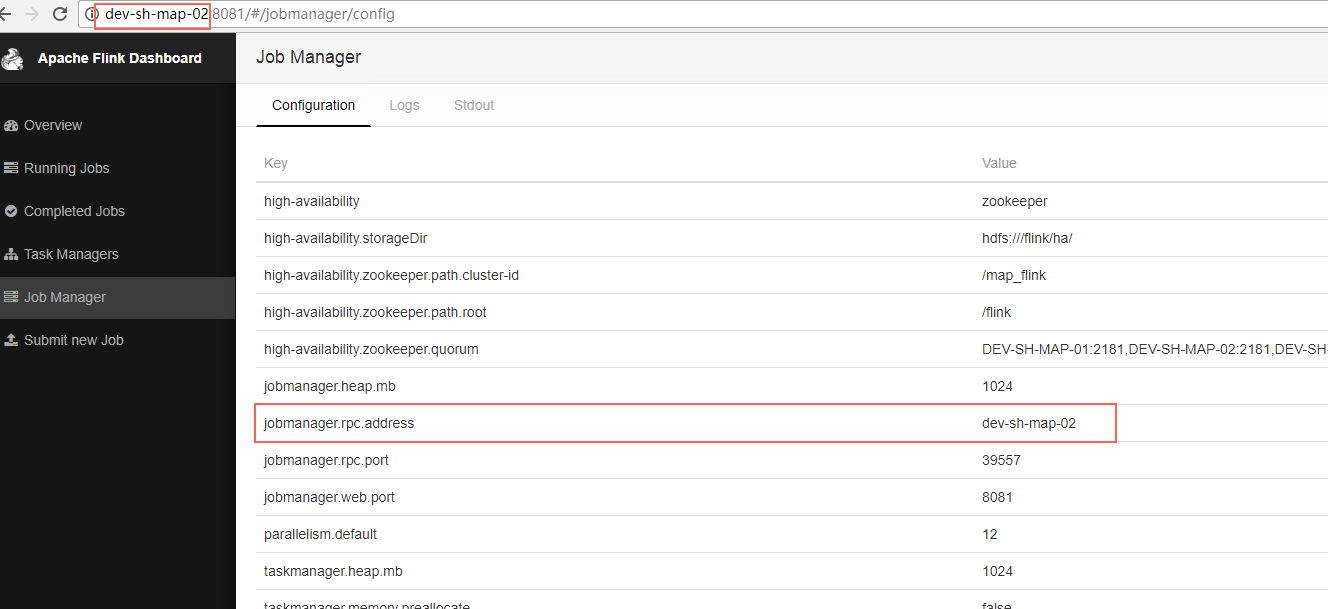
再次访问Flink WebUI,发现Leader已经发生切换
10.4 重启被Kill掉的JobManager
[root@DEV-SH-MAP- bin]# jobmanager.sh start cluster DEV-SH-MAP-01

Starting jobmanager daemon on host DEV-SH-MAP-.

[root@DEV-SH-MAP- bin]# jps

 TaskManager

 DataNode

 SecondaryNameNode

 JobManager

 Jps

 FlinkZooKeeperQuorumPeer

 NameNode
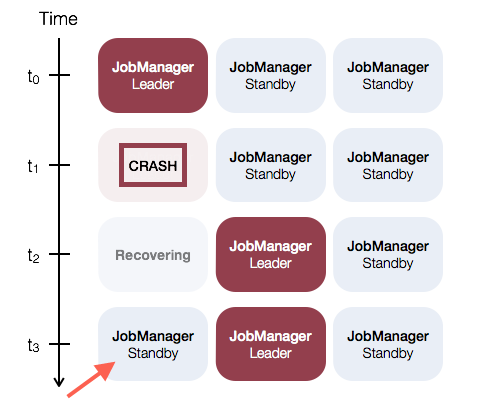
再次查看WebUI,发现虽然以前被Kill掉的Leader起来了,但是现在仍是StandBy,现有的Leader不会发生切换,也就是Flink下面的示意图:
十一、存在的问题
JobManager发生切换时,TaskManager也会跟着发生重启
Flink JobManager HA模式部署(基于Standalone)的更多相关文章
- 一脸懵逼学习Hadoop分布式集群HA模式部署(七台机器跑集群)
1)集群规划:主机名 IP 安装的软件 运行的进程master 192.168.199.130 jdk.hadoop ...
- 分布式集群HA模式部署
一:HDFS系统架构 (一)利用secondary node备份实现数据可靠性 (二)问题:NameNode的可用性不高,当NameNode节点宕机,则服务终止 二:HA架构---提高NameNode ...
- 搭建高可用的flink JobManager HA
JobManager协调每个flink应用的部署,它负责执行定时任务和资源管理. 每一个Flink集群都有一个jobManager, 如果jobManager出现问题之后,将不能提交新的任务和运行新任 ...
- Flink集群模式部署及案例执行
一.软件要求 Flink在所有类UNIX的环境[例如linux,mac os x和cygwin]上运行,并期望集群由一个 主节点和一个或多个工作节点组成.在开始设置系统之前,确保在每个节点上都安装了一 ...
- Spark部署三种方式介绍:YARN模式、Standalone模式、HA模式
参考自:Spark部署三种方式介绍:YARN模式.Standalone模式.HA模式http://www.aboutyun.com/forum.php?mod=viewthread&tid=7 ...
- 第06讲:Flink 集群安装部署和 HA 配置
Flink系列文章 第01讲:Flink 的应用场景和架构模型 第02讲:Flink 入门程序 WordCount 和 SQL 实现 第03讲:Flink 的编程模型与其他框架比较 第04讲:Flin ...
- [hadoop][会装]HBase集群安装--基于hadoop ha模式
可以参考部署HBase系统(分布式部署) 和基于无HA模式的hadoop下部署相比,主要是修改hbase-site .xml文件,修改如下参数即可: <property> <name ...
- Spark运行模式与Standalone模式部署
上节中简单的介绍了Spark的一些概念还有Spark生态圈的一些情况,这里主要是介绍Spark运行模式与Spark Standalone模式的部署: Spark运行模式 在Spark中存在着多种运行模 ...
- Spark集群基于Zookeeper的HA搭建部署笔记(转)
原文链接:Spark集群基于Zookeeper的HA搭建部署笔记 1.环境介绍 (1)操作系统RHEL6.2-64 (2)两个节点:spark1(192.168.232.147),spark2(192 ...
随机推荐
- HDOJ2000-ASCII码排序
Problem Description 输入三个字符后,按各字符的ASCII码从小到大的顺序输出这三个字符. Input 输入数据有多组,每组占一行,有三个字符组成,之间无空格. Output ...
- jsp函数的使用
在这篇博客里面谈一谈jsp函数的一些使用规则 1.在jsp里面,函数和类是等价的,因为在函数的内部可以定义函数和变量.定义在函数内的函数和变量分为实例属性.实例函数.类属性.类函数.实例和类是面向对象 ...
- 看望朋友(家达)--->>对事情的专注及时间效率学习
本意是想去堕落街吃完饭就回寝室休息了,结果偶遇尹阳,便说是一同去走走.路上边走边聊,我便提议去十教楼顶,十教是全学校最高的教学楼,这也是刘智学长给我说的.在十教楼顶的那种感觉,特别想吹口琴,可惜没有带 ...
- 带你快速进入.net core的世界
[申明]:本人.NET Core小白.Linux小白.MySql小白.nginx小白.而今天要说是让你精通Linux ... 的开机与关机.nginx安装与部署.Core的Hello World .. ...
- 日常API之QQ登录
这次的QQ登录我研究了好久惹,今天终于可以和大家分享啦! 大家都知道,QQ登录有很多方法,例如使用账号密码登录,手机版企鹅扫码登录等等(这些方法只能验证QQ是否成功登录,并没有聊天等功能) 首先就来使 ...
- iframe中的模态框遮罩父窗口原理
关键点: css的position定位为fixed或absolute css的z-index, 最顶层的值最大如遮罩层为0那么弹出框最好是大于等于1的整数,总之记住弹出层要比遮罩的z-index值大就 ...
- Hbase集群监控
Hbase集群监控 Hbase Jmx监控 监控每个regionServer的总请求数,readRequestsCount,writeRequestCount,region分裂,region合并,St ...
- Fluent Validation with Web Api 2
using FluentValidation;using FluentValidation.Attributes;using System;using System.Collections.Gener ...
- 70. Climbing Stairs【leetcode】递归,动态规划,java,算法
You are climbing a stair case. It takes n steps to reach to the top. Each time you can either climb ...
- 再起航,我的学习笔记之JavaScript设计模式06(抽象工厂模式)
我的学习笔记是根据我的学习情况来定期更新的,预计2-3天更新一章,主要是给大家分享一下,我所学到的知识,如果有什么错误请在评论中指点出来,我一定虚心接受,那么废话不多说开始我们今天的学习分享吧! 前两 ...