
Scrapy是什么
1.Scrapy是蜘蛛爬虫框架,我们用蜘蛛来获取互联网上的各种信息,然后再对这些信息进行数据分析处理。
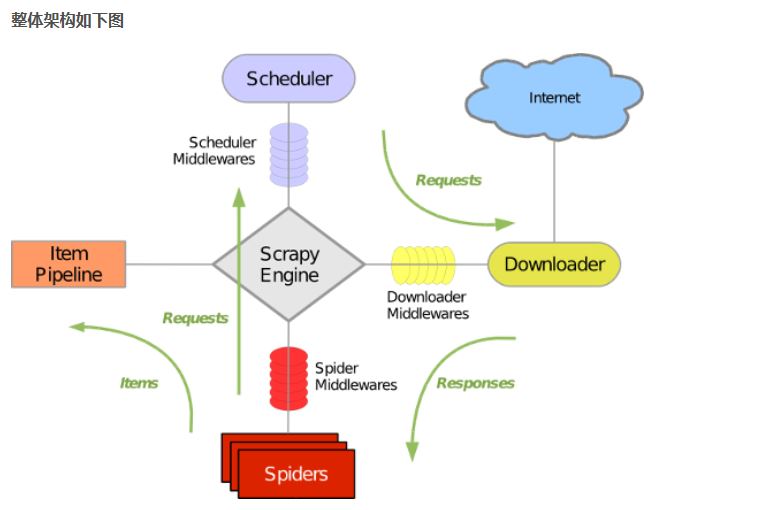
2.Scrapy的组成
- 引擎:处理整个系统的数据流处理,出发事务
- 调度器: 接受引擎发过来的请求,压入队列中,并在引擎再次请求的时候返回
- 下载器: 下载网页内容,并将网页内容返回给蜘蛛
- 蜘蛛: 蜘蛛是主要干活的,用来制定特定域名或网页的解析规则
- 项目管道: 清洗验证存储数据,页面被蜘蛛解析后,被发送到项目管道,并经过几个特定的次序处理数据。
- 下载器中间件: 位于引擎和下载器之间,处理引擎与下载器之间的请求及响应
- 蜘蛛中间件:位于引擎和蜘蛛之间,处理从引擎发送到调度的请求及响应
3.工作机制
- 爬取流程
首先从URL开始,Scheduler会将其交给Downloader进行下载,下载之后会交给Spider进行分析,Spider分析出来的结果有两种:一种是需要进一步抓取的链接,例如之前分析的“下一页”的链接,这些东西会被传回给Scheduler;另一种是需要保存的数据,他们被送到Item Pipeline那里,那是对数据进行后期处理(详细分析,过滤,存储)的地方。另外在数据流动的管道里还可以安装各种中间件,进行必要的处理。
- 数据流程
- 引擎打开一个网站,找到处理该网站的Spider,并向Spider请求第一个要爬取的URL。
- 引擎从Spider中获取到第一个要爬取的URL并在调度器中以request进行调度。
- 引擎向调度器请求下一个要爬取的URL
- 调度器返回下一个要爬取的URL给引擎,引擎将URL通过下载中间件转发给下载器
- 下载完毕后,下载器生成一个该页面的response,并将其通过中间件返回给引擎
- 引擎从下载器中接收到response并通过Spider中间件发送给Spider处理
- Spider处理response并返回爬取到的Item及新的Request给引擎。
- 引擎将爬取到的Item给Item Pipeline,将Request给调度器
- 从第二步重复,直到调度器中没有更多的request,引擎关闭该网站。
Scrapy是什么的更多相关文章
- Scrapy框架爬虫初探——中关村在线手机参数数据爬取
关于Scrapy如何安装部署的文章已经相当多了,但是网上实战的例子还不是很多,近来正好在学习该爬虫框架,就简单写了个Spider Demo来实践.作为硬件数码控,我选择了经常光顾的中关村在线的手机页面 ...
- scrapy爬虫docker部署
spider_docker 接我上篇博客,为爬虫引用创建container,包括的模块:scrapy, mongo, celery, rabbitmq,连接https://github.com/Liu ...
- scrapy 知乎用户信息爬虫
zhihu_spider 此项目的功能是爬取知乎用户信息以及人际拓扑关系,爬虫框架使用scrapy,数据存储使用mongo,下载这些数据感觉也没什么用,就当为大家学习scrapy提供一个例子吧.代码地 ...
- ubuntu 下安装scrapy
1.把Scrapy签名的GPG密钥添加到APT的钥匙环中: sudo apt-key adv --keyserver hkp://keyserver.ubuntu.com:80 --recv 6272 ...
- 网络爬虫:使用Scrapy框架编写一个抓取书籍信息的爬虫服务
上周学习了BeautifulSoup的基础知识并用它完成了一个网络爬虫( 使用Beautiful Soup编写一个爬虫 系列随笔汇总 ), BeautifulSoup是一个非常流行的Python网 ...
- Scrapy:为spider指定pipeline
当一个Scrapy项目中有多个spider去爬取多个网站时,往往需要多个pipeline,这时就需要为每个spider指定其对应的pipeline. [通过程序来运行spider],可以通过修改配置s ...
- scrapy cookies:将cookies保存到文件以及从文件加载cookies
我在使用scrapy模拟登录新浪微博时,想将登录成功后的cookies保存到本地,下次加载它实现直接登录,省去中间一系列的请求和POST等.关于如何从本次请求中获取并在下次请求中附带上cookies的 ...
- Scrapy开发指南
一.Scrapy简介 Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架. 可以应用在包括数据挖掘,信息处理或存储历史数据等一系列的程序中. Scrapy基于事件驱动网络框架 Twis ...
- 利用scrapy和MongoDB来开发一个爬虫
今天我们利用scrapy框架来抓取Stack Overflow里面最新的问题(),并且将这些问题保存到MongoDb当中,直接提供给客户进行查询. 安装 在进行今天的任务之前我们需要安装二个框架,分别 ...
- python3 安装scrapy
twisted(网络异步框架) wget https://pypi.python.org/packages/dc/c0/a0114a6d7fa211c0904b0de931e8cafb5210ad82 ...
随机推荐
- 关于hp proliant sl210t服务器raid 1阵列配置
hp proliant sl210t服务器,一般都会带有两个阵列卡 一个服务器自带的Dynamic Smart Array B120i RAID控制器,一个为Slot卡槽上的Smart Array P ...
- Centos 7.x系统安装后的初始化配置
1.配置IP.网关,编辑/etc/sysconfig/network-scripts/ifcfg-eno16777736 TYPE=Ethernet BOOTPROTO=none //默认为dhcp ...
- tomcat如何配置启动时自动部署webapps下的war包
1.找到 tomcat安装目录/conf/server.xml 2.修改host元素的配置如下: <Host name="localhost" appBase="w ...
- linux文件归档脚本
#!/bin/bash range= dir="/app/xx/logs" bak_dir="/app/xx/logs_archive" cd $dir $ra ...
- github中删除一个repository
(1) 首先进入相应的repository,然后点击setting 2,点击 delete the repository (3) 输入要删除的repository名字,即可删除
- 8.29 jQuery
2018-8-29 13:22:26 jQuery : http://www.cnblogs.com/liwenzhou/p/8178806.html 都快开学了!我得在家渡劫! 今天下午去俺弟家玩去 ...
- 【微信小程序】---授权登陆---【巷子】
Page({ onLoad: function() { var that = this; // 查看是否授权 wx.getSetting({ success: function(res) { if ( ...
- 《ACM-ICPC程序设计系列 数论及其应用》例题个人答案记录
例1.1:HDU2099(2017/9/4) 本题书上给的答案是从0到99枚举,显然可以优化到每次递增b,这样至少可以把枚举次数减少到1/10. #include<cstdio> int ...
- 11.23CSS笔记
每一步的编写过程都在代码里面书写了,暂且记录下来 <!DOCTYPE html> <html lang="en"> <head> <met ...
- Windows hackson (rundll32--ADS)
http://www.tuicool.com/articles/AnuqA3 http://www.2cto.com/Article/201507/424713.html http://drops.w ...