
spark中groupByKey与reducByKey
【译】避免使用GroupByKey
by:leotse
译文
让我们来看两个wordcount的例子,一个使用了reduceByKey,而另一个使用groupByKey:
1 |
val words = Array("one", "two", "two", "three", "three", "three")
|
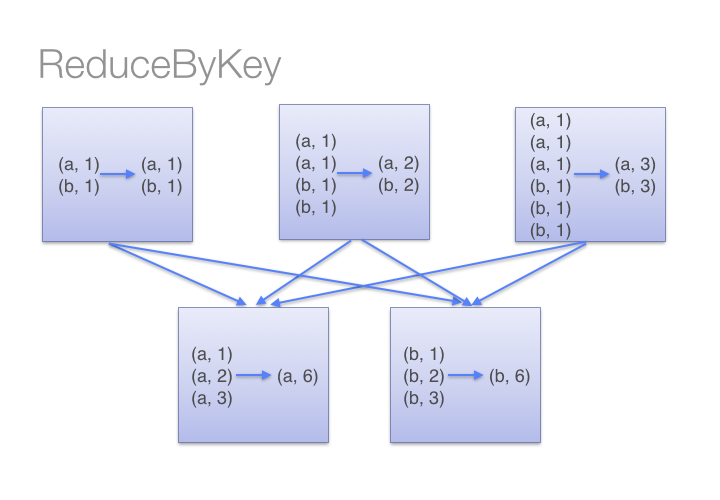
上面两个函数所得到的结果都是正确的,但是当数据集很大时,使用了reduceByKey的例子表现更佳。这是因为在shuffle输出的数据前,Spark会Combine每一个partition上具有相同key的输出结果。
看下图我们就能理解reduceByKey的工作流程。我们注意到同一台机器上数据shuffle之前,相同key的数据(通过调用传入reduceByKey的lambda函数)Combine在一起的,然后再一次调用这个lambda函数去reduce来自各个partition的全部值,从而得到最终的结果。
另一方面,当调用groupByKey的时候,所有的键值对都会进行shuffle,这将增加很多无谓的数据进行网络传输。
为了确定哪台机器将接受Shuffle后的键值对,Spark会针对该键值对数据的key调用一个分区函数。当某一台executor机器上的内存不足以保存过多的Shuffle后数据时,Spark就会溢写数据到磁盘上。然而,这种溢写磁盘会一次性将一个key的全部键值对数据写入磁盘,因此如果一个key拥有过多键值对数据——多到内存放不下时,将会抛出Out Of Memory异常。在之后发布的Spark中将会更加优雅地处理这种情况,使得这个job仍会继续运行,但是我们仍然需要避免(使用groupByKey)。当Spark需要溢写磁盘的时候,它的性能将受到严重影响。
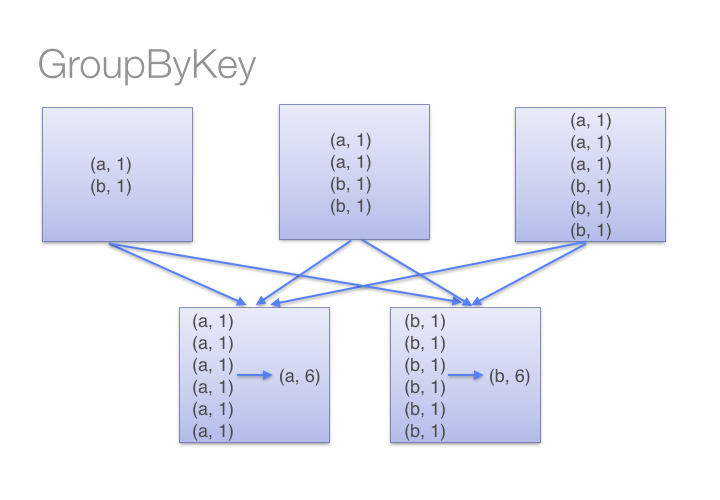
如果你有一个非常大的数据集,那么reduceByKey和groupByKey进行shuffle的数据量之间的差异将会更加夸张。
下面是一些你可以用来替代groupByKey的函数:
1)当你在combine数据但是返回的数据类型因输入值的类型而异时,你可以使用combineByKey;
2)如果key使用到结合函数和“零值”,你可以用foldByKey函数合并value;
spark中groupByKey与reducByKey的更多相关文章
- Spark 中 GroupByKey 相对于 combineByKey, reduceByKey, foldByKey 的优缺点
避免使用GroupByKey 我们看一下两种计算word counts 的方法,一个使用reduceByKey,另一个使用 groupByKey: val words = Array("on ...
- Spark中groupByKey、reduceByKey与sortByKey
groupByKey把相同的key的数据分组到一个集合序列当中: [("hello",1), ("world",1), ("hello",1 ...
- 在Spark中尽量少使用GroupByKey函数(转)
原文链接:在Spark中尽量少使用GroupByKey函数 为什么建议尽量在Spark中少用GroupByKey,让我们看一下使用两种不同的方式去计算单词的个数,第一种方式使用reduceByKey ...
- Spark中的编程模型
1. Spark中的基本概念 Application:基于Spark的用户程序,包含了一个driver program和集群中多个executor. Driver Program:运行Applicat ...
- 关于Spark中RDD的设计的一些分析
RDD, Resilient Distributed Dataset,弹性分布式数据集, 是Spark的核心概念. 对于RDD的原理性的知识,可以参阅Resilient Distributed Dat ...
- Spark中的键值对操作-scala
1.PairRDD介绍 Spark为包含键值对类型的RDD提供了一些专有的操作.这些RDD被称为PairRDD.PairRDD提供了并行操作各个键或跨节点重新进行数据分组的操作接口.例如,Pa ...
- Spark中的键值对操作
1.PairRDD介绍 Spark为包含键值对类型的RDD提供了一些专有的操作.这些RDD被称为PairRDD.PairRDD提供了并行操作各个键或跨节点重新进行数据分组的操作接口.例如,Pa ...
- 【Spark篇】--Spark中的宽窄依赖和Stage的划分
一.前述 RDD之间有一系列的依赖关系,依赖关系又分为窄依赖和宽依赖. Spark中的Stage其实就是一组并行的任务,任务是一个个的task . 二.具体细节 窄依赖 父RDD和子RDD parti ...
- 020 Spark中分组后的TopN,以及Spark的优化(重点)
一:准备 1.源数据 2.上传数据 二:TopN程序编码 1.程序 package com.ibeifeng.bigdata.spark.core import java.util.concurren ...
随机推荐
- 统计英文文章中各单词的频率,打印频率最高的十个单词(C语言实现)
一.程序思路及相关代码 首先打开文件,代码如下 FILE *fp; char fname[10]; printf("请输入要分析的文件名:\n"); scanf("%s ...
- 推荐两个好用的Xcode插件(提供下载链接)
这里推荐两款好用的Xcode插件,并提供下载链接. 一.插件和使用如下: 1.两款插件 对项目中图片提供自动提示功能的插件:KSImageNamed-Xcode-master 提供快速创建自动注释:V ...
- Smarty自定义函数
自定义函数:<{方法名称}> 在html页面是可以直接赋值的:(没啥作用只是知道即可) <{$a = "hello"}><div><{$a ...
- 解决 .NET Core 中 GetHostAddressesAsync 引起的 EnyimMemcached 死锁问题
在我们将站点从 ASP.NET + Windows 迁移至 ASP.NET Core + Linux 的过程中,目前遇到的最大障碍就是 —— 没有可用的支持 .NET Core 的 memcached ...
- MyBatis 多表联合查询,字段重复的解决方法
MyBatis 多表联合查询,两张表中字段重复时,在配置文件中,sql语句联合查询时使用字段别名,resultMap中对应的column属性使用相应的别名: <resultMap type=&q ...
- JavaScript(9)——call与apply
call与apply call和apply方法可以通过函数名称来调用函数.有两个参数 call()方法与apply()方法的作用相同,他们的区别仅在于接收参数的方式不同. [call] 调用一个对象的 ...
- 批量创建IP方法
以下教程,将告诉大家如何在Windows系统中通过命令行,批量添加IP.目标,在本机的的网卡名称为“本地连接”的网卡中,批量添加192.168.1段的ip地址,起开始IP为10,每次增加1,知道22为 ...
- Linked List 实例
文件功能:实现了动态建立一个学生信息的链表包括链表的创建.插入.删除.和打印输出学生信息包括姓名和分数 #include<iostream> #include<string> ...
- LeetCode OJ 110. Balanced Binary Tree
Given a binary tree, determine if it is height-balanced. For this problem, a height-balanced binary ...
- vs2013执行Add-Migration出现的问题
1. 无法将"Add-Migration"项识别为 cmdlet.函数.脚本文件或可运行程序的名称.请检查名称的拼写,如果包括路径,请确保路径正确,然后再试一次 网上解决方法为:h ...