
在Spark中尽量少使用GroupByKey函数(转)
原文链接:在Spark中尽量少使用GroupByKey函数
为什么建议尽量在Spark中少用GroupByKey,让我们看一下使用两种不同的方式去计算单词的个数,第一种方式使用reduceByKey ;另外一种方式使用groupByKey,代码如下:
01 |
# User: 过往记忆 |
02 |
# Date: 2015-05-18 |
03 |
# Time: 下午22:26 |
04 |
# bolg: http://www.iteblog.com |
05 |
# 本文地址:http://www.iteblog.com/archives/1357 |
06 |
# 过往记忆博客,专注于hadoop、hive、spark、shark、flume的技术博客,大量的干货 |
07 |
# 过往记忆博客微信公共帐号:iteblog_hadoop |
08 |
09 |
val words = Array("one", "two", "two", "three", "three", "three") |
10 |
val wordPairsRDD = sc.parallelize(words).map(word => (word, 1)) |
11 |
12 |
val wordCountsWithReduce = wordPairsRDD |
13 |
.reduceByKey(_ + _) |
14 |
.collect() |
15 |
16 |
val wordCountsWithGroup = wordPairsRDD |
17 |
.groupByKey() |
18 |
.map(t => (t._1, t._2.sum)) |
19 |
.collect() |
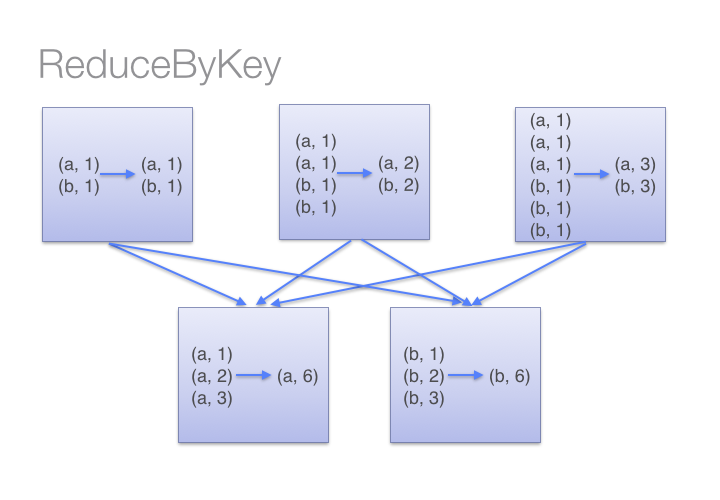
虽然两个函数都能得出正确的结果, 但reduceByKey函数更适合使用在大数据集上。 这是因为Spark知道它可以在每个分区移动数据之前将输出数据与一个共用的 key 结合。
借助下图可以理解在reduceByKey里发生了什么。 注意在数据对被搬移前同一机器上同样的 key 是怎样被组合的(reduceByKey中的 lamdba 函数)。然后 lamdba 函数在每个区上被再次调用来将所有值 reduce成一个最终结果。整个过程如下:
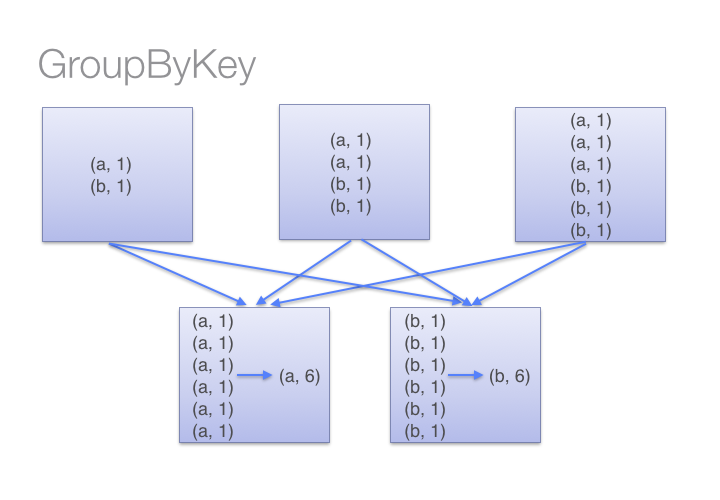
另一方面,当调用 groupByKey时,所有的键值对(key-value pair) 都会被移动。在网络上传输这些数据非常没有必要。避免使用 GroupByKey。
为了确定将数据对移到哪个主机,Spark会对数据对的 key 调用一个分区算法。 当移动的数据量大于单台执行机器内存总量时 Spark 会把数据保存到磁盘上。 不过在保存时每次会处理一个 key 的数据,所以当单个 key 的键值对超过内存容量会存在内存溢出的异常。 这将会在之后发行的 Spark 版本中更加优雅地处理,这样的工作还可以继续完善。 尽管如此,仍应避免将数据保存到磁盘上,这会严重影响性能。
如果想及时了解Spark、Hadoop或者Hbase相关的文章,欢迎关注微信公共帐号:iteblog_hadoop
你可以想象一个非常大的数据集,在使用 reduceByKey 和 groupByKey 时他们的差别会被放大更多倍。以下函数应该优先于 groupByKey :
(1)、combineByKey组合数据,但是组合之后的数据类型与输入时值的类型不一样。
(2)、foldByKey 合并每一个 key 的所有值,在级联函数和“零值”中使用。
在Spark中尽量少使用GroupByKey函数(转)的更多相关文章
- Effective Objective-C 2.0 — 第二条:类的头文件中尽量少引入其他头文件
第二条:类的头文件中尽量少引入其他头文件 使用向前声明(forward declaring) @class EOCEmployer 1, 将引入头文件的实际尽量延后,只在确有需要时才引入,这样就可以减 ...
- Spark中groupBy groupByKey reduceByKey的区别
groupBy 和SQL中groupby一样,只是后面必须结合聚合函数使用才可以. 例如: hour.filter($"version".isin(version: _*)).gr ...
- Spark 中 GroupByKey 相对于 combineByKey, reduceByKey, foldByKey 的优缺点
避免使用GroupByKey 我们看一下两种计算word counts 的方法,一个使用reduceByKey,另一个使用 groupByKey: val words = Array("on ...
- Spark学习笔记之RDD中的Transformation和Action函数
总算可以开始写第一篇技术博客了,就从学习Spark开始吧.之前阅读了很多关于Spark的文章,对Spark的工作机制及编程模型有了一定了解,下面把Spark中对RDD的常用操作函数做一下总结,以pys ...
- Scala 深入浅出实战经典 第42讲:scala 泛型类,泛型函数,泛型在spark中的广泛应用
王家林亲授<DT大数据梦工厂>大数据实战视频 Scala 深入浅出实战经典(1-64讲)完整视频.PPT.代码下载:百度云盘:http://pan.baidu.com/s/1c0noOt6 ...
- DELPHI语法基础学习笔记-Windows 句柄、回调函数、函数重载等(Delphi中很少需要直接使用句柄,因为句柄藏在窗体、 位图及其他Delphi 对象的内部)
函数重载重载的思想很简单:编译器允许你用同一名字定义多个函数或过程,只要它们所带的参数不同.实际上,编译器是通过检测参数来确定需要调用的例程.下面是从VCL 的数学单元(Math Unit)中摘录的一 ...
- Spark中的IsNotNull函数怎么用
Spark中的IsNotNull函数怎么用 在这里看到的这个函数,就是判断是否为空,但是开始不知道怎么用,后来找到了,要在View中用,也就是SparkSQL中.如下: spark.sql(" ...
- BigData进阶--Spark中的函数与符号
转自:https://blog.csdn.net/YSC1123/article/details/78905090 1.Character.isDigit() 判断是否为数字 2.Character. ...
- Spark中shuffle的触发和调度
Spark中的shuffle是在干嘛? Shuffle在Spark中即是把父RDD中的KV对按照Key重新分区,从而得到一个新的RDD.也就是说原本同属于父RDD同一个分区的数据需要进入到子RDD的不 ...
随机推荐
- VuGen录制选项Recording Options
- 【WPF】奇怪的INotifyPropertyChanged的实现
MSDN是这样解释的: INotifyPropertyChanged 接口用于向客户端(通常是执行绑定的客户端)发出某一属性值已更改的通知. 例如,考虑一个带有名为 FirstName 属性的 Per ...
- 初识 Fuzzing 工具 WinAFL
转:https://paper.seebug.org/323/ 初识 Fuzzing 工具 WinAFL 作者:xd0ol1(知道创宇404实验室) 0 引子 本文前两节将简要讨论 fuzzing 的 ...
- 【codeforces.com/gym/100240 J】
http://codeforces.com/gym/100240 J [分析] 这题我搞了好久才搞出样例的11.76....[期望没学好 然后好不容易弄成分数形式.然后我‘+’没打..[于是爆0... ...
- Week Three
2018.12.10 1.[BZOJ 4818][P 3702] 2.[AGC007 A] 3.[AGC007 B] 4.[AGC007 C] 5.[AGC007 D] 2018.12.11 1.[B ...
- [CC-STREETTA]The Street
[CC-STREETTA]The Street 题目大意: 给定两个长度为\(n(n\le10^9)\)的数列\(A\)和\(B\),开始数列\(A\)中每一项值为\(-\infty\),数列\(B\ ...
- [HAOI2015]数组游戏
题目大意: 有一排n个格子,每个格子上都有一个白子或黑子,在上面进行游戏,规则如下: 选择一个含白子的格子x,并选择一个数k,翻转x,2x,...,kx格子上的子. 不能操作者负. 思路: 将“某个格 ...
- Unity 播放音频文件
Unity 播放音频文件参考代码: public void Play(string strSoundName, float autoDestroyTime = 0f, bool bLoop = fal ...
- python 3.x和2.x不同和改动
参考于http://www.runoob.com/python/python-2x-3x.html 因为这几天换了电脑,之前电脑里装的是python2.x,因为那时候刚学的时候,很多教程都是用2.x. ...
- Linux6.9用RPM方式安装MySQL5.7.21
1.下载安装包 wget https://dev.mysql.com/get/Downloads/MySQL-5.7/mysql-5.7.21-1.el6.x86_64.rpm-bundle.tar ...