
Storm知识点
1. 离线计算是什么?
2. 流式计算是什么?
3. storm核心组件和架构?
- 核心组件
- 架构
4. 并发度
5. Storm运行模式
6. Storm常见的分组策略
7. Storm操作命令
- 任务提交命令:storm jar 【jar路径】 【拓扑包名.拓扑类名】 【拓扑名称】
storm jar /export/servers/storm/examples/storm-starter/storm-starter-topologies-1.0.3.jar org.apache.storm.starter.WordCountTopology wordcount
hadoop jar /usr/local/wordcount.jar /data.txt /wcout
- 杀死任务命令:storm kill 【拓扑名称】 -w 10(执行kill命令时可以通过-w [等待秒数]指定拓扑停用以后的等待时间)
storm kill topology-name -w 10
- 停用任务命令:storm deactive 【拓扑名称】
storm deactive topology-name
- 启用任务命令:storm activate 【拓扑名称】
storm activate topology-name
- 重新部署任务命令:storm rebalance 【拓扑名称】
storm rebalance topology-name
- Spout创建一个新的Tuple时,会发一个消息通知acker去跟踪;
- Bolt在处理Tuple成功或失败后,也会发一个消息通知acker;
- acker会找到发射该Tuple的Spout,回调其ack或fail方法。
 //BaseBasicBolt 实现可靠消息传递

 public class SplitSentence extends BaseBasicBolt {//自动建立 anchor,自动 ack

   public void execute(Tuple tuple, BasicOutputCollector collector) {

     String sentence = tuple.getString(0);

     for(String word: sentence.split(" ")) {

       collector.emit(new Values(word));

     }

   }

   public void declareOutputFields(OutputFieldsDeclarer declarer) {

     declarer.declare(new Fields("word"));

   }

 }
 //BaseRichBolt 实现可靠消息传递

 public class SplitSentence extends BaseRichBolt {//建立 anchor 树以及手动 ack 的例子

     OutputCollector _collector;

     public void prepare(Map conf, TopologyContext context, OutputCollector collector) {

         _collector = collector;

     }

     public void execute(Tuple tuple) {

         String sentence = tuple.getString(0);

         for(String word: sentence.split(" ")) {

             _collector.emit(tuple, new Values(word)); // 建立 anchor 树

         }

         _collector.ack(tuple); //手动 ack,如果想让 Spout 重发该 Tuple,则调用 _collector.fail(tuple);

     }

     public void declareOutputFields(OutputFieldsDeclarer declarer) {

         declarer.declare(new Fields("word"));

     }

 }
9. 调整可靠性
- 在build topology时,设置acker数目为0,即conf.setNumAckers(0);
- 在Spout中,不指定messageId,使得Storm无法追踪;
- 在Bolt中,使用Unanchor方式发射新的Tuple。
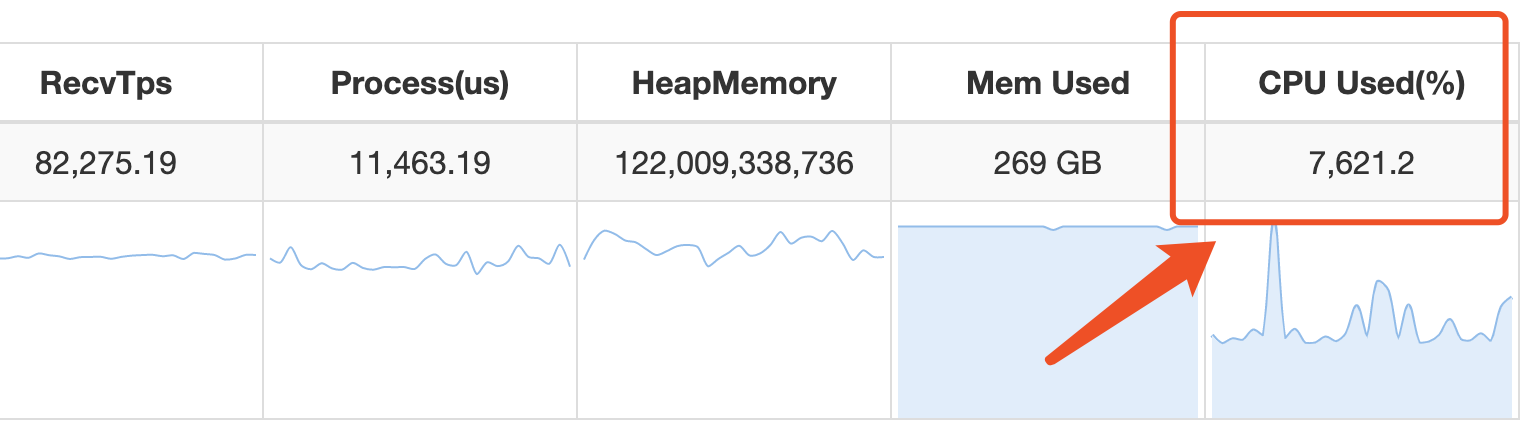
10. Jstorm查看CPU核数
11. Jstorm消费kakfa单条数据太大起Lag
Kafka spoutConfig.fetchSizeBytes = ;

Kafka spoutConfig.bufferSizeBytes = ;
Storm知识点的更多相关文章
- Storm知识点笔记
Spark和Storm Spark基于MapReduce算法实现的分布式计算,不同于MapReduce的是,作业中间结果可以保存在内存中,而不要再读写HDFS, Spark适用于数据挖掘和机器学习等需 ...
- [大数据面试题]storm核心知识点
1.storm基本架构 storm的主从分别为Nimbus.Supervisor,工作进程为Worker. 2.计算模型 Storm的计算模型分为Spout和Bolt,Spout作为管口.Bolt作为 ...
- 初版storm项目全流程自动化测试代码实现
由于项目需要,写了版针对业务的自动化测试代码,主要应用场景在于由于业务日趋复杂,一些公共代码的改动,担心会影响已有业务.还没进行重写,但知识点还是不少的与大家分享实践下.首先,介绍下整个流处理的业务流 ...
- 升级版:深入浅出Hadoop实战开发(云存储、MapReduce、HBase实战微博、Hive应用、Storm应用)
Hadoop是一个分布式系统基础架构,由Apache基金会开发.用户可以在不了解分布式底层细节的情况下,开发分布式程序.充分利用集群的威力高速运算和存储.Hadoop实现了一个分布式文件系 ...
- 亿级流量场景下,大型架构设计实现【2】---storm篇
承接之前的博:亿级流量场景下,大型缓存架构设计实现 续写本博客: ****************** start: 接下来,我们是要讲解商品详情页缓存架构,缓存预热和解决方案,缓存预热可能导致整个系 ...
- Hadoop storm大数据分析 知识体系结构
最近工作工作有用到hadoop 和storm,最近看到一个网站上例句的hadoop 和storm的知识体系.所以列出来供大家了解和学习.来自哪个网站就不写了以免以为我做广告额. 目录结构知识点还是挺全 ...
- Storm系列二: Storm拓扑设计
Storm系列二: Storm拓扑设计 在本篇中,我们就来根据一个案例,看看如何去设计一个拓扑, 如何分解问题以适应Storm架构,同时对Storm拓扑内部的并行机制会有一个基本的了解. 本章代码都在 ...
- mysql常见知识点总结
mysql常见知识点总结 参考: http://www.cnblogs.com/hongfei/archive/2012/10/20/2732516.html https://www.cnblogs. ...
- 牛客网Java刷题知识点之Java 集合框架的构成、集合框架中的迭代器Iterator、集合框架中的集合接口Collection(List和Set)、集合框架中的Map集合
不多说,直接上干货! 集合框架中包含了大量集合接口.这些接口的实现类和操作它们的算法. 集合容器因为内部的数据结构不同,有多种具体容器. 不断的向上抽取,就形成了集合框架. Map是一次添加一对元素. ...
随机推荐
- loj#6033. 「雅礼集训 2017 Day2」棋盘游戏(二分图博弈)
题意 链接 Sol 第一次做在二分图上博弈的题..感觉思路真是清奇.. 首先将图黑白染色. 对于某个点,若它一定在最大匹配上,那么Bob必胜.因为Bob可以一直沿着匹配边都,Alice只能走非匹配边. ...
- CSS超全笔记(适合新手入门)
CSS CSS初识 CSS(Cascading Style Sheets) 美化样式 CSS通常称为CSS样式表或层叠样式表(级联样式表),主要用于设置HTML页面中的文本内容(字体.大小.对齐方式等 ...
- 开发Spring过程中几个常见异常(三):java.lang.ClassCastException: com.sun.proxy.$Proxy4 cannot be cast to com.edu.aop.ArithmeticCalculatorImpl at com.edu.aop.Main.main(Main.java:11)
这个异常是在开发Spring案例时遇到的. 贴一下完整异常信息: Exception in thread "main" java.lang.ClassCastException: ...
- Android为TV端助力 内存溢出与内存泄露
内存溢出就是软件运行需要的内存,超出了java虚拟机给他分配的可用的最大内存 内存泄露就是在缓存图片文字等等的时候,没有关闭流所导致的内存泄露
- Python 反射机制之hasattr()、getattr()、setattr() 、delattr()函数
反射机制 先看看我对Java中反射机制的通俗理解:反射之中包含了一个“反”的概念,所以要想解释反射就必须先从“正”开始解释,一般而言,当用户使用一个类的时候,应该先知道这个类,而后通过这个类产生实例化 ...
- (python)数据结构---元组
一.描述 一个有序的元素组成的集合 元组是不可变的线性数据结构 二.元组的相关操作 1.元组元素的访问 索引不可超界,否则抛异常IndexError 支持正负索引 t = (2, 3) print(t ...
- 自动化测试基础篇--Selenium判断元素是够存在
摘自https://www.cnblogs.com/sanzangTst/p/8376101.html selenium+python处于学习阶段,功能实现之后开始整理之前写的代码,突然发现一个功能没 ...
- 自动化测试基础篇--Selenium简单的163邮箱登录实例
摘自https://www.cnblogs.com/sanzangTst/p/7472556.html 前面几篇内容一直讲解Selenium Python的基本使用方法.学习了什么是selenium: ...
- perl语言中的.pm文件和.pl文件区别
perl...呵呵呵 按照惯例,.pm 应该保存 Perl Module,也就是 Perl 模块.例如 Socket.pm.pl 应该保存 Perl Library,也就是 Perl 库文件.例如 p ...
- 第八章 Hyper-V 2012 R2 故障转移群集
和终端用户相比,企业用户对于业务的连续性和可靠性更为在意.相对而言,企业一般不会将追逐单一硬件的性能排在第一位. 如何衡量业务是否持续可用,一般使用"x 个 9"这种方式来定义.如 ...