
使用scrapy框架爬取全书网书籍信息。
爬取的内容:书籍名称,作者名称,书籍简介,全书网5041页,写入mysql数据库和.txt文件
1,创建scrapy项目
scrapy startproject numberone
2,创建爬虫主程序
cd numberone

scrapy genspider quanshuwang www.quanshuwang.com
3,setting中设置请求头
USER_AGENT = "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/39.0.2171.71 Safari/537.36"
4,item中设置要爬取的字段
class NumberoneItem(scrapy.Item):

    # define the fields for your item here like:

    # name = scrapy.Field()

    book_author = scrapy.Field()

    book_name = scrapy.Field()

    book_desc = scrapy.Field()
5,quanshuwang.py主程序中写获取数据的主代码
# -*- coding: utf-8 -*-

import scrapy

from numberone.items import NumberoneItem

class QiubaiSpider(scrapy.Spider):

    name = 'quanshuwang'

    # 这句话是定义爬虫爬取的范围,最好注释掉

    # allowed_domains = ['www.qiushibaike.com']

    # 开始爬取的路由

    start_urls = ['http://www.quanshuwang.com/list/0_1.html']

    def parse(self, response):

        book_list = response.xpath('//ul[@class="seeWell cf"]/li')

        for i in book_list:

            item = NumberoneItem()

            item['book_name'] = i.xpath('./span/a/text()').extract_first()

            item['book_author'] = i.xpath('./span/a[2]/text()').extract_first()

            item['book_desc'] = i.xpath('./span/em/text()').extract_first()

            yield item

        next = response.xpath('//a[@class="next"]/@href').extract_first()

        if next:

            yield scrapy.Request(next, callback=self.parse)
6,pipelines.py管道文件中文件中写持久化保存.txt和mysql。
# -*- coding: utf-8 -*-

# Define your item pipelines here

#

# Don't forget to add your pipeline to the ITEM_PIPELINES setting

# See: https://docs.scrapy.org/en/latest/topics/item-pipeline.html

import pymysql

# 写入文件的类

class NumberonePipeline(object):

    f = None

    def open_spider(self,spider):

        self.f = open('全书网.txt','a+',encoding='utf-8')

    def process_item(self, item, spider):

        print(item['book_name']+':正在写入文件...')

        book_name = item['book_name']

        book_author = item['book_author']

        book_desc = item['book_desc']

        self.f.write('书名:'+book_name+'\n'+'作者:'+book_author+'\n'+'书籍简介:'+book_desc+'\n\n')

        return item

    def close_spider(self,spider):

        self.f.close()

# 写入数据库的类

class MysqlPipeline(object):

    conn = None

    mycursor = None

    def open_spider(self,spider):

        self.conn = pymysql.connect(host='172.16.25.4',user='root',password='root',db='quanshuwang')

        self.mycursor = self.conn.cursor()

    def process_item(self, item, spider):

        print(item['book_name'] + ':正在写数据库...')

        book_name = item['book_name']

        book_author = item['book_author']

        book_desc = item['book_desc']

        self.mycursor = self.conn.cursor()

        sql = 'insert into qsw VALUES (null,"%s","%s","%s")'%(book_name,book_author,book_desc)

        bool = self.mycursor.execute(sql)

        self.conn.commit()

        return item

    def close_spider(self,spider):

        self.conn.close()

        self.mycursor.close()
7,setting.py文件中打开管道文件。
ITEM_PIPELINES = {

   'numberone.pipelines.NumberonePipeline': 300,

   'numberone.pipelines.MysqlPipeline': 400,

}
8,执行运行爬虫的命令
scrapy crawl quanshuwang --nolog
9,控制台输出
贵府嫡女:正在写数据库...

随身空间农女翻身记:正在写入文件...

随身空间农女翻身记:正在写数据库...

阴间商人:正在写入文件...

阴间商人:正在写数据库...

我的美味有属性:正在写入文件...

我的美味有属性:正在写数据库...

剑仙修炼纪要:正在写入文件...

剑仙修炼纪要:正在写数据库...

在阴间上班的日子:正在写入文件...

在阴间上班的日子:正在写数据库...

轮回之鸿蒙传说:正在写入文件...

轮回之鸿蒙传说:正在写数据库...

末日星城:正在写入文件...

末日星城:正在写数据库...

异域神州道:正在写入文件...

异域神州道:正在写数据库...
10,打开文件和数据库查看是否写入成功

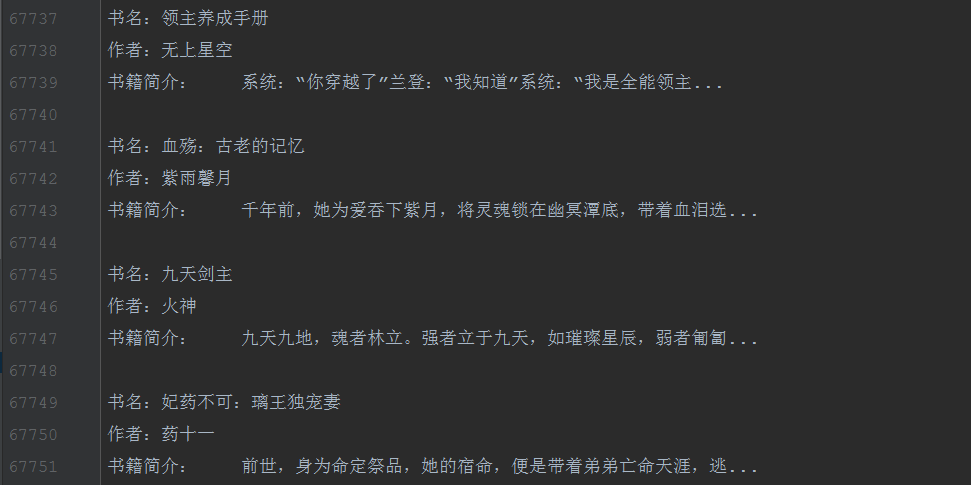
done。
使用scrapy框架爬取全书网书籍信息。的更多相关文章
- 爬虫入门(四)——Scrapy框架入门:使用Scrapy框架爬取全书网小说数据
为了入门scrapy框架,昨天写了一个爬取静态小说网站的小程序 下面我们尝试爬取全书网中网游动漫类小说的书籍信息. 一.准备阶段 明确一下爬虫页面分析的思路: 对于书籍列表页:我们需要知道打开单本书籍 ...
- 使用scrapy框架爬取自己的博文(2)
之前写了一篇用scrapy框架爬取自己博文的博客,后来发现对于中文的处理一直有问题- - 显示的时候 [u'python\u4e0b\u722c\u67d0\u4e2a\u7f51\u9875\u76 ...
- Python爬虫爬取全书网小说,程序源码+程序详细分析
Python爬虫爬取全书网小说教程 第一步:打开谷歌浏览器,搜索全书网,然后再点击你想下载的小说,进入图一页面后点击F12选择Network,如果没有内容按F5刷新一下 点击Network之后出现如下 ...
- Node.js爬虫-爬取慕课网课程信息
第一次学习Node.js爬虫,所以这时一个简单的爬虫,Node.js的好处就是可以并发的执行 这个爬虫主要就是获取慕课网的课程信息,并把获得的信息存储到一个文件中,其中要用到cheerio库,它可以让 ...
- Python爬虫项目--爬取自如网房源信息
本次爬取自如网房源信息所用到的知识点: 1. requests get请求 2. lxml解析html 3. Xpath 4. MongoDB存储 正文 1.分析目标站点 1. url: http:/ ...
- scrapy框架爬取笔趣阁完整版
继续上一篇,这一次的爬取了小说内容 pipelines.py import csv class ScrapytestPipeline(object): # 爬虫文件中提取数据的方法每yield一次it ...
- scrapy框架爬取笔趣阁
笔趣阁是很好爬的网站了,这里简单爬取了全部小说链接和每本的全部章节链接,还想爬取章节内容在biquge.py里在加一个爬取循环,在pipelines.py添加保存函数即可 1 创建一个scrapy项目 ...
- scrapy框架爬取豆瓣读书(1)
1.scrapy框架 Scrapy,Python开发的一个快速.高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据.Scrapy用途广泛,可以用于数据挖掘.监测和自动化测试 ...
- python利用scrapy框架爬取起点
先上自己做完之后回顾细节和思路的东西,之后代码一起上. 1.Mongodb 建立一个叫QiDian的库,然后建立了一个叫Novelclass(小说类别表)Novelclass(可以把一级类别二级类别都 ...
随机推荐
- 双写mq后碰到没有消费问题记录
上周双写mq后碰到遇到个问题,mq双写的一台机器有produce,另一台一直没有,但是有的那台机器没有消费者,导致另一个服务 一直没有可以消费的mq.原因是 mq在双写初始化配置的时候两个类文件重复了 ...
- Tplink路由器怎么设置无线桥接(转载)
原始文章路径:http://www.pc6.com/video/8548.html .以下为转载内容(少量修改) 第1步 进入副路由器后台,选择网络参数,LAN口设置,把IP地址改成目标网络同一段的I ...
- nginx入门系列之安装与卸载
目录 通过包管理器安装 安装nginx 卸载nginx 从源码编译安装 准备安装环境 执行编译安装 制作nginx免安装包 官方安装手册:https://nginx.org/en/docs/insta ...
- [LeetCode] 334. Increasing Triplet Subsequence 递增三元子序列
Given an unsorted array return whether an increasing subsequence of length 3 exists or not in the ar ...
- android问题总结:
1. android:focusableInTouchMode="true" 属性: 控制 子view不获取焦点: <android.support.v4.widget. ...
- 搭建基于docker 的redis分布式集群在docker for windows
https://blog.csdn.net/xielinrui123/article/details/85104446 首先在docker中下载使用 docker pull redis:3.0.7do ...
- 【常用技巧】标准模板库(STL)
[常用技巧]标准模板库(STL) 在前几个章节中我们已经使用了诸如队列.堆.堆栈.vector 等标准模板库中的模板,切身感受到了它给我们带来的极大便利.在本节中,我们还要介绍两种标准模板——stri ...
- zuul 熔断后重试
<dependency> <groupId>org.springframework.retry</groupId> <artifactId>spring ...
- PHP变量回收
PHP变量回收1 离开页面2 unset
- Win10最详细的优化设置 完美解决磁盘100%占用
1.用360优化win10后开不了机的问题原因是禁用了三个服务:在360应用软件服务里dmwappushsvc.diagnsticsTrackingservice.coreMessaging这三个要开 ...