
.NET实现堆排序
堆排序及相关知识
堆排序
堆排序是利用堆这种数据结构而设计的一种排序算法,堆排序是一种选择排序,它的最坏,最好,平均时间复杂度均为O(nlogn),它也是不稳定排序。首先简单了解下堆结构。
堆
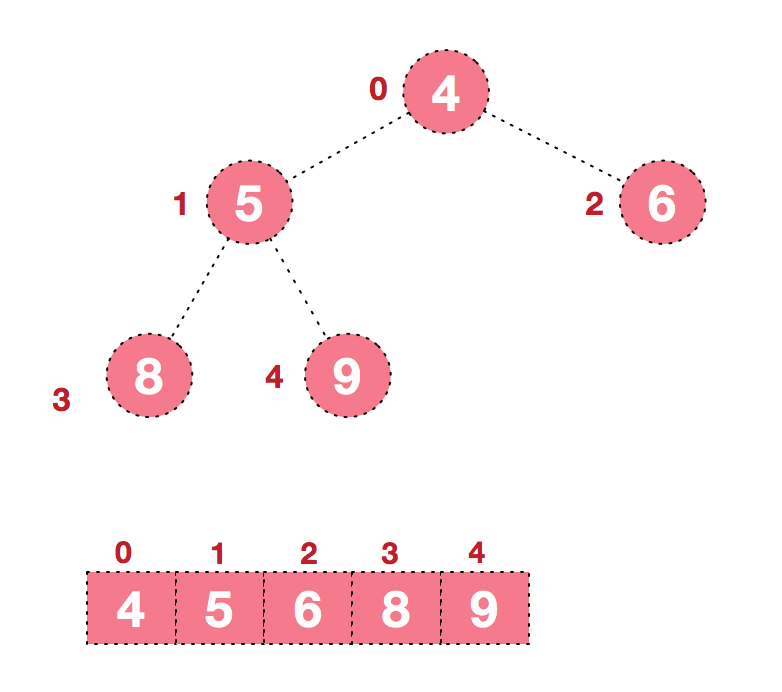
堆是具有以下性质的完全二叉树:每个结点的值都大于或等于其左右孩子结点的值,称为大顶堆;或者每个结点的值都小于或等于其左右孩子结点的值,称为小顶堆。如下图:
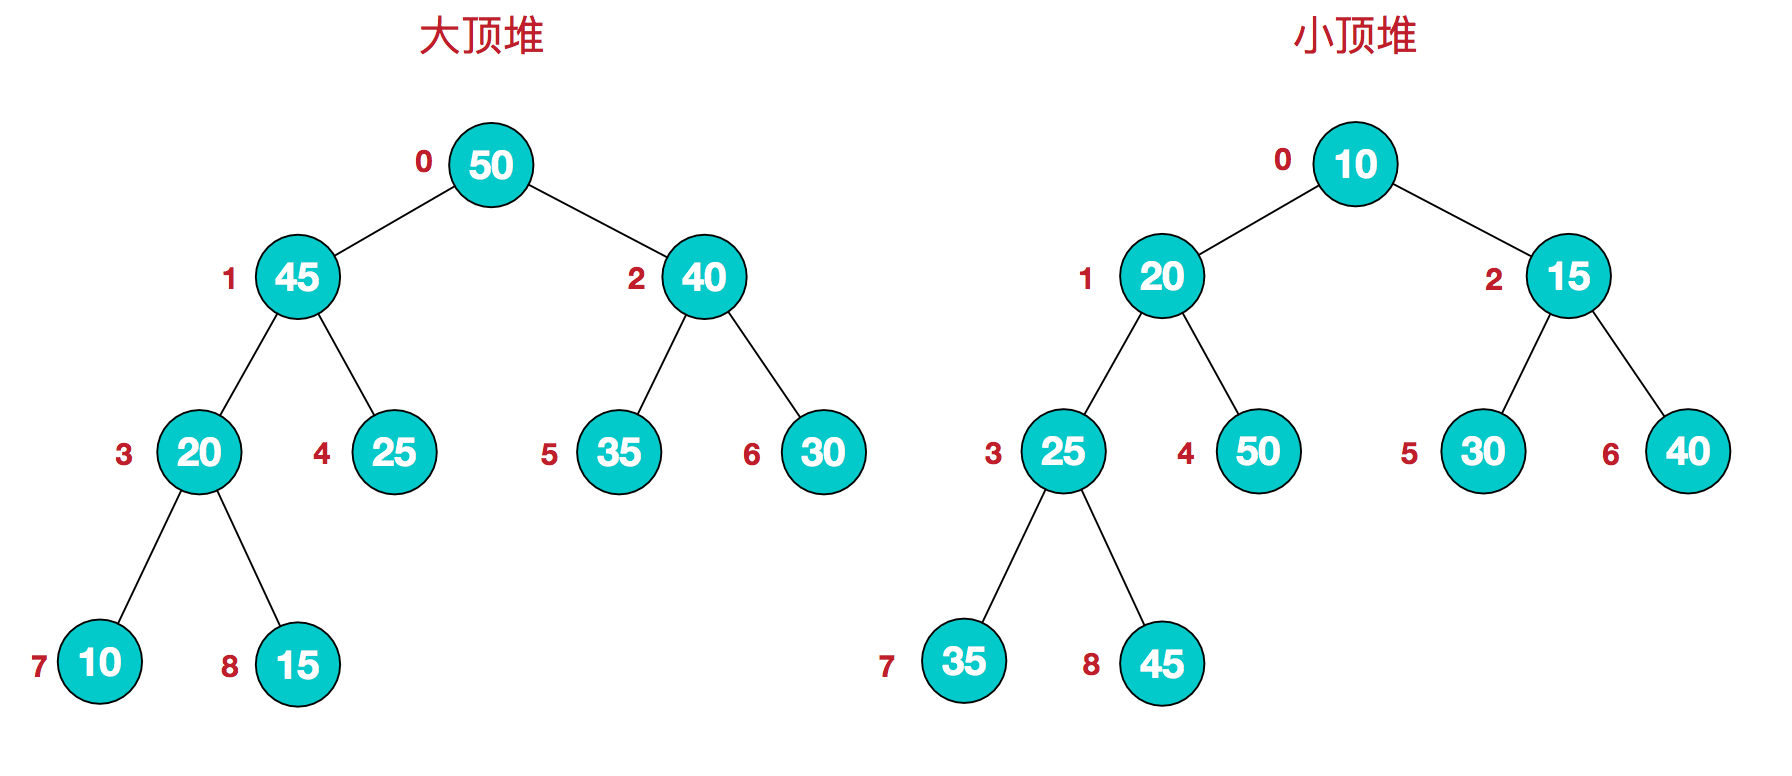
同时,我们对堆中的结点按层进行编号,将这种逻辑结构映射到数组中就是下面这个样子
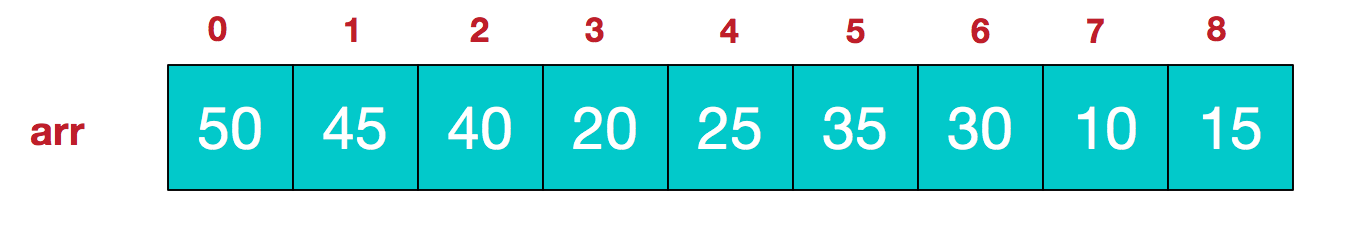
该数组从逻辑上讲就是一个堆结构,我们用简单的公式来描述一下堆的定义就是:
大顶堆:arr[i] >= arr[2i+1] && arr[i] >= arr[2i+2]
小顶堆:arr[i] <= arr[2i+1] && arr[i] <= arr[2i+2]
ok,了解了这些定义。接下来,我们来看看堆排序的基本思想及基本步骤:
堆排序基本思想及步骤
堆排序的基本思想是:将待排序序列构造成一个大顶堆,此时,整个序列的最大值就是堆顶的根节点。将其与末尾元素进行交换,此时末尾就为最大值。然后将剩余n-1个元素重新构造成一个堆,这样会得到n个元素的次小值。如此反复执行,便能得到一个有序序列了
步骤一 构造初始堆。将给定无序序列构造成一个大顶堆(一般升序采用大顶堆,降序采用小顶堆)。
题目:假设给定无序序列结构如下
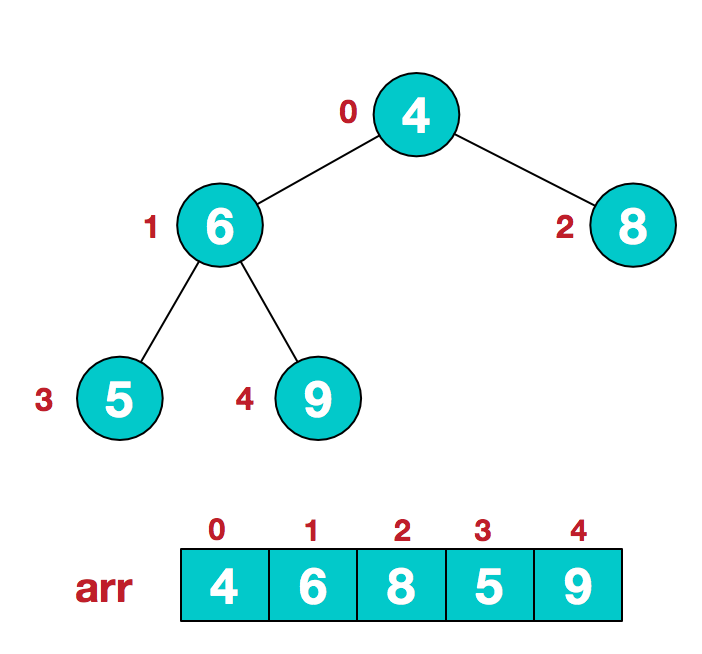
- 此时我们从最后一个非叶子结点开始(叶结点自然不用调整,第一个非叶子结点 arr.length/2-1=5/2-1=1,也就是下面的6结点),从左至右,从下至上进行调整。

- 找到第二个非叶节点4,由于[4,9,8]中9元素最大,4和9交换。
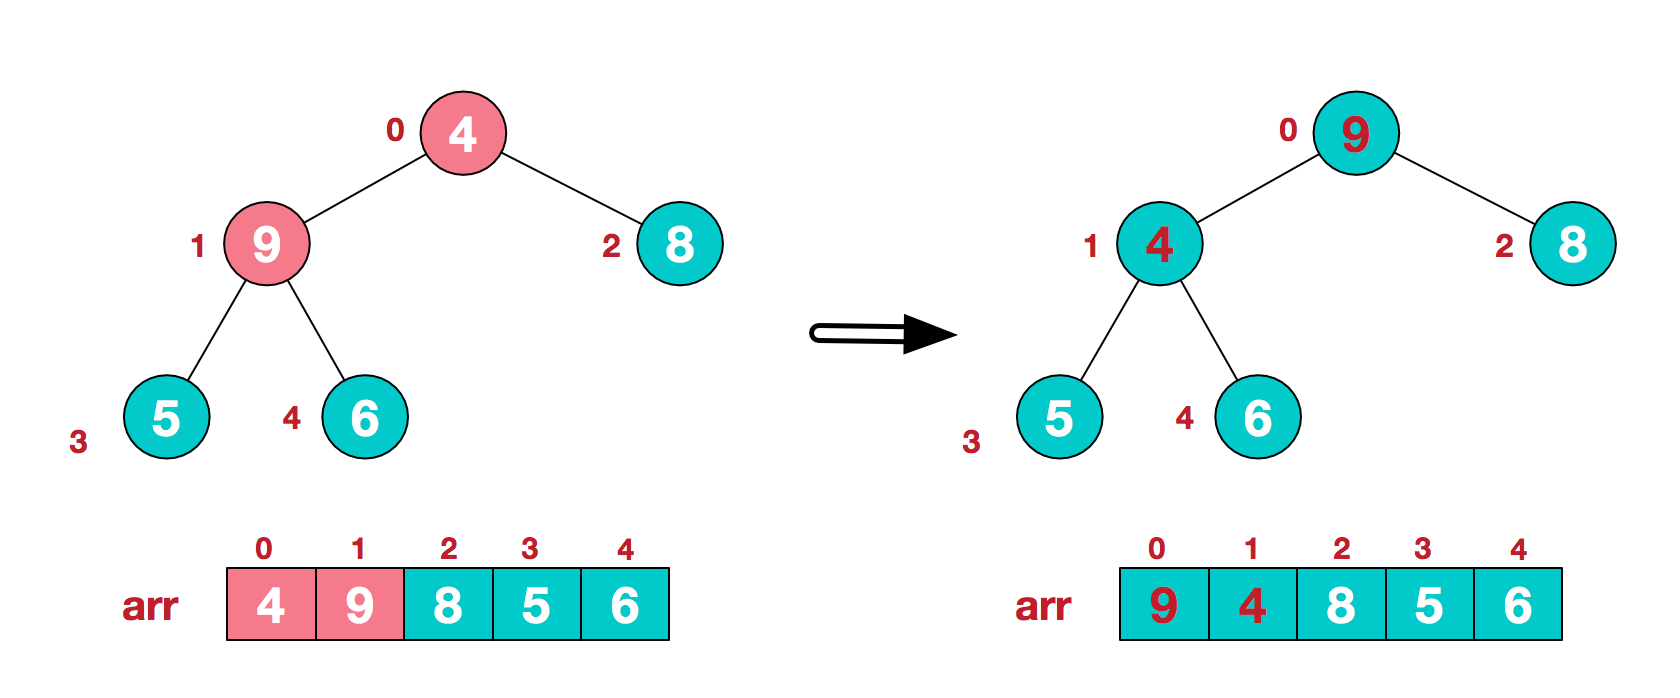
这时,交换导致了子根[4,5,6]结构混乱,继续调整,[4,5,6]中6最大,交换4和6。
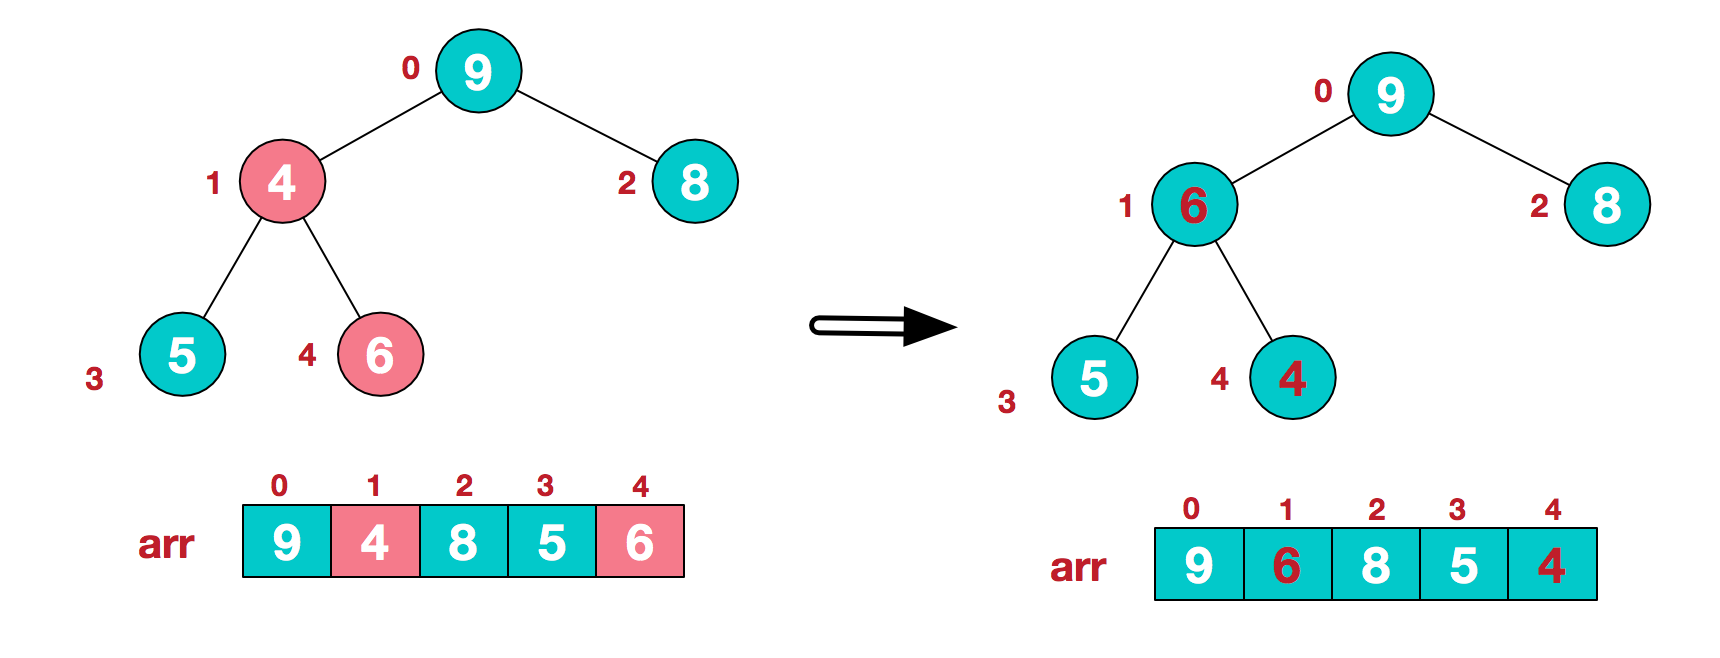
此时,我们就将一个无需序列构造成了一个大顶堆。
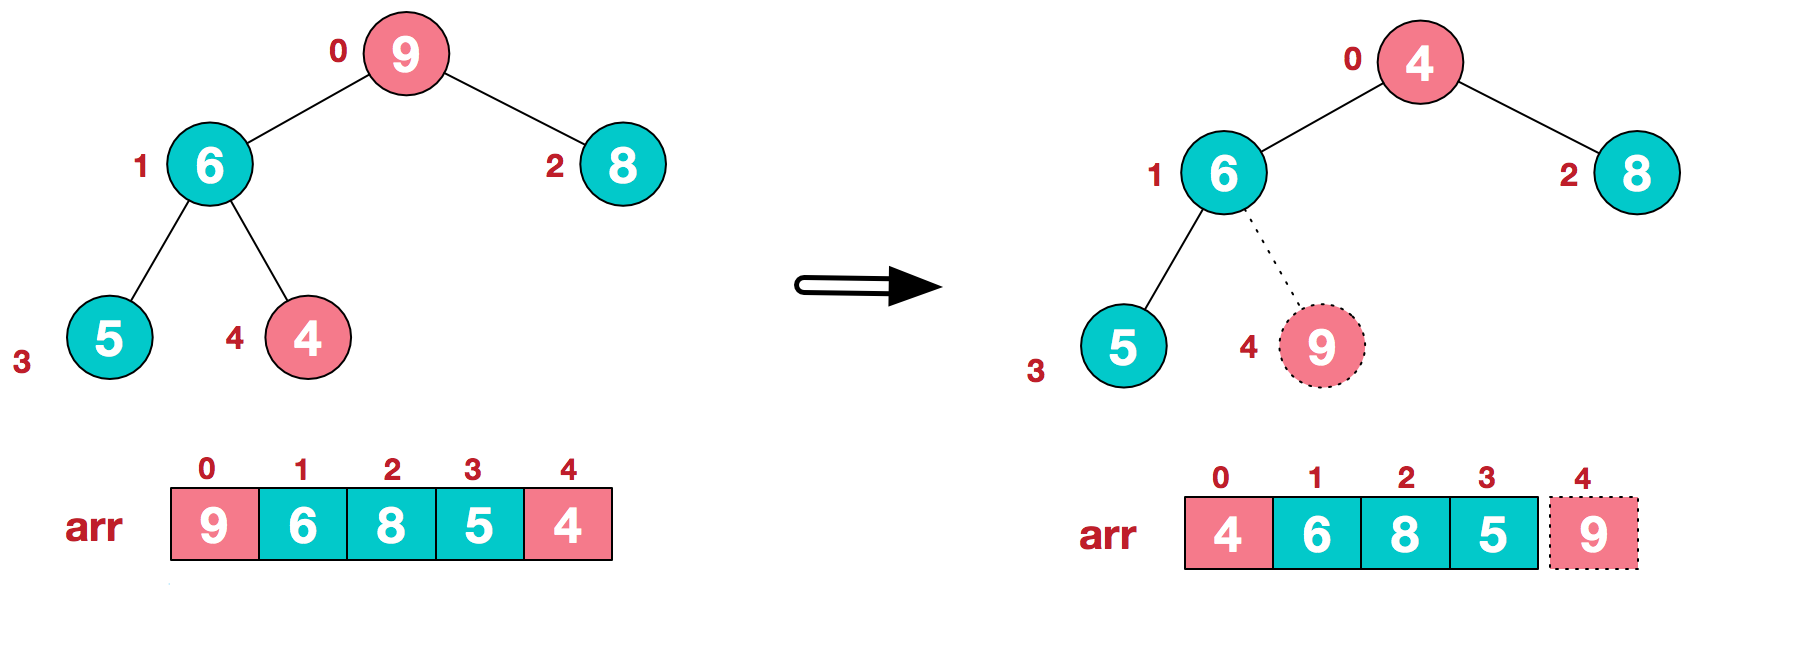
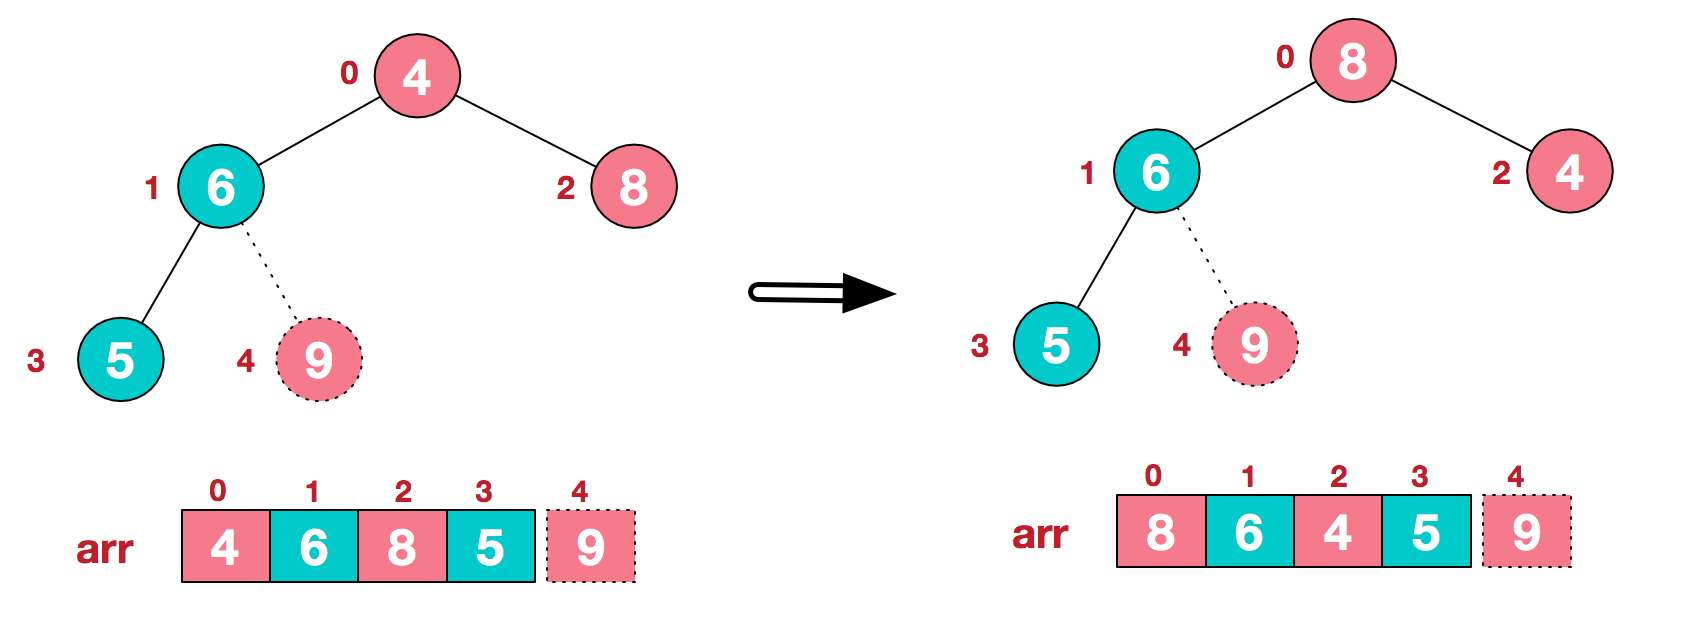
步骤二 将堆顶元素与末尾元素进行交换,使末尾元素最大。然后继续调整堆,再将堆顶元素与末尾元素交换,得到第二大元素。如此反复进行交换、重建、交换。
a. 将堆顶元素9和末尾元素4进行交换
b. 重新调整结构,使其继续满足堆定义
c. 再将堆顶元素8与末尾元素5进行交换,得到第二大元素8.
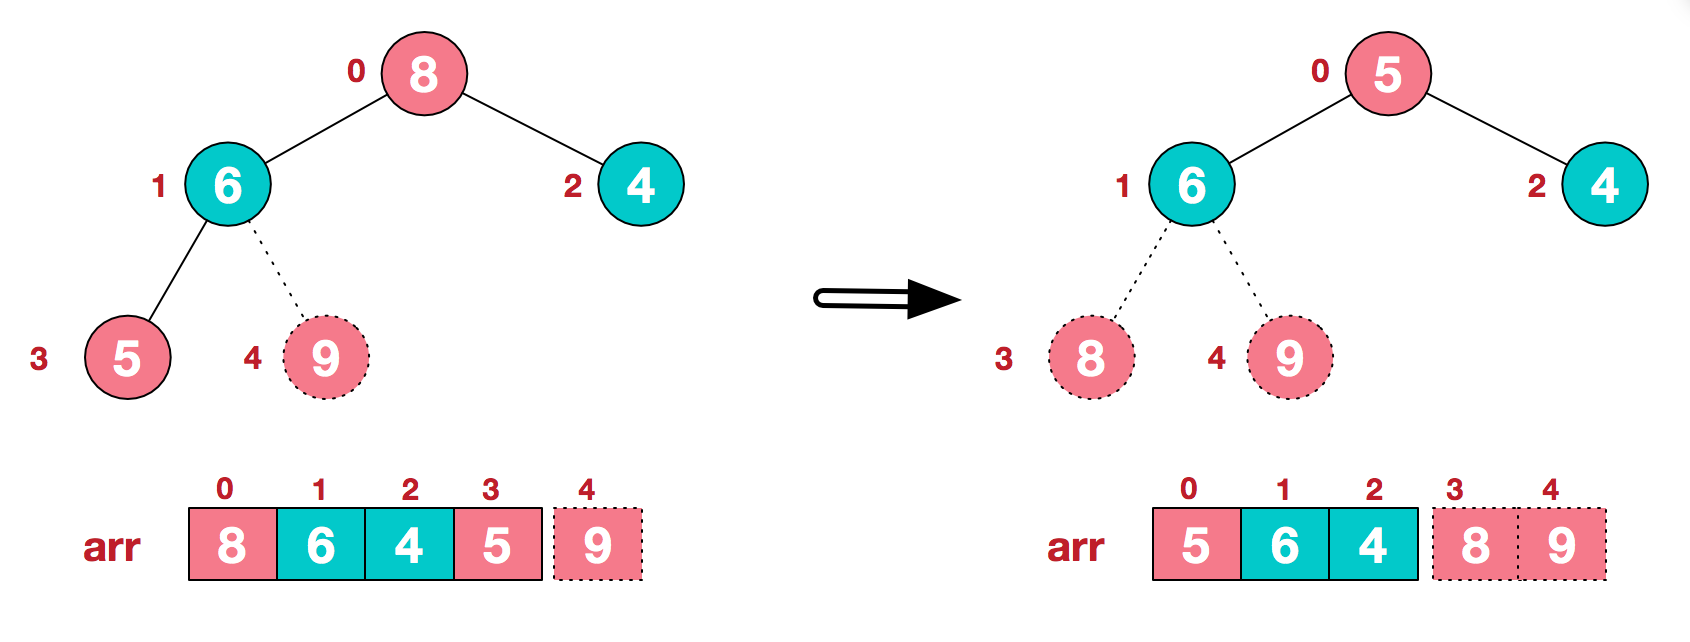
后续过程,继续进行调整,交换,如此反复进行,最终使得整个序列有序
再简单总结下堆排序的基本思路:
a. 将无需序列构建成一个堆,根据升序降序需求选择大顶堆或小顶堆;
b. 将堆顶元素与末尾元素交换,将最大元素"沉"到数组末端;
c. 重新调整结构,使其满足堆定义,然后继续交换堆顶元素与当前末尾元素,反复执行调整+交换步骤,直到整个序列有序。
.NET代码实现
//对于大顶堆:arr[i] >= arr[2i + 1] && arr[i] >= arr[2i + 2]

//对于小顶堆:arr[i] <= arr[2i + 1] && arr[i] <= arr[2i + 2]

//1、将无序序列构建成一个大顶堆。

//2.将堆顶元素和最后一个元素交换,然后将剩下的节点重新构造成一个大顶堆;

//3.重复步骤2,如此反复,从第一次构建大顶堆开始,每一次构建,我们都能获得一个序列的最大值,然后把它放到大顶堆的尾部。最后,就得到一个有序的序列了

//3, 2, 3, 1, 2, 4, 5, 5, 6

public int[] HeapSort(int[] nums)

{

  //1.构建初始堆

  //这里元素的索引是从0开始的,所以最后一个非叶子结点array.length/2 - 1

  for (int i = nums.Length / 2 - 1; i >= 0; i--)

  {

    adjustHeap(nums, i, nums.Length);

  }

  // 上述逻辑,建堆结束

  //2.下面,开始排序逻辑

  for (int j = nums.Length - 1; j > 0; j--)

  {

    // 元素交换,作用是去掉大顶堆

    // 把大顶堆的根元素,放到数组的最后;换句话说,就是每一次的堆调整之后,都会有一个元素到达自己的最终位置

    swap(nums, 0, j);

    // 元素交换之后,毫无疑问,最后一个元素无需再考虑排序问题了。

    // 接下来我们需要排序的,就是已经去掉了部分元素的堆了,这也是为什么此方法放在循环里的原因

    // 而这里,实质上是自上而下,自左向右进行调整的

    adjustHeap(nums, 0, j);

  }

  return nums;

}

public static void adjustHeap(int[] array, int i, int length)

{

  // 先把当前元素取出来,因为当前元素可能要一直移动

  int temp = array[i];

  for (int k = 2 * i + 1; k < length; k = 2 * k + 1)

  {  //2*i+1为左子树i的左子树(因为i是从0开始的),2*k+1为k的左子树

   // 让k先指向子节点中最大的节点

    if (k + 1 < length && array[k] < array[k + 1])

    {  //如果有右子树,并且右子树大于左子树

        k++;

    }

    //如果发现结点(左右子结点)大于根结点,则进行值的交换

    if (array[k] > temp)

    {

        swap(array, i, k);

        // 如果子节点更换了,那么,以子节点为根的子树会受到影响,所以,循环对子节点所在的树继续进行判断

        i = k;

    }

    else

    {  //不用交换,直接终止循环

        break;

    }

}

}

public static void swap(int[] arr, int a, int b)

{

  int temp = arr[a];

  arr[a] = arr[b];

  arr[b] = temp;

}
.NET中堆排序源码
 private void Heapsort(int lo, int hi)

 {

  int n = hi - lo + 1;

  for (int i = n / 2; i >= 1; i--)

  {

      DownHeap(i, n, lo);

  }

  for (int i = n; i > 1; i--)

  {

      Swap(lo, lo + i - 1);

      DownHeap(1, i - 1, lo);

  }

}

private void DownHeap(int i, int n, int lo)

{

  object? d = keys.GetValue(lo + i - 1);

  object? dt = items?.GetValue(lo + i - 1);

  int child;

  while (i <= n / 2)

  {

      child = 2 * i;

      if (child < n && comparer.Compare(keys.GetValue(lo + child - 1), keys.GetValue(lo + child)) < 0)

      {

          child++;

      }

      if (!(comparer.Compare(d, keys.GetValue(lo + child - 1)) < 0))

          break;

      keys.SetValue(keys.GetValue(lo + child - 1), lo + i - 1);

      items?.SetValue(items.GetValue(lo + child - 1), lo + i - 1);

      i = child;

  }

  keys.SetValue(d, lo + i - 1);

  items?.SetValue(dt, lo + i - 1);

}
感谢博主:https://www.cnblogs.com/chengxiao/p/6129630.html
.NET实现堆排序的更多相关文章
- 算法与数据结构(十四) 堆排序 (Swift 3.0版)
上篇博客主要讲了冒泡排序.插入排序.希尔排序以及选择排序.本篇博客就来讲一下堆排序(Heap Sort).看到堆排序这个名字我们就应该知道这种排序方式的特点,就是利用堆来讲我们的序列进行排序.&quo ...
- [数据结构]——堆(Heap)、堆排序和TopK
堆(heap),是一种特殊的数据结构.之所以特殊,因为堆的形象化是一个棵完全二叉树,并且满足任意节点始终不大于(或者不小于)左右子节点(有别于二叉搜索树Binary Search Tree).其中,前 ...
- 堆排序与优先队列——算法导论(7)
1. 预备知识 (1) 基本概念 如图,(二叉)堆是一个数组,它可以被看成一个近似的完全二叉树.树中的每一个结点对应数组中的一个元素.除了最底层外,该树是完全充满的,而且从左向右填充.堆的数组 ...
- 数据结构:堆排序 (python版) 小顶堆实现从大到小排序 | 大顶堆实现从小到大排序
#!/usr/bin/env python # -*- coding:utf-8 -*- ''' Author: Minion-Xu 小堆序实现从大到小排序,大堆序实现从小到大排序 重点的地方:小堆序 ...
- 堆排序(python实现)
堆排序是利用最大最或最小堆,废话不多说: 先给出几个概念: 二叉树:二叉树是每个节点最多有两个子树的树结构.通常子树被称作“左子树”(left subtree)和“右子树” 完全二叉树:除最后一层外, ...
- 堆排序分析及php实现
堆排序:是一种特殊形式的选择排序,他是简单选择排序的一种改进. 什么是堆? 具有n个元素的序列:{k1,k2,ki,…,kn} (ki <= k2i,ki <= k2i+1) 或者 (ki ...
- 浅谈C++之冒泡排序、希尔排序、快速排序、插入排序、堆排序、基数排序性能对比分析之后续补充说明(有图有真相)
如果你觉得我的有些话有点唐突,你不理解可以想看看前一篇<C++之冒泡排序.希尔排序.快速排序.插入排序.堆排序.基数排序性能对比分析>. 这几天闲着没事就写了一篇<C++之冒泡排序. ...
- [Unity][Heap sort]用Unity动态演示堆排序的过程(How Heap Sort Works)
[Unity][Heap sort]用Unity动态演示堆排序的过程 How Heap Sort Works 最近做了一个用Unity3D动态演示堆排序过程的程序. I've made this ap ...
- PHP实现堆排序
经验 工作了,面试我工作这家公司时被技术面打击得不行,因为自己的数据结构等基础学得实在太差,虽然原来是想做设计师的说...不过看在PHP写得还凑合的份上能来实习了,但还是决心恶补一下基础. 其实自己之 ...
- 堆排序 Heapsort
Prime + Heap 简直神了 时间优化好多,顺便就把Heapsort给撸了一发 具体看图 Heapsort利用完全二叉树+大(小)顶锥的结构每次将锥定元素和锥最末尾的元素交换 同时大(小)顶锥元 ...
随机推荐
- 通过ftutilx 插件实现流版式文件全文检索
Oracle 支持流版式文件的全文检索,而原生的PostgreSQL是不支持流版式文件全文检索的.KingbaseES 通过ftutilx 插件将流版式文件转换成文本文件,从而支持流版式文件全文检索. ...
- Zookeeper 分布式事务锁的使用
使用Netflix的包 curator-recipes pom文件引入相关依赖 <dependency> <groupId>org.apache.zookeeper</g ...
- JDK 自带的服务发现框架 ServiceLoader 好用吗?
请点赞关注,你的支持对我意义重大. Hi,我是小彭.本文已收录到 Github · AndroidFamily 中.这里有 Android 进阶成长知识体系,有志同道合的朋友,关注公众号 [彭旭锐] ...
- 引擎之旅 前传:C++代码规范
自己以前写代码时,一个项目一个风格.单人开发的工作使得我并没有注意到代码规范性和可读性的问题.每当项目结束后,看到自己杂乱无章的代码,完全没有二次开发和重构的欲望. 写代码就应该像写诗一样优雅. by ...
- Java开发学习(三十二)----Maven多环境配置切换与跳过测试的三种方式
一.多环境开发 我们平常都是在自己的开发环境进行开发, 当开发完成后,需要把开发的功能部署到测试环境供测试人员进行测试使用, 等测试人员测试通过后,我们会将项目部署到生成环境上线使用. 这个时候就有一 ...
- AVL tree 高度上下界推导
1. 最大高度对应 Node 数量 \(N_{h}\) 的递归公式 设有一棵 AVL tree 的高度为 \(h\), 对于该树, 构成该树的最少 node 数量为 \(N_{h}\) . 有: 最坏 ...
- 2.2 virtualenv 虚拟环境
有的时候因为各种原因,在操作系统下,我们会安装很多版本的Python解释器.同样,我们也有可能因为各种原因,需要不同版本的模块,比如Django1.8,Django1.11.再加上pip工具管理器的版 ...
- 重要参考步骤---ProxySQL Cluster 集群搭建步骤
环境 proxysql-1:192.168.20.202 proxysql-2:192.168.20.203 均采用yum方式安装 # cat <<EOF | tee /etc/yum.r ...
- Kubernetes 监控--Grafana
前面我们使用 Prometheus 采集了 Kubernetes 集群中的一些监控数据指标,我们也尝试使用 promQL 语句查询出了一些数据,并且在 Prometheus 的 Dashboard 中 ...
- 5.使用nexus3配置npm私有仓库
当我们运行前端项目的时候,常常在解决依赖的时候会加上一个参数npm install --registry=https://registry.npm.taobao.org将源指定为淘宝的源,以期让速度加 ...