
pandas 读mysql数据库(整个表或者表的指定列)
问题1:如何从数据库中读取整个表数据到DataFrame中?
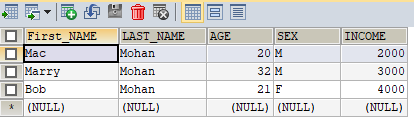
首先,来看很容易想到的的办法
     def read_table_by_name(self, table_name):

         """

         读取table_name表

         :return: dataframe对象 所有的评价对象及其数据

         """

         field_list = []    # target表的所有字段的列表

         field_data = []    # 存放某一字段的所有数据

         frame_data = pd.DataFrame()

         self._cursor = self._connect.cursor()

         sql = "select COLUMN_NAME from information_schema.COLUMNS where table_name = '%s'"

         self._cursor.execute(sql % table_name)

         results = self._cursor.fetchall()

         for row in results:

             field_list.append(row[0])

         name_sql = "select %s from %s"

         i = 0

         for field in field_list:

             self._cursor.execute(name_sql % (field, table_name))

             column_data = self._cursor.fetchall()

             field_data.clear()

             for j in range(len(column_data)):

                 field_data.append(column_data[j][0])

             frame_data.insert(i, field, field_data)  # frame_data 插入数据

             i += 1

         return frame_data
看起来,十分麻烦。那么有没有简单的办法呢?当然有,目前我已知的有以下几种:
1:使用pandas.io.sql模块中sql.read_sql_table(table_name,conn)直接将一个table转到dataframe中
 import pandas as pd

 from sqlalchemy import create_engine

 engine = create_engine('mysql+pymysql://root:123456@localhost:3306/test')

 result = pd.io.sql.read_sql_table('employee', engine)

 print(type(result), '\n', result)
注意:read_sql_table 仅支持 SQLAlchemy 连接
输出结果如下:

2:使用pandas.io.sql模块中的sql.read_sql_query(sql_str,conn)或者sql.read_sql(sql_str,conn),效果相同,都使用sql语句
 import pandas as pd

 import pymysql

 from sqlalchemy import create_engine

 # conn = pymysql.connect(host='127.0.0.1', port=3306, user='root', passwd='123456', db='test')

 engine = create_engine('mysql+pymysql://root:123456@localhost:3306/test')

 sql_str = 'select * from employee'

 result = pd.io.sql.read_sql_query(sql_str, engine)

 print(type(result), '\n', result)
 import pandas as pd

 import pymysql

 from sqlalchemy import create_engine

 conn = pymysql.connect(host='127.0.0.1', port=3306, user='root', passwd='', db='test')

 # engine = create_engine('mysql+pymysql://root:123456@localhost:3306/test')

 sql_str = 'select * from employee'

 result = pd.io.sql.read_sql_query(sql_str, conn)

 print(type(result), '\n', result)
注意:read_sql_query 不仅支持 SQLAlchemy 连接,pymysql也可以
问题2:如何从数据库中读取表的指定列的数据到DataFrame中?
先来看比较容易想到的办法:
 def read_indexs_by_index(self, table_name,  index_list):

         """

         根据选择的指标名列表读取table_name表

         :param self:

         :param table_name: 表名

         :param index_list: 指定列的列表

         :return:

         """

         index_data = []

         frame_data = pd.DataFrame()

         sql = "select %s from %s"

         i = 0

         for index in index_list:

             self._cursor.execute(sql % (index, table_name))

             column_data = self._cursor.fetchall()

             index_data.clear()

             for j in range(len(column_data)):

                 index_data.append(float(column_data[j][0]))

             frame_data.insert(i, index, index_data)  # frame_data 插入数据

             i += 1

         return frame_data
再看使用使用 pd.io.sql.read_sql_query模块的方法:
 def read_indexs_by_index(self, table_name, index_list):

         """

         根据选择的指标名列表读取table_name表

         :param self:

         :param table_name:

         :param index_list:

         :return:

         """

         sql = "select * from %s"

         df = pd.io.sql.read_sql_query((sql % table_name), self._connect)

         data_frame = df.loc[list(range(0, df.shape[0])), index_list]  # df.loc[:,index_list]也可以

         return data_frame
只需要四行
pandas 读mysql数据库(整个表或者表的指定列)的更多相关文章
- mysql数据库为什么要分表和分区?
一般下载的源码都带了MySQL数据库的,做个真正意义上的网站没数据库肯定不行. 数据库主要存放用户信息(注册用户名密码,分组,等级等),配置信息(管理权限配置,模板配置等),内容链接(html ,图片 ...
- Hibernate连接mysql数据库并自动创建表
天才第一步,雀氏纸尿裤,Hibernate第一步,连接数据库. Hibernate是一个开放源代码的对象关系映射框架,它对JDBC进行了非常轻量级的对象封装,它将POJO与数据库表建立映射关系,是一个 ...
- MYSQL数据库、用户、表等基础构建
MYSQL数据库.用户.表等基础构建: 1.->:创建数据库: 1.1. create schema [数据库名称] default character set utf8 collate utf ...
- MySQL数据库性能优化:表、索引、SQL等
一.MySQL 数据库性能优化之SQL优化 注:这篇文章是以 MySQL 为背景,很多内容同时适用于其他关系型数据库,需要有一些索引知识为基础 优化目标 减少 IO 次数IO永远是数据库最容易瓶颈的地 ...
- 关于php读mysql数据库时出现乱码的解决方法
关于php读mysql数据库时出现乱码的解决方法 php读mysql时,有以下几个地方涉及到了字符集. 1.建立数据库表时指定数据库表的字符集.例如 create table tablename ( ...
- 使用jdbc将mysql数据库中的内容封装为指定对象的list集合
使用jdbc将mysql数据库中的内容封装为指定对象的list集合 public List<User> findAll() { private JdbcTemplate template ...
- mysql数据库分区和分表
转载自 https://www.cnblogs.com/miketwais/articles/mysql_partition.html https://blog.csdn.net/vbirdbest/ ...
- 检查mysql数据库是否存在坏表脚本
#!/bin/bash #此脚本的主要用途是检测mysql服务器上所有的db或者单独db中的坏表 #变量说明 pass mysql账户口令 name mysql账号名称 data_path mysql ...
- MySql数据库中,判断表、表字段是否存在,不存在就新增
本文是针对MySql数据库创建的SQL脚本,别搞错咯. 判断表是否存在,不存在就可新增 CREATE TABLE IF NOT EXISTS `mem_cardtype_resource` ( ... ...
随机推荐
- 集合框架 ArrayList LinkedList(待续)
ArrayList中存储的元素的内存空间是连续的, LinkedList内存空间不是连续的 集合对象不能被序列化到硬盘中 http://blog.csdn.net/eson_15/article/de ...
- Linux压缩文件笔记
https://my.oschina.net/dongqianlin/blog/97168http://linux.it.net.cn/CentOS/fast/2017/0628/27029.html ...
- oracle 日常
oracle sql server select 1 from dual 和 select 1 nvl(null,0) 为空显示 0 greatest (1, 3, 2 ) ...
- 【UOJ#22】【UR#1】外星人
2044年,Picks建成了人类第一台基于量子理论的银河系信息传递机. Picks游遍了宇宙,雇用了 n 个外星人来帮他作为信息传递机的中转站.我们将外星人依次编号为 1 到 n,其中 i 号外星人有 ...
- java-IO流(File对象-深度遍历指定目录下的文件夹和文件)
需求:遍历这个树状结构 File(String pathname) '\\'为了转义'\' // 通过抽象路径pathname 创建一个新的文件或者目录 File parent = new File( ...
- Centos7安装teamviewer 32/64位
centos7安装teamviewer teamviewer安装包,自己去官网下吧,不用找了,估摸着就没有Centos7 64位的 所以直接下centos teamviewer 32位那个rpm包吧 ...
- linux 条件
1.文件状态测试-d 目录 -r 可读-f 常规文件 -w 可写-L 符号连接 -x 可执行-s 文件长度大于0,非空 -u 文件有suid位设置 示例: [ -s haison.c ] 0表示成功, ...
- mino 路径格式的bucket 数据访问
实施上这个功能很简答,如果官方不支持,我们可以通过基于nginx 的url rewrite 也可以实现 格式说明 如果配置了domain minio 会将 http://mydomain.com/bu ...
- KMPlayer速度步进设置及快捷键设置和同级视频自动加入播放列表
速度步进设置 快捷键设置 同级视频自动加入播放列表
- MySQL联结查询和组合查询
联结查询 1.关系表 主键:一列或一组列,能够唯一区分表中的每一行,用来表示一个特定的行 外键:为某个表中的一列,包含另一个表的主键,定义量表的关系. 2.创建联结 规定要连接的表和他们如何关联即可 ...