
softmax 杂谈
在多分类问题中,我们可以使用 softmax 函数,对输出的值归一化为概率值。下面举个例子:
import sys

sys.path.append("E:/zlab/")

from plotnet import plot_net, DynamicShow

num_node_list = [10, 7, 5]

figsize = (15, 6)

plot_net(num_node_list, figsize, 'net')
Press `c` to save figure to "net.svg", `Ctrl+d` to break >>

> c:\programdata\anaconda3\lib\site-packages\viznet\context.py(45)__exit__()

-> plt.savefig(self.filename, dpi=300)

(Pdb) c
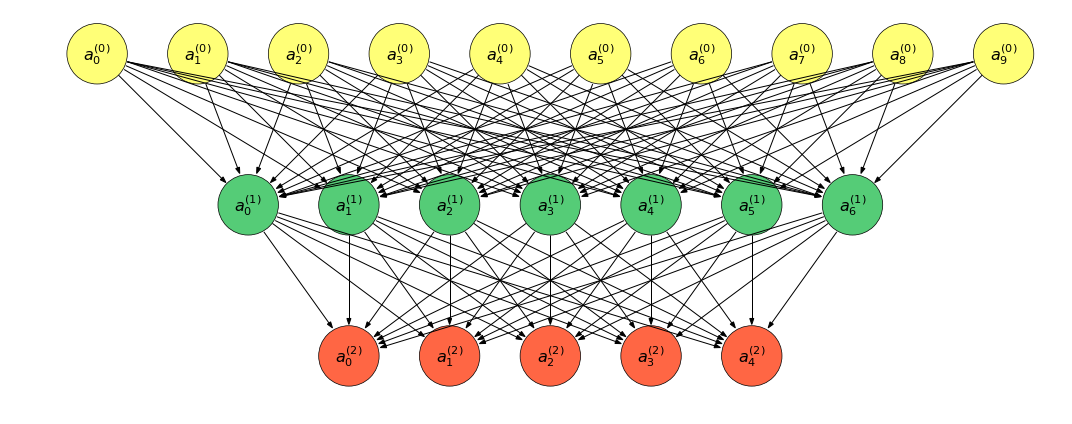
上图转换为表达式:
&a^{(0)} = (a_0^{(0)}, a_1^{(0)}, \cdots, a_9^{(0)})^T\\
&a^{(1)} = (a_0^{(1)}, a_1^{(1)}, \cdots, a_6^{(1)})^T\\
&a^{(2)} = (a_0^{(2)}, a_1^{(2)}, \cdots, a_4^{(2)})^T\\
\end{aligned}
\]
对于任意的 \(0 \leq i \leq 2\), 有前向传播的表达式:
&z^{(i+1)} = W^{(i)}a^{(i)} + b^{(i)}\\
&a^{(i+1)} = f^{(i+1)}(z^{(i+1)})
\end{aligned}
\]
其中,\(f^{(j)}\) 表示激活函数,除了输出层外,一般使用 ReLU 函数;\(W^{(i)}, b^{(i)}\) 为模型参数。
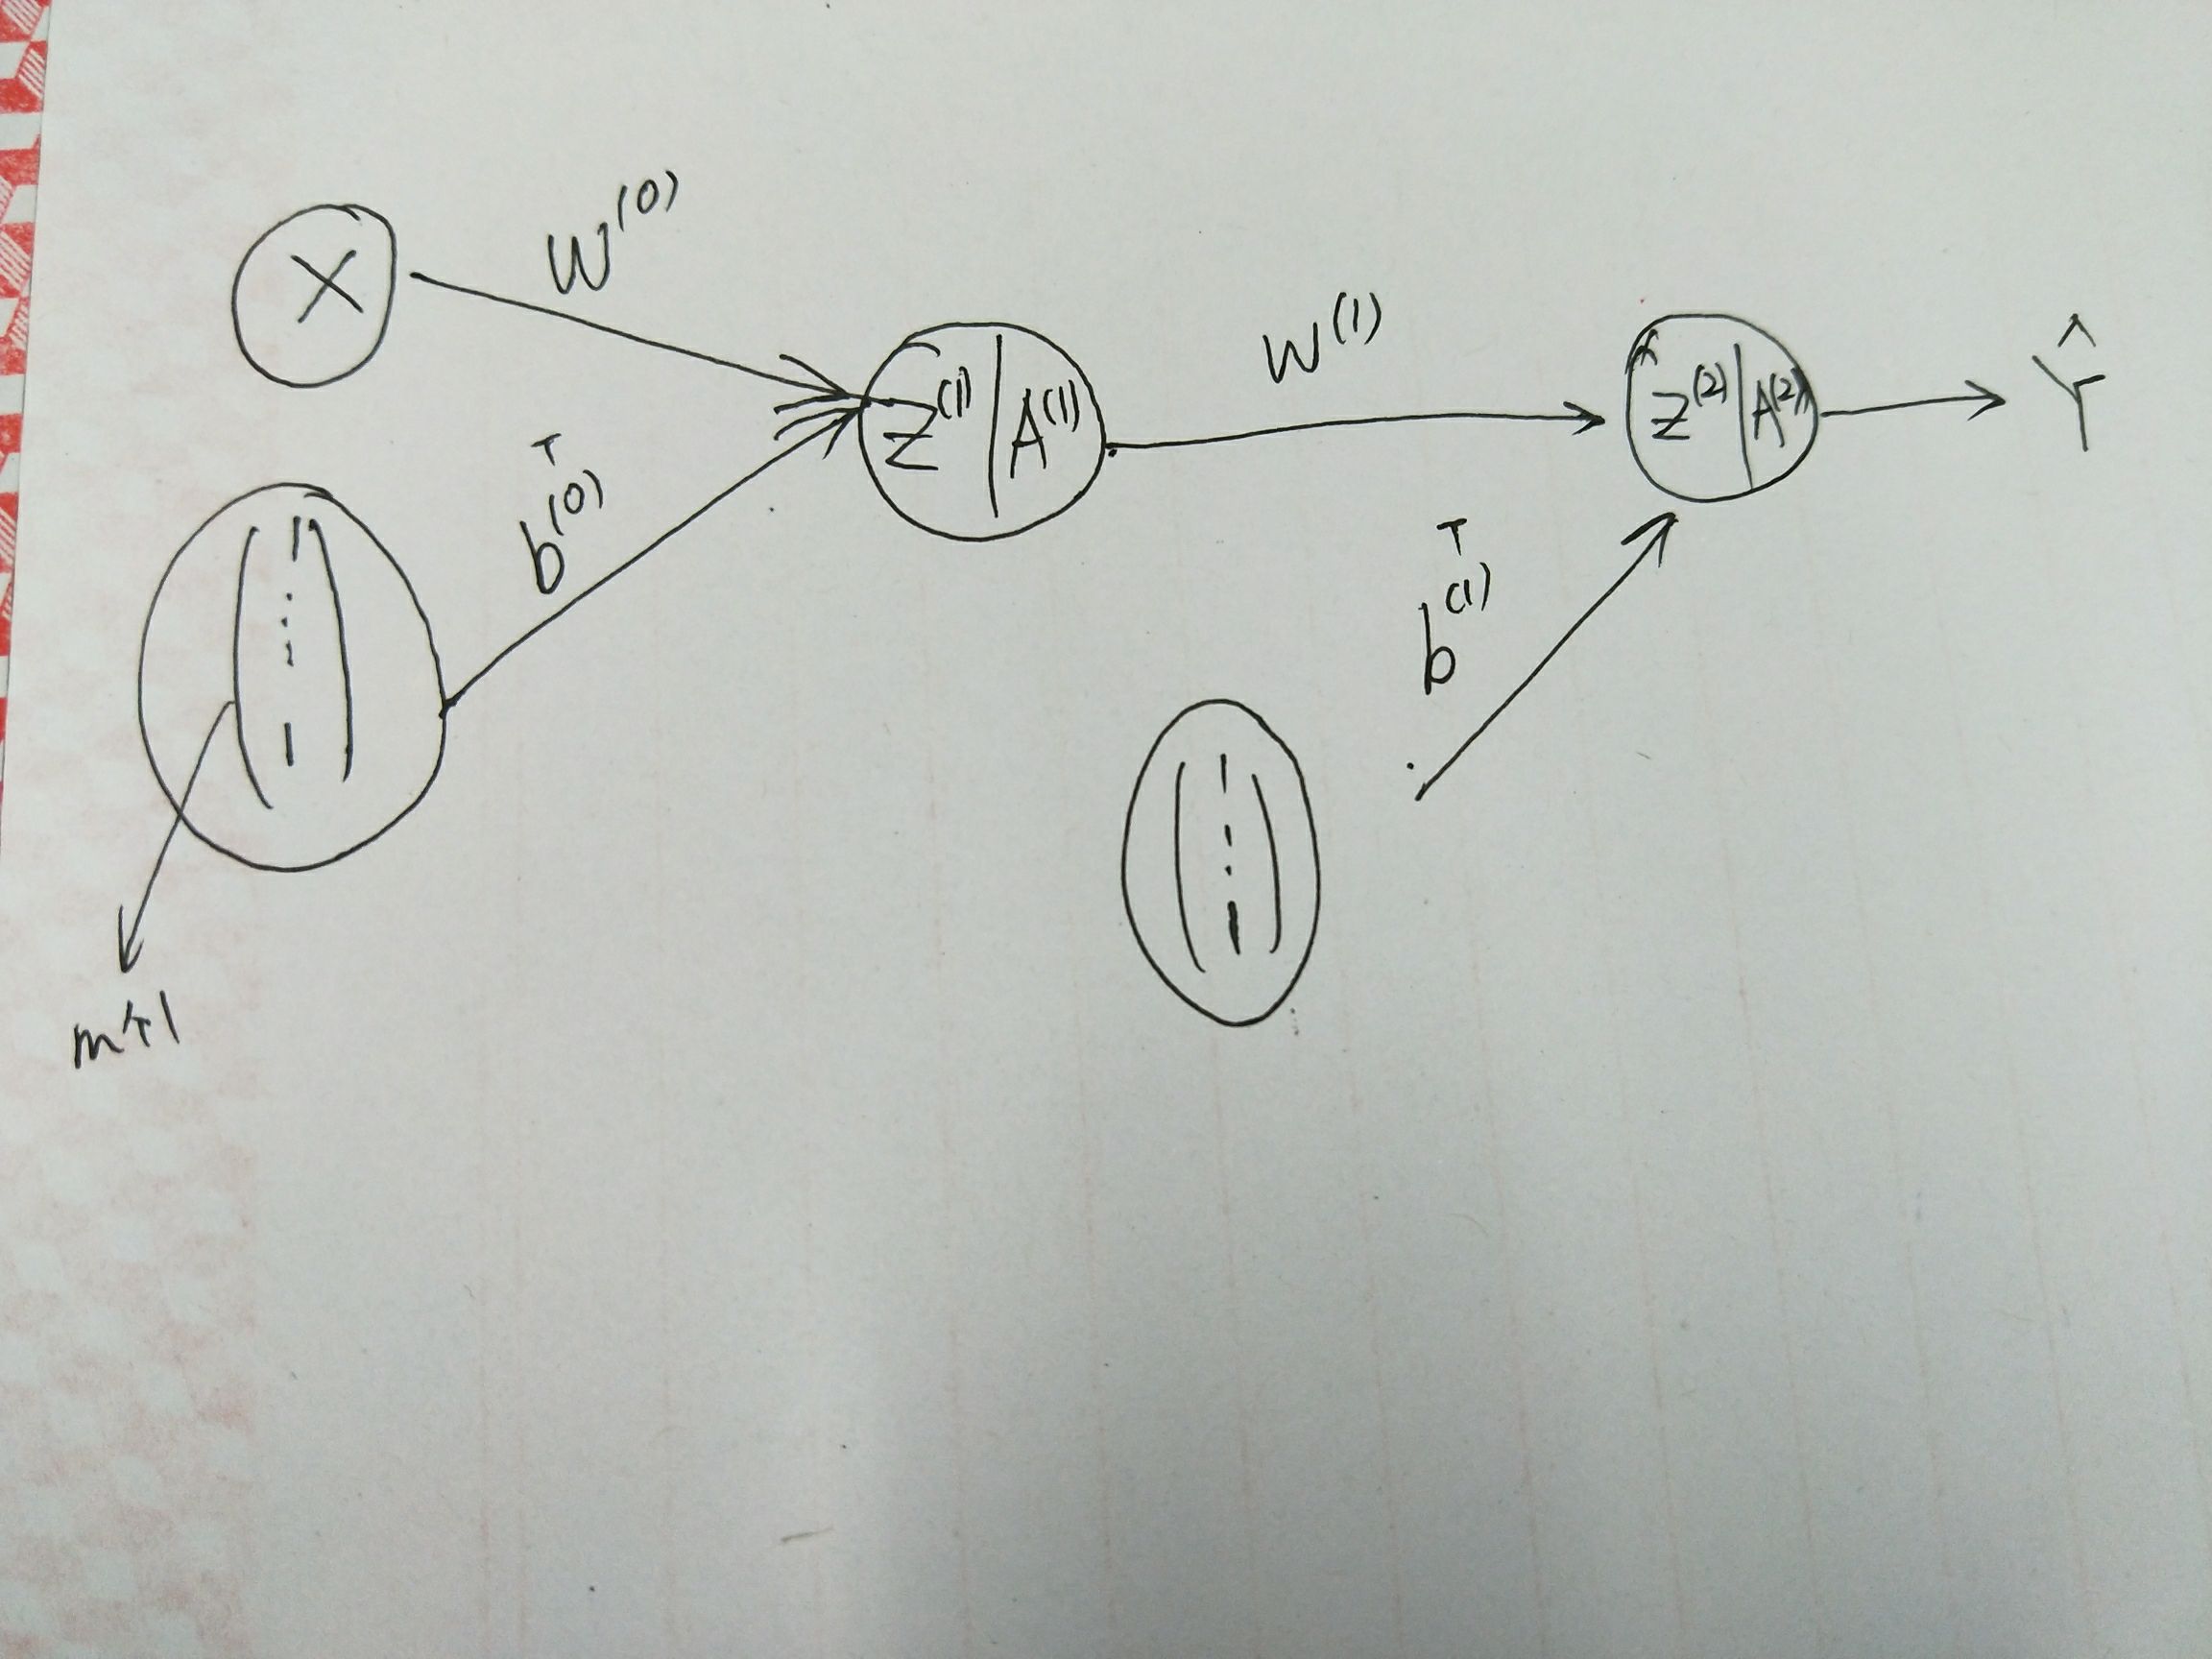
如若我们有 \(m\) 个样本 \(\{x^{(j)}\}_{j=1}^m\) 组成的数据集 \(D\), 称 \(X = (x^{(1)}, x^{(2)}, \cdots, x^{(m)})^T\) 为数据集 \(D\) 的设计矩阵。
这样,前向传播可以改写为:
Z^{(1+i)} = Z^{(i)}W^{(0)} + (b^{(i)})^T\\
A^{(1+i)} = f^{(1+i)}(Z^{(1+i)})
\end{cases}
\]
- \(Z^{(i)} = (z_1^{(i)}, z_2^{(i)}, \cdots, z_m^{(i)})^T\), 这里对 \(z^{(i)}\) 添加下标以区别不同的样本;
- 这里对列向量 \(b^{(i)}\) 进行了 broadcast 操作;
- 且 \(Z^{(0)} = X\).
对于多分类问题,一般输出层对应的激活函数的 softmax 函数:
求解 \(A^{(2)}\):
- 计算 \(exp = \exp(Z^{(1)})\);
- 对 \(exp\) 按列做归一化, 便可得到 \(\text{softmax}(A^{(1)})\).
import numpy as np

def softmax(X):

    X_exp = np.exp(X)

    partition = X_exp.sum(axis=1, keepdims=True)

    return X_exp / partition  # 这里应用了广播机制。
softmax([[2, 3,4], [3, 5, 7]])
array([[0.09003057, 0.24472847, 0.66524096],

       [0.01587624, 0.11731043, 0.86681333]])
但如果输入值较大或较小时,会出现内存溢出的现象:
softmax([1000, 1000, 100])
C:\ProgramData\Anaconda3\lib\site-packages\ipykernel\__main__.py:5: RuntimeWarning: overflow encountered in exp

C:\ProgramData\Anaconda3\lib\site-packages\ipykernel\__main__.py:7: RuntimeWarning: invalid value encountered in true_divide

array([nan, nan,  0.])
softmax([-10000, -1020, 100, -70220])
array([0., 0., 1., 0.])
一种简单有效避免该问题的方法就是让 \(\exp(z_j)\) 中的 \(z_j\) 替换为 \(z_j - \max_{i} \{z_i\}\), 由于 \(\max_{i}\) 是个固定的常数,所以 \(\exp(z_j)\) 的值没有改变。但是,此时避免了溢出现象的出现。
def softmax(X):

    X = np.asanyarray(X)

    X -= X.max(axis=-1, keepdims=True)

    X_exp = np.exp(X)

    print(X_exp)

    partition = X_exp.sum(axis=-1, keepdims=True)

    return X_exp / partition  # 这里应用了广播机制。
softmax([1000, 1000, 100])
[1. 1. 0.]

array([0.5, 0.5, 0. ])
softmax([-10000, -1020, 100, -7220])
[0. 0. 1. 0.]

array([0., 0., 1., 0.])
softmax([-10000, -1020, 100, -70220])
[0. 0. 1. 0.]

array([0., 0., 1., 0.])
当然这种做法也不是最完美的,因为 softmax 函数不可能产生 0 值,但这总比出现 nan 的结果好,并且真实的结果也是非常接近 \(0\) 的。
除此之外,还有一个问题:如果我们计算 \(\log \text{softmax} (z_j)\) 时,先计算 \(\text{softmax}\) 再将其传递给 \(\log\),会错误的得到 \(-\infty\)
np.log(softmax([-10000, -1020, 100, -70220]))
[0. 0. 1. 0.]

C:\ProgramData\Anaconda3\lib\site-packages\ipykernel\__main__.py:1: RuntimeWarning: divide by zero encountered in log

  if __name__ == '__main__':

array([-inf, -inf,   0., -inf])
最简单的处理方式是直接加一个很小的常数:
np.log(softmax([-10000, -1020, 100, -70220])+ 1e-7)
[0. 0. 1. 0.]

array([-1.61180957e+01, -1.61180957e+01,  9.99999951e-08, -1.61180957e+01])
为了解决此数值计算的不稳定,MXNet 提供了:
from mxnet.gluon import loss as gloss

loss = gloss.SoftmaxCrossEntropyLoss()
解决计算交叉熵时出现的数值不稳定的问题。
更多数据挖掘内容见:datamining
softmax 杂谈的更多相关文章
- 基于Caffe的Large Margin Softmax Loss的实现(中)
小喵的唠叨话:前一篇博客,我们做完了L-Softmax的准备工作.而这一章,我们开始进行前馈的研究. 小喵博客: http://miaoerduo.com 博客原文: http://www.miao ...
- 基于Caffe的Large Margin Softmax Loss的实现(上)
小喵的唠叨话:在写完上一次的博客之后,已经过去了2个月的时间,小喵在此期间,做了大量的实验工作,最终在使用的DeepID2的方法之后,取得了很不错的结果.这次呢,主要讲述一个比较新的论文中的方法,L- ...
- [Machine Learning] logistic函数和softmax函数
简单总结一下机器学习最常见的两个函数,一个是logistic函数,另一个是softmax函数,若有不足之处,希望大家可以帮忙指正.本文首先分别介绍logistic函数和softmax函数的定义和应用, ...
- 前馈网络求导概论(一)·Softmax篇
Softmax是啥? Hopfield网络的能量观点 1982年的Hopfiled网络首次将统计物理学的能量观点引入到神经网络中, 将神经网络的全局最小值求解,近似认为是求解热力学系统的能量最低点(最 ...
- 【转】PHP 杂谈《重构-改善既有代码的设计》之一 重新组织你的函数
原文地址: PHP 杂谈<重构-改善既有代码的设计>之一 重新组织你的函数 思维导图 点击下图,可以看大图. 介绍 我把我比较喜欢的和比较关注的地方写下来和大家分享.上次我写 ...
- Derivative of the softmax loss function
Back-propagation in a nerual network with a Softmax classifier, which uses the Softmax function: \[\ ...
- Softmax回归
Reference: http://ufldl.stanford.edu/wiki/index.php/Softmax_regression http://deeplearning.net/tutor ...
- softmax分类器+cross entropy损失函数的求导
softmax是logisitic regression在多酚类问题上的推广,\(W=[w_1,w_2,...,w_c]\)为各个类的权重因子,\(b\)为各类的门槛值.不要想象成超平面,否则很难理解 ...
- 【管理心得之三十二】PMP杂谈---------爱情必胜术
这次一反常态,没有场景设计,我想借此文普及一下PMP是什么? 但我不知道这样枯燥的话题能否能引起你的兴趣,我不得不套用“标题党”<爱情必胜术>来博你眼球. 我真没有说谎,此文是献给那些孤身 ...
随机推荐
- RabbitMQ问题解决:TCP connection succeeded but Erlang distribution failed
说明 本来是要先把Hystrix 仪表盘更完的,但是出现了Turbine.Dashboard.RabbitMQ整合实现监控. 所以先在学RabbitMq的基本操作,在安装过程中出现了 E:\Rabbi ...
- POJ 3783 Balls --扔鸡蛋问题 经典DP
题目链接 这个问题是谷歌面试题的加强版,面试题问的是100层楼2个鸡蛋最坏扔多少次:传送门. 下面我们来研究下这个题,B个鸡蛋M层楼扔多少次. 题意:给定B (B <= 50) 个一样的球,从 ...
- caffe的特殊层
每次写博客都带有一定的目的,在我看来这是一个记录的过程,所以尽量按照循序渐进的顺序逐步写,前面介绍的CNN层应该是非常常用的,这篇博客介绍一下某些特殊的layer,但是由于特殊的layer都带有一定的 ...
- 问题 1476: [蓝桥杯][基础练习VIP]龟兔赛跑预测 (模拟)
题目链接 题目描述 话说这个世界上有各种各样的兔子和乌龟,但是 研究发现,所有的兔子和乌龟都有一个共同的特点--喜欢赛跑.于是世界上各个角落都不断在发生着乌龟和兔子的比赛,小华对此很感兴趣,于是决定研 ...
- Python练习-一个简单的生成器
今天我们学习了生成器,怎么理解生成器呢,其实就是使用函数的方式自己建立一个迭代器 # 编辑者:闫龙 #做一个简单的生成器 def EasyGene(*args): #建立一个生成器方法并传递多个参数 ...
- 系统学习(javascript)_基础(语法)
1.分类 ECMAScript javascript的标准 DOM Document object Model文档对象模型 BOM Browser object Model 浏览器对象模型 ti ...
- BOOST 之filesystem, path
目录[-] 使用 boost::filesystem 的第一个程序 清单 1. 用于确定某个文件的类型是否为 Directory 的代码 了解 Boost path 对象 清单 2. 创建 Boost ...
- APScheduler API -- apscheduler.schedulers.base
apscheduler.schedulers.base API class apscheduler.schedulers.base.BaseScheduler(gconfig={}, **option ...
- TcxScheduler的使用2
DevExpress 行事历(Scheduler)的常用属性.事件和方法 参考资料来源:附带的ExpressScheduler 2 Demo, 如想了解更多可以查看Demo. 一.TcxSchedu ...
- Scrapy项目之User timeout caused connection failure(异常记录)
Windows 10家庭中文版,Python 3.6.4,Scrapy 1.5.0, 提示:此文存在问题,真正测试, 请勿阅读, 07-14 14:26更新: 经过两个多小时的测试,发现此问题的原因是 ...