
菜鸟学IT之python网页爬取多页爬取
作业来源:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE1/homework/3002
0.从新闻url获取点击次数,并整理成函数
- newsUrl
- newsId(re.search())
- clickUrl(str.format())
- requests.get(clickUrl)
- re.search()/.split()
- str.lstrip(),str.rstrip()
- int
- 整理成函数
- 获取新闻发布时间及类型转换也整理成函数
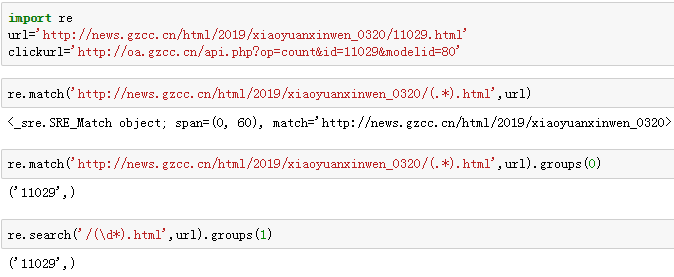
import re

url='http://news.gzcc.cn/html/2019/xiaoyuanxinwen_0320/11029.html'

clickurl='http://oa.gzcc.cn/api.php?op=count&id=11029&modelid=80'

re.match('http://news.gzcc.cn/html/2019/xiaoyuanxinwen_0320/(.*).html',url)

re.match('http://news.gzcc.cn/html/2019/xiaoyuanxinwen_0320/(.*).html',url).groups(0)

re.search('/(\d*).html',url).groups(1)

re.findall('(\d+)',url)
结果如下:
1.从新闻url获取新闻详情: 字典,anews
import requests

from bs4 import BeautifulSoup

from datetime import datetime

import re

def click(url):

    id=re.findall('(\d{1,5})',url)[-1]

    clickUrl = 'http://oa.gzcc.cn/api.php?op=count&id=11029&modelid=80'.format(id)

    resClick = requests.get(clickUrl)

    newsClick = int(resClick.text.split('.html')[-1].lstrip("('").rstrip("');"))

    return newsClick

def newsdt(showinfo):

    newsDate = showinfo.split()[0].split(':')[1]

    newsTime = showinfo.split()[1]

    newsDT = newsDate+' '+newsTime

    dt = datetime.strptime(newsDT, '%Y-%m-%d %H:%M:%S')

    return dt

def anews(url):

    newsDetail = {}

    res = requests.get(url)

    res.encoding ='utf-8'

    soup = BeautifulSoup(res.text,'html.parser')

    newsDetail['nenewsTitle'] =soup.select('.show-title')[0].text

    showinfo = soup.select('.show-info')[0].text

    newsDetail['newsDT']=newsdt(showinfo)

    newsDetail['newsClick'] =click(newsUrl)

    return newsDetail

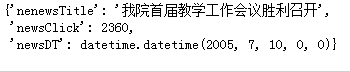
newsUrl='http://news.gzcc.cn/html/2005/xiaoyuanxinwen_0710/4.html'

anews(newsUrl)
结果:
2.从列表页的url获取新闻url:列表append(字典) alist
- 获取列表数据
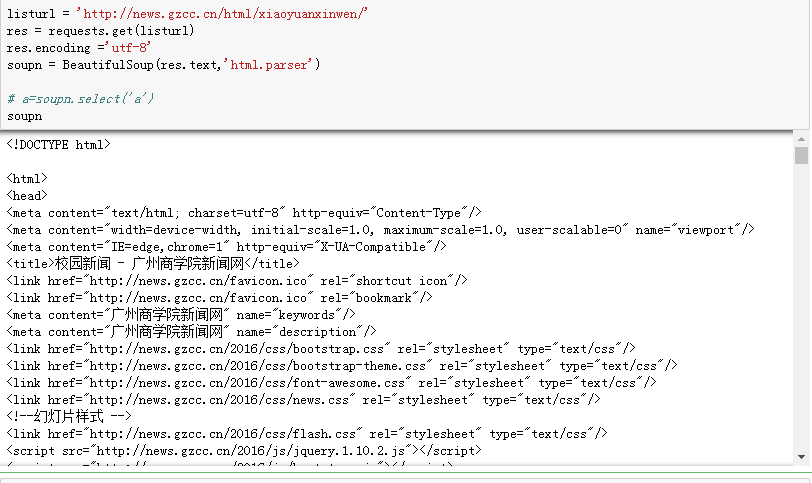
listurl = 'http://news.gzcc.cn/html/xiaoyuanxinwen/'

res = requests.get(listurl)

res.encoding ='utf-8'

soupn = BeautifulSoup(res.text,'html.parser')

# a=soupn.select('a')

soupn
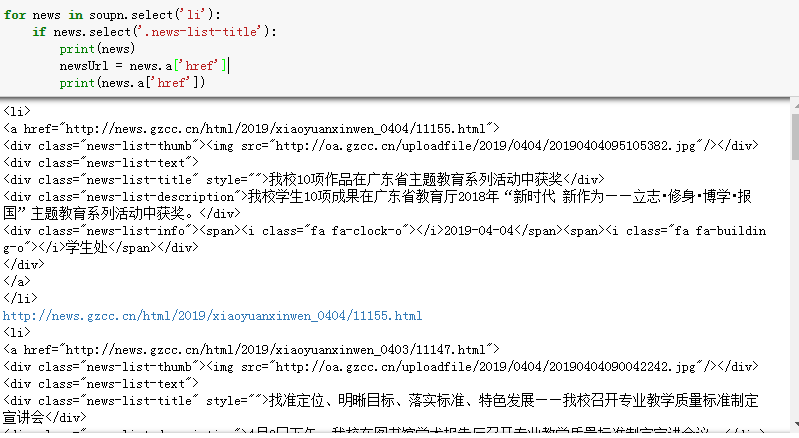
2.过滤过滤数据,只获取列表的新闻信息
for news in soupn.select('li'):

    if news.select('.news-list-title'):

        print(news)

        newsUrl = news.a['href']

        print(news.a['href'])
3.获取整页信息
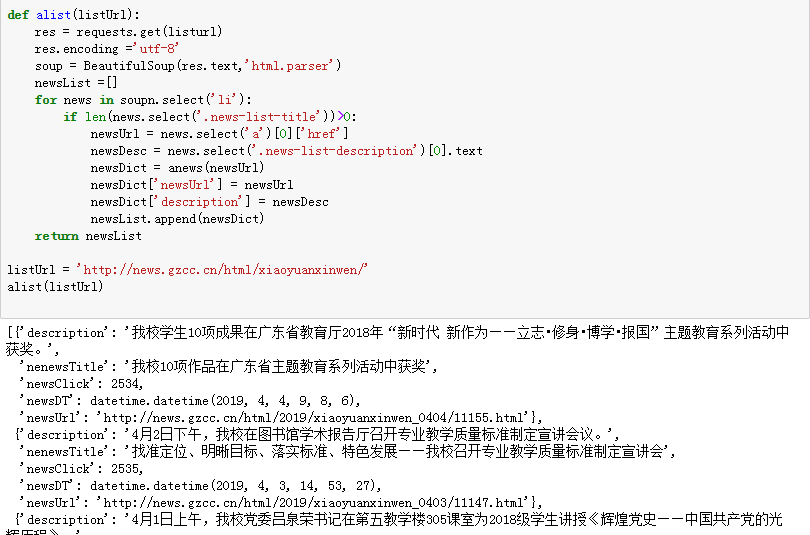
def alist(listUrl):

    res = requests.get(listurl)

    res.encoding ='utf-8'

    soup = BeautifulSoup(res.text,'html.parser')

    newsList =[]

    for news in soupn.select('li'):

        if len(news.select('.news-list-title'))>0:

            newsUrl = news.select('a')[0]['href']

            newsDesc = news.select('.news-list-description')[0].text

            newsDict = anews(newsUrl)

            newsDict['newsUrl'] = newsUrl

            newsDict['description'] = newsDesc

            newsList.append(newsDict)

    return newsList

listUrl = 'http://news.gzcc.cn/html/xiaoyuanxinwen/'

alist(listUrl)
3.生成所页列表页的url并获取全部新闻 :列表extend(列表) allnews
*每个同学爬学号尾数开始的10个列表页
- 获取多页信息
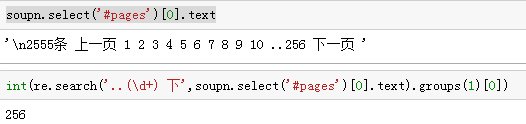
- 截取以学号尾数开始的10个列表页
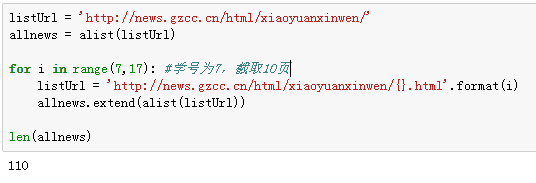
listUrl = 'http://news.gzcc.cn/html/xiaoyuanxinwen/'

allnews = alist(listUrl)

for i in range(7,17): #学号为7,截取10页

    listUrl = 'http://news.gzcc.cn/html/xiaoyuanxinwen/{}.html'.format(i)

    allnews.extend(alist(listUrl))

len(allnews)
4.设置合理的爬取间隔
import time
import random
time.sleep(random.random()*3)
import time

import random

listUrl = 'http://news.gzcc.cn/html/xiaoyuanxinwen/'

allnews = alist(listUrl)

for i in range(1,170): #学号为7,截取10页

    listUrl = 'http://news.gzcc.cn/html/xiaoyuanxinwen/{}.html'.format(i)

    allnews.extend(alist(listUrl))

    time.sleep(random.random()*3) #设置每3秒爬取一次
print(alist(listUrl)) len(allnews)
5.用pandas做简单的数据处理并保存
保存到csv或excel文件
newsdf.to_csv(r'F:\duym\爬虫\gzccnews.csv')
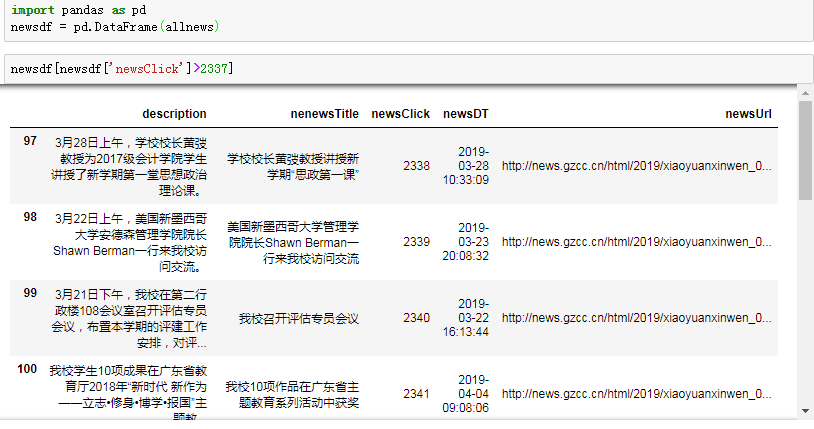
- 使用pandas函数整理爬取的数据
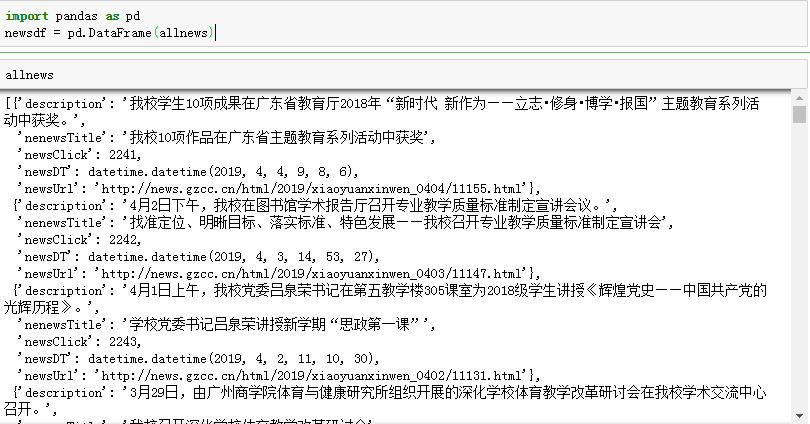
- 列表的形式打印数据
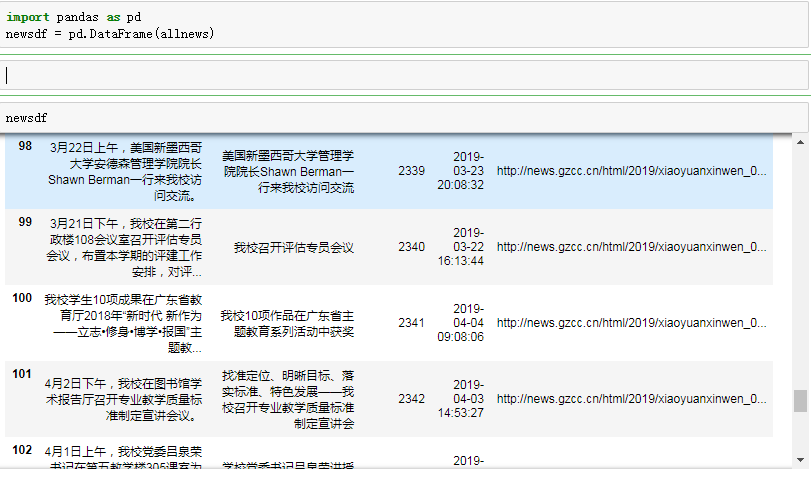
- 显示 “newsClick” 游览次数大于2337的新闻
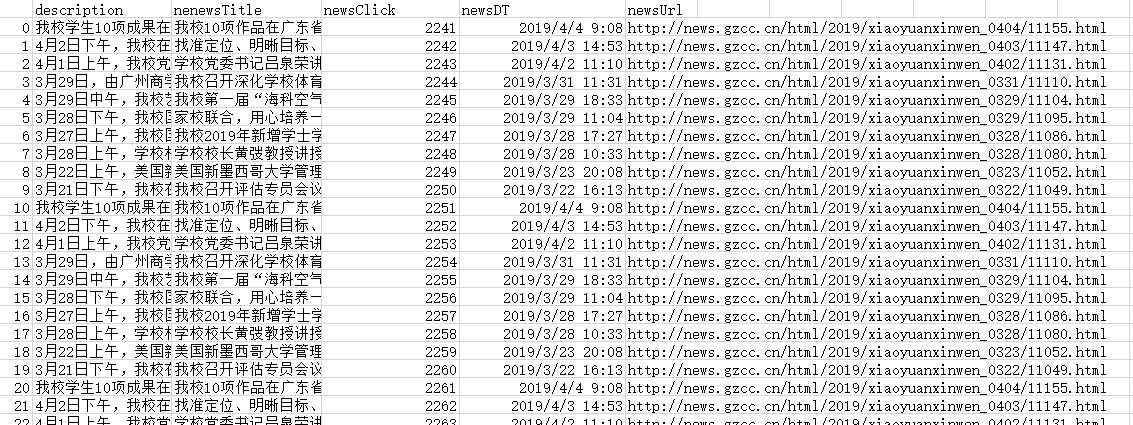
- 生成csv文件
newsdf.to_csv(r'E:\gzcc.csv')
菜鸟学IT之python网页爬取多页爬取的更多相关文章
- 菜鸟学IT之python网页爬取初体验
作业来源:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE1/homework/2881 1. 简单说明爬虫原理 爬虫简单来说就是通过程序模拟浏览器放松请求站 ...
- python实现一个栏目的分页抓取列表页抓取
python实现一个栏目的分页抓取列表页抓取 #!/usr/bin/env python # coding=utf-8 import requests from bs4 import Beautifu ...
- 菜鸟学IT之python词云初体验
作业来源:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE1/homework/2822 1. 下载一长篇中文小说. 2. 从文件读取待分析文本. txt = ...
- python网页爬虫开发之五-反爬
1.头信息检查是否频繁相同 随机产生一个headers, #user_agent 集合 user_agent_list = [ 'Mozilla/5.0 (Windows NT 6.1; WOW64 ...
- Python爬虫学习三------requests+BeautifulSoup爬取简单网页
第一次第一次用MarkDown来写博客,先试试效果吧! 昨天2018俄罗斯世界杯拉开了大幕,作为一个伪球迷,当然也得为世界杯做出一点贡献啦. 于是今天就编写了一个爬虫程序将腾讯新闻下世界杯专题的相关新 ...
- 初识python 之 爬虫:使用正则表达式爬取“糗事百科 - 文字版”网页数据
初识python 之 爬虫:使用正则表达式爬取"古诗文"网页数据 的兄弟篇. 详细代码如下: #!/user/bin env python # author:Simple-Sir ...
- 初识python 之 爬虫:使用正则表达式爬取“古诗文”网页数据
通过requests.re(正则表达式) 爬取"古诗文"网页数据. 详细代码如下: #!/user/bin env python # author:Simple-Sir # tim ...
- Python网页解析库:用requests-html爬取网页
Python网页解析库:用requests-html爬取网页 1. 开始 Python 中可以进行网页解析的库有很多,常见的有 BeautifulSoup 和 lxml 等.在网上玩爬虫的文章通常都是 ...
- python使用requests库爬取网页的小实例:爬取京东网页
爬取京东网页的全代码: #爬取京东页面的全代码 import requests url="https://item.jd.com/2967929.html" try: r=requ ...
随机推荐
- 【TensorFlow篇】--反向传播
一.前述 反向自动求导是 TensorFlow 实现的方案,首先,它执行图的前向阶段,从输入到输出,去计算节点值,然后是反向阶段,从输出到输入去计算所有的偏导. 二.具体 1.举例 图是第二个阶段,在 ...
- 【Spark篇】---Spark中Shuffle文件的寻址
一.前述 Spark中Shuffle文件的寻址是一个文件底层的管理机制,所以还是有必要了解一下的. 二.架构图 三.基本概念: 1) MapOutputTracker MapOutputTracker ...
- DateTimeHelper【日期类型与字符串互转以及日期对比相关操作】
版权声明:本文为HaiyuKing原创文章,转载请注明出处! 前言 实现日期和字符串之间的转换以及日期的相关操作: 1.日期格式的字符串输出为Date类型: 2.将Date类型以指定格式输出: 3.将 ...
- 实例分析C程序运行时的内存结构
先验知识 静态变量存储在静态存储区,局部变量存储在动态存储区(栈),代码存放在代码区 寄存器,EBP指向栈底,ESP指向栈顶,EIP指向正在执行指令的下一条指令,三个寄存器中保存的都是地址,32位 ...
- Wolsey "强整数规划“ 建模的+Leapms实践——无产能批量问题
Wolsey "强整数规划“ 建模的+Leapms实践——无产能批量问题 <整数规划>[1]一书作者L. A. Wolsey对批量问题(Lot-sizing Problem)做了 ...
- 修改VS2017新建类模板文件添加注释
找到Class.cs文件 找到VS2017安装目录下面的Class.cs文件,一般在C盘或者D盘 我的VS2017安装在D盘,所以在D盘以下目录找到 D:\Program Files (x86)\Mi ...
- C#——Nhibernate探索
C#—Nhibernate探索 本篇文章,让我们一起来探索Nhibernate. 首先我们去搜索Nhibernate下载地址,如下链接所示. 该版本可能是最新版,我下载的4.0.4.GA.其中GA意思 ...
- 浅谈Google Chrome浏览器(理论篇)
注解:各位读者,经博客园工作人员反馈,hosts涉及违规问题,我暂时屏蔽了最新hosts,若已经获取最新hosts的朋友们,注意保密,不要外传.给大家带来麻烦,对此非常抱歉!!! 开篇概述 1.详解g ...
- Powershell:关于PSCustomObject你想知道的一切(译)
PSCustomObject是Powershell里非常重要的一个工具,我们先从基础开始然后再循序渐进讲到一些更高级的话题.PSCustomObject旨在于用简单的方法来创建结构化数据.下面的第一个 ...
- Neo4j入门之中国电影票房排行浅析
什么是Neo4j? Neo4j是一个高性能的NoSQL图形数据库(Graph Database),它将结构化数据存储在网络上而不是表中.它是一个嵌入式的.基于磁盘的.具备完全的事务特性的Java持 ...