
Hadoop基础-Protocol Buffers串行化与反串行化
Hadoop基础-Protocol Buffers串行化与反串行化
作者:尹正杰
版权声明:原创作品,谢绝转载!否则将追究法律责任。
我们之前学习过很多种序列化文件格式,比如python中的pickle序列化方式(https://www.cnblogs.com/yinzhengjie/p/8531308.html),golang的Gob序列化方式(https://www.cnblogs.com/yinzhengjie/p/7807051.html),hadoop的SequenceFile序列化文件(https://www.cnblogs.com/yinzhengjie/p/9114301.html),Java内置的ObjectOutputStream序列化方式(https://www.cnblogs.com/yinzhengjie/p/8988003.html)等等。
当然,除了语言自己内置的序列化方式外,还有一些手动二进制编码的序列化文件,以及人性化可读格式的序列化文件,比如XMl,JSON,DOM,SAX,STAX,JAXB,JAXP等等,不过这些序列化方式都不是今天的主角,我今天要介绍的是Google公司在2008年就开源的一种序列化方式,即Protocol Buffers序列化。
一.Protocol Buffers 简介
1>.什么是 Protocol Buffers
第一:A description language(一种描述语言);
第二:A complier(它是一个编译器);
第三:A library(它是一种库);
2>.Protocol Buffers 优点
第一:易于使用,高效的二进制编码;
第二:它是由谷歌公司研发的;
第三:简单高效的串行化技术,在2008公开该技术;
3>.支持跨语言
官方支持:Java, C++, and Python等等
非官方支持:C, C#, Erlang, Perl, PHP, Ruby等等
二.Protocol Buffers 代码生成
1>.创建emp.proto自描述文件(非java文件,具体内容如下)
package tutorial;

option java_package = "tutorialspoint.com";

option java_outer_classname = "Emp2";

message Emp {

    required int32 id = 1;

    required string name = 2;

    required int32 age = 3;

    required int32 salary = 4;

    required string address = 5;

}
2>.将emp.proto(下载地址:链接:https://pan.baidu.com/s/1crYmFwI68kUnzwJgoyOdpw 密码:bh63)和protobuf\src\protoc.exe放在同一个文件夹
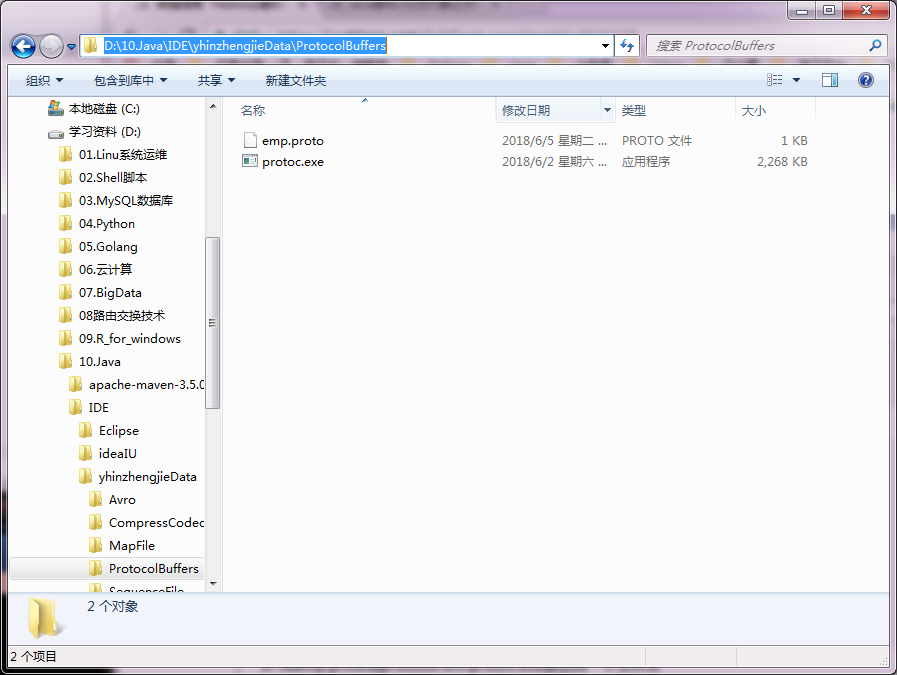
3>.编译emp.proto(protoc --java_out=. emp.proto)
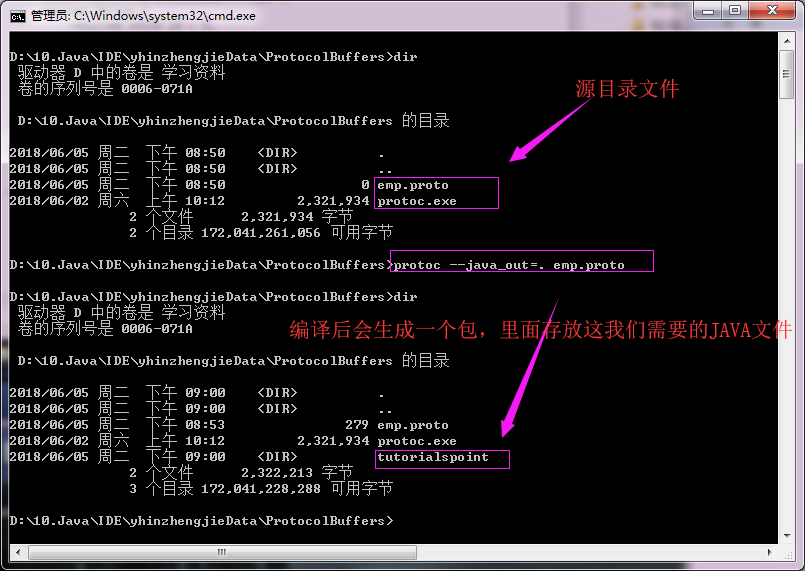
4>.将"D:\10.Java\IDE\yhinzhengjieData\ProtocolBuffers\tutorialspoint\com"(这是我本地目录)下的Emp2.java放置在idea中,包名“tutorialspoint.com”


三.编写代码
1>.编写串行化代码
 /*

 @author :yinzhengjie

 Blog:http://www.cnblogs.com/yinzhengjie/tag/Hadoop%E8%BF%9B%E9%98%B6%E4%B9%8B%E8%B7%AF/

 EMAIL:y1053419035@qq.com

 */

 package cn.org.yinzhengjie.protocolBuffers;

 import tutorialspoint.com.Emp2;

 import java.io.File;

 import java.io.FileOutputStream;

 public class MyProtocolBuffers {

     private static  final File protocolBuffers = new File("D:\\10.Java\\IDE\\yhinzhengjieData\\ProtocolBuffers\\emp.protocolBuffers");

     public static void main(String[] args) throws Exception {

         protocolBuffersSerial();

     }

     /**

      * 定义序列化方式

      */

     public static void protocolBuffersSerial() throws Exception {

         long start = System.currentTimeMillis();

         FileOutputStream fos = new FileOutputStream(protocolBuffers);

         //注意,在序列化一个对象的时候,都是打点的方式设置的哟!在设置完毕后需要以".build"结束!

         Emp2.Emp emp = Emp2.Emp.newBuilder().

                 setId(1).

                 setName("尹正杰").

                 setAge(18).

                 setSalary(66666666).

                 setAddress("北京").build();

         //我们循环写入数据

         for (int i = 0; i < 10000000; i++) {

             emp.writeTo(fos);

         }

         fos.close();

         System.out.printf("这是protocol Buffers序列化方式: 生成文件大小:[%d],用时:[%d]\n",protocolBuffers.length(),System.currentTimeMillis() - start);

     }

 }

 /*

 以上代码执行结果如下:

 这是protocol Buffers序列化方式: 生成文件大小:[280000000],用时:[10960]

  */
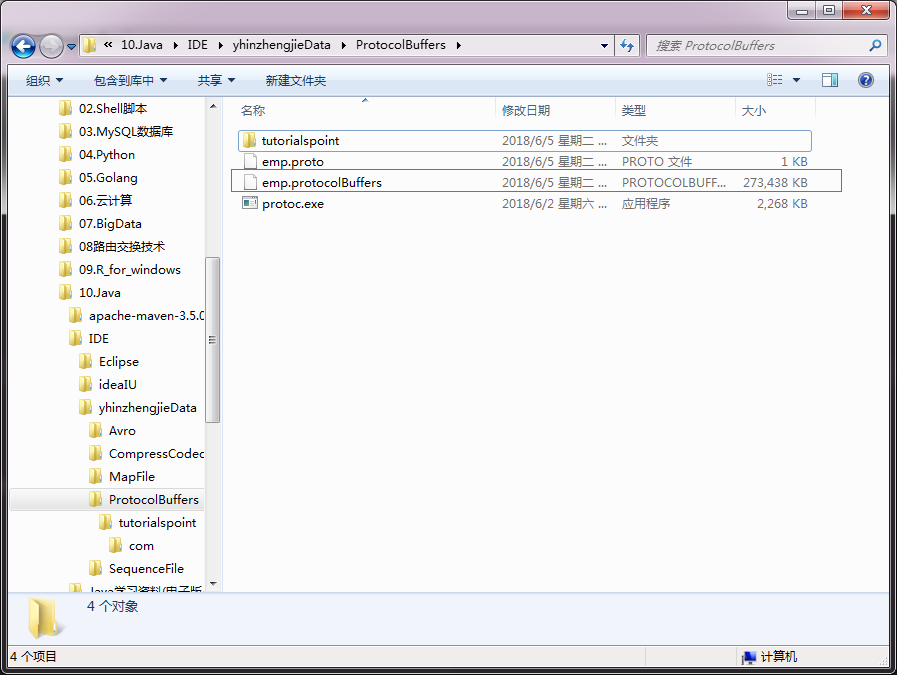
执行以上代码后,在本地目录会生成一个文件如下:
2>.编写反串行化代码
 /*

 @author :yinzhengjie

 Blog:http://www.cnblogs.com/yinzhengjie/tag/Hadoop%E8%BF%9B%E9%98%B6%E4%B9%8B%E8%B7%AF/

 EMAIL:y1053419035@qq.com

 */

 package cn.org.yinzhengjie.protocolBuffers;

 import tutorialspoint.com.Emp2;

 import java.io.File;

 import java.io.FileInputStream;

 import java.io.FileOutputStream;

 public class MyProtocolBuffers {

     private static  final File protocolBuffers = new File("D:\\BigData\\JavaSE\\yinzhengjieData\\ProtocolBuffers\\emp.protocolBuffers");

     public static void main(String[] args) throws Exception {

         protocolBuffersSerial();

         protocolBuffersDeserial();

     }

     /**

      * 定义序列化方式

      */

     public static void protocolBuffersSerial() throws Exception {

         long start = System.currentTimeMillis();

         FileOutputStream fos = new FileOutputStream(protocolBuffers);

         //注意,在序列化一个对象的时候,都是打点的方式设置的哟!在设置完毕后需要以".build"结束!

         Emp2.Emp emp = Emp2.Emp.newBuilder().

                 setId(1).

                 setName("尹正杰").

                 setAge(18).

                 setSalary(66666666).

                 setAddress("北京").build();

         //我们循环写入数据

         for (int i = 0; i < 2000000; i++) {

             emp.writeTo(fos);

         }

         fos.close();

         System.out.printf("这是protocol Buffers序列化方式: 生成文件大小:[%d],用时:[%d]\n",protocolBuffers.length(),System.currentTimeMillis() - start);

     }

     /**

      * 定义反序列化方式

      */

     public static void protocolBuffersDeserial() throws Exception {

         long start = System.currentTimeMillis();

         FileInputStream fis = new FileInputStream(protocolBuffers);

         Emp2.Emp emp = Emp2.Emp.parseFrom(fis);

         for (int i = 0; i < 2000000; i++) {

             emp.getId();

             emp.getName();

             emp.getAge();

             emp.getSalary();

             emp.getAddress();

         }

         System.out.printf("这是protocol Buffers反序列化方式: 生成文件大小:[%d],用时:[%d]\n",protocolBuffers.length(),System.currentTimeMillis() - start);

     }

 }
Hadoop基础-Protocol Buffers串行化与反串行化的更多相关文章
- Hadoop基础-Apache Avro串行化的与反串行化
Hadoop基础-Apache Avro串行化的与反串行化 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.Apache Avro简介 1>.Apache Avro的来源 ...
- PHP中的抽象类与抽象方法/静态属性和静态方法/PHP中的单利模式(单态模式)/串行化与反串行化(序列化与反序列化)/约束类型/魔术方法小结
前 言 OOP 学习了好久的PHP,今天来总结一下PHP中的抽象类与抽象方法/静态属性和静态方法/PHP中的单利模式(单态模式)/串行化与反串行化(序列化与反序列化). 1 PHP中的抽象 ...
- C#基础知识回顾--串行化与反串行化
串行化是指存储和获取磁盘文件.内存或其他地方中的对象.在串行化时,所有的实例数据都保存到存储介质上, 在取消串行化时,对象会被还原,且不能与其原实例区别开来.只需给类添加Serializable属性, ...
- C#--串行化与反串行化
串行化是指存储和获取磁盘文件.内存或其他地方中的对象.在串行化时,所有的实例数据都保存到存储介质上,在取消串行化时,对象会被还原,且不能与其原实例区别开来.只需给类添加Serializable属性,就 ...
- Hadoop基于Protocol Buffer的RPC实现代码分析-Server端
http://yanbohappy.sinaapp.com/?p=110 最新版本的Hadoop代码中已经默认了Protocol buffer(以下简称PB,http://code.google.co ...
- Protocol Buffers学习教程
最近看公司代码的过程中,看到了很多proto后缀的文件,这是个啥玩意?问了大佬,原来这是Protocol Buffers! 这玩意是干啥的?查完资料才知道,又是谷歌大佬推的开源组件,这玩意完全可以取代 ...
- Google Protocol Buffers 入门
Google Protocol Buffers 是一种轻便高效的结构化数据存储格式,可以用于结构化数据串行化,或者说序列化.它很适合做数据存储或 RPC 数据交换格式.可用于通讯协议.数据存储等领域的 ...
- Hadoop基础-MapReduce的常用文件格式介绍
Hadoop基础-MapReduce的常用文件格式介绍 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.MR文件格式-SequenceFile 1>.生成SequenceF ...
- Hadoop基础-MapReduce的工作原理第二弹
Hadoop基础-MapReduce的工作原理第二弹 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.Split(切片) 1>.MapReduce处理的单位(切片) 想必 ...
随机推荐
- java程序设计课程实验报告1
北京电子科技学院(BESTI) 实 验 报 告 课程:Java程序设计 班级:1353 姓名:陈都 学号:20135328 成绩: 指导 ...
- beat冲刺(4/7)
目录 摘要 团队部分 个人部分 摘要 队名:小白吃 组长博客:hjj 作业博客:beta冲刺(4/7) 团队部分 后敬甲(组长) 过去两天完成了哪些任务 整理博客 ppt模板 接下来的计划 做好机动. ...
- 05_Java基础语法_第5天(方法)_讲义
今日内容介绍 1.方法基础知识 2.方法高级内容 3.方法案例 01方法的概述 * A: 为什么要有方法 * 提高代码的复用性 * B: 什么是方法 * 完成特定功能的代码块. 02方法的定义格式 * ...
- WPF自学入门(十二)WPF MVVM模式提取函数
我们平时在写代码时为了不重复写代码,会进行复制代码或者写通用方法.今天我们就来把上传做的函数提取成为通用的方法调用.把上次写的函数提取为两个主要的文件:ObserableObject和RelayCom ...
- es6 javascript对象方法Object.assign()
es6 javascript对象方法Object.assign() 2016年12月01日 16:42:34 阅读数:38583 1 基本用法 Object.assign方法用于对象的合并,将源对象 ...
- Powershell笔记之MVA课程
很早之前看过MVA的Powershell课程,最近准备回顾一下,还是有一些意外的收获. <<快速入门 : PowerShell 3.0 高级工具和脚本>> 1. Invoke- ...
- vi命令文件编辑
vi命令是UNIX操作系统和类UNIX操作系统中最通用的全屏幕纯文本编辑器. Linux中的vi编辑器叫vim,它是vi的增强版(vi Improved),与vi编辑器完全兼容,而且实现了很多增强功能 ...
- 【大数据】Kafka学习笔记
第1章 Kafka概述 1.1 消息队列 (1)点对点模式(一对一,消费者主动拉取数据,消息收到后消息清除) 点对点模型通常是一个基于拉取或者轮询的消息传送模型,这种模型从队列中请求信息,而不是将消息 ...
- LDA-Latent Dirichlet Allocation 学习笔记
以下内容主要基于<Latent Dirichlet Allocation>,JMLR-2003一文,另加入了一些自己的理解,刚开始了解,有不对的还请各位指正. LDA-Latent Dir ...
- BZOJ5321 JXOI2017加法(二分答案+贪心+堆+树状数组)
二分答案后得到每个位置需要被加的次数.考虑贪心.从左到右考虑每个位置,将以该位置为左端点的区间按右端点从大到小加进堆.看该位置还需要被加多少次,如果不需要加了就不管,否则取堆顶区间将其选择,BIT实现 ...