
Python和BeautifulSoup进行网页爬取
在大数据、人工智能时代,我们通常需要从网站中收集我们所需的数据,网络信息的爬取技术已经成为多个行业所需的技能之一。而Python则是目前数据科学项目中最常用的编程语言之一。使用Python与BeautifulSoup可以很容易的进行网页爬取,通过网站爬虫获取信息可以帮助企业或个人节省很多的时间和金钱。学习本文之后,我相信大部分新手都能根据自己的需求来开发出相应的网页爬虫。
基础条件
了解简单的Python编程规则(Python 3.x)了解简单的网页Html标签
如果您是完全的新手也不用担心,通过本文您可以很容易地理解。
安装所需包
首先,您需要先安装好Python 3.x,Python安装包可以从python.org下载,然后我们需要安装requests和beautifulsoup4两个包,安装代码如下:
$ pip install requests

$ pip install beautifulsoup4
爬取网页数据
现在我们已经做好了一切准备工作。在本教程中,我们将演示从没被墙的维基百科英文版页面中获取历届美国总统名单。
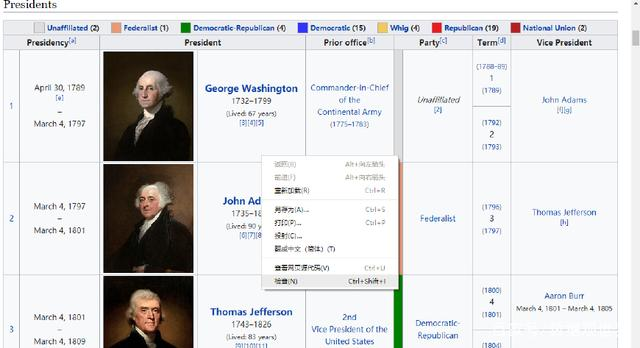
由下图可知,表格的内容位于class属性为wikitable的table标签下,我们需要了解这些标签信息来获取我们所需内容。
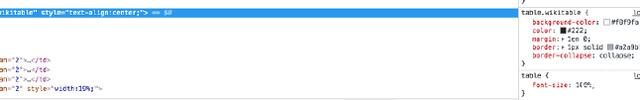
了解网页信息之后,我们就可以编写代码了。首先,我们要导入我们安装的包:
import requests
from bs4 import BeautifulSoup
为了获取网页数据我们要使用requests的get()方法:
url = "https://en.wikipedia.org/wiki/List_of_Presidents_of_the_United_States"
page = requests.get(url)
检查http响应状态,来确保我们能正常获取网页,如果输出状态代码为200则为正常:
print(page.status_code)
现在我们已经获取了网页数据,让我们看看我们得到了什么:
print(page.content)
上面的代码会显示http相应的全部内容,包括html代码和我们需要的文本数据信息。通过使用beautifulsoup的prettify()方法可以将其更美观的展示出来:
soup = BeautifulSoup(page.content, 'html.parser')
print(soup.prettify())
这会将数据按照我们上面“检查”中看到的代码形式展示出来:
接下来我们将使用bs4对象的find方法提取table标签中的数据,此方法返回bs4对象:
tb = soup.find('table', class_='wikitable')
table标签下有很多嵌套标签,通过网页检查中的代码可以发现,我们最终是需要获得title元素中的文本数据,而title元素位于a标签下,a标签位于b标签下,b标签位于table标签下。为了获取所有我们所需的数据,我们需要提取table标签下的所有b标签,然后找到b标签下的所有a标签,为此,我们使用find_all方法来迭代获取所有b标签下的a标签:
for link in tb.find_all('b'):
name = link.find('a')
print(name)
可以看出,这并不是我们所要的最终结果,其中掺杂着html代码,不用担心,我们只需为上面的代码添加get_text()方法,即可提取出所有a标签下title元素的文本信息,代码改动如下:
for link in tb.find_all('b'):
    name = link.find('a')
    print(name.get_text('title'))
最终获得所有总统的名单如下:
George Washington
John Adams
Thomas Jefferson
James Monroe
。。。
Python和BeautifulSoup进行网页爬取的更多相关文章
- 在Python中使用BeautifulSoup进行网页爬取
目录 什么是网页抓取? 为什么我们要从互联网上抓取数据? 网站采集合法吗? HTTP请求/响应模型 创建网络爬虫 步骤1:浏览并检查网站/网页 步骤2:创建用户代理 步骤3:导入请求库 检查状态码 步 ...
- 如何利用python模仿浏览器进行网页爬取?
http://wwwsearch.sourceforge.net/mechanize/ http://www.ibm.com/developerworks/cn/linux/l-python-mech ...
- Python爬虫:为什么你爬取不到网页数据
前言: 之前小编写了一篇关于爬虫为什么爬取不到数据文章(文章链接为:Python爬虫经常爬不到数据,或许你可以看一下小编的这篇文章), 但是当时小编也是胡乱编写的,其实里面有很多问题的,现在小编重新发 ...
- Python爬虫——request实例:爬取网易云音乐华语男歌手top10歌曲
requests是python的一个HTTP客户端库,跟urllib,urllib2类似,但比那两个要简洁的多,至于request库的用法, 推荐一篇不错的博文:https://cuiqingcai. ...
- 【学习笔记】Python 3.6模拟输入并爬取百度前10页密切相关链接
[学习笔记]Python 3.6模拟输入并爬取百度前10页密切相关链接 问题描述 通过模拟网页,实现百度搜索关键词,然后获得网页中链接的文本,与准备的文本进行比较,如果有相似之处则代表相关链接. me ...
- python爬虫学习01--电子书爬取
python爬虫学习01--电子书爬取 1.获取网页信息 import requests #导入requests库 ''' 获取网页信息 ''' if __name__ == '__main__': ...
- Python网络爬虫与如何爬取段子的项目实例
一.网络爬虫 Python爬虫开发工程师,从网站某一个页面(通常是首页)开始,读取网页的内容,找到在网页中的其它链接地址,然后通过这些链接地址寻找下一个网页,这样一直循环下去,直到把这个网站所有的网页 ...
- 使用urllib进行网页爬取
# coding=gbk # 抓取开奖号码 # url:http://datachart.500.com/dlt/zoushi/jbzs_foreback.shtml ''' 对网页逐行迭代,找到目标 ...
- WebFetch 是无依赖极简网页爬取组件
WebFetch 是无依赖极简网页爬取组件,能在移动设备上运行的微型爬虫. WebFetch 要达到的目标: 没有第三方依赖jar包 减少内存使用 提高CPU利用率 加快网络爬取速度 简洁明了的api ...
随机推荐
- django-URL之从URL中获取关键字(七)
主要用于查询操作. 主要目录 book/views.py from django.http import HttpResponse from django.shortcuts import rende ...
- fenby C语言 P28
#include <stdio.h> int main(){ int *p1,*p2,a=10,b=20,c; p1=&a; p2=&b; if(a<b) { c=a ...
- Unity资源加载路径及加载方式小结
Unity3D中的资源路径路径属性 路径说明Application.dataPath 此属性用于返回程序的数据文件所在文件夹的路径.例如在Editor中就是Assets了.Application.st ...
- 使用memset初始化int数组
memset()是一个来自于string库的函数,正规用法是初始化char类型的数组.因为char类型只占1个字节,memset按字节赋值后,会将char类型数组的所有元素变为你指定的值.但是4字节的 ...
- [专题总结]AC自动机
其实前面的模板也不是1A,我在题库里提前做过,也不必在意罚时,刚开始我在做别的专题 裸模板我就不说了,各个博客讲解的很明白 void insert(string s){ ,len=s.size(); ...
- Jquery+CSS在不使用Checked的情况下实现当前选中行样式变化
之前在做一个当前选中行样式变化时发现网上很多方法都是利用在行内添加checked,然后通过checked是否选中来判断当前选中行的位置,今天就整理了一个不需要在行内添加其他按钮直接通过变化当前选中行的 ...
- formdata,ajax提交数据
var data = document.getElementById("#dataForm"); var formData = new FormData(data); var ac ...
- 考试T3麻将
这题就是一个简单的暴力,但考试的时候不知道脑子在想什么,什么都没打出来,也许是我想的太多了... 这道题对于不会打麻将的人来说还是有点难理解规则的,我没说过我会打麻将,这里是题目链接. 20分思路,利 ...
- python机器学习——自适应线性神经元
上篇博客我们说了感知器,这篇博客主要记录自适应线性神经元的实现算法及一些其他的训练细节,自适应线性神经元(简称为Adaline)由Bernard Widrow和他的博士生Tedd Hoff提出,对感知 ...
- Linux学习(推荐学习资源)——保持更新
1. 介绍 Linux是一套免费使用和自由传播的类Unix操作系统,是一个基于POSIX和Unix的多用户.多任务.支持多线程和多CPU的操作系统.它能运行主要的Unix工具软件.应用程序和网络协议. ...