
Python爬虫的开始——requests库建立请求
接下来我将会用一段时间来更新python爬虫
网络爬虫大体可以分为三个步骤。
首先建立请求,爬取所需元素;
其次解析爬取信息,剔除无效数据;
最后将爬取信息进行保存;
今天就先来讲讲第一步,请求库requests
request库主要有七个常用函数,如下所示
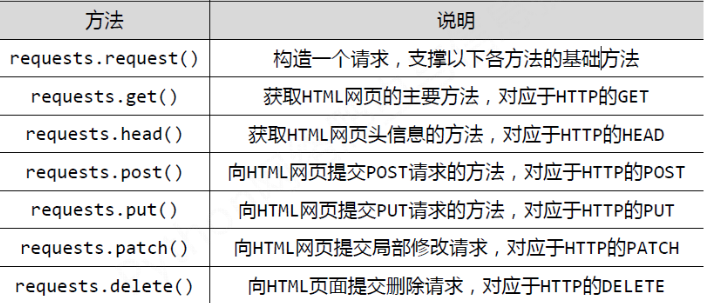
而通过requests创建的数据类型为response
我们以爬取百度网站为例
import requests as r

t=r.get("https://www.baidu.com/")

print(type(t))
运行结果如下所示
<class 'requests.models.Response'>
[Finished in 1.3s]
那么作为请求对象,具有哪些属性呢?
爬取数据第一步要做的事便是确认是否连接成功
status_code()从功能角度考虑,算的上是一种判断函数,调用将会返还结果是否成功
如果返回结果为200,则代表连接成功,如果返回结果为404,则代表连接失败
import requests as r

t=r.get("https://www.baidu.com/")

print(type(t))

print(t.status_code)
如图所示返回结果为200,连接成功

那么下一步便是获得网址代码,不过在获得代码之前,还需要做一件事,得到响应内容的编码方式
不同的编码方式将会影响爬取结果
比如说百度网址:https://www.baidu.com/
采用编码方式为ISO-8859-1
获取编码方式为encoding
如下所示
import requests as r

t=r.get("https://www.baidu.com/")

print(type(t))

print(t.status_code)

print(t.encoding)
结果:
<class 'requests.models.Response'>
200
ISO-8859-1
当然有的网页采用 utf8,也有使用gbk,
不同的编码方式会影响我们获得的源码
也可以通过手动更改来改变获得的编码方式
比如:
import requests as r

t=r.get("https://www.baidu.com/")

print(t.encoding)

t.encoding="utf-8"

print(t.encoding)
结果
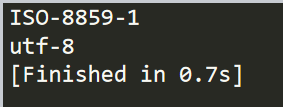
也可以试着备选码方式,apparent_encoding
之后我们就可以获得源代码了,我们需要将源代码以字符串类型输出保存
这就需要用到text
如下所示:
import requests as r

t=r.get("https://www.baidu.com/")

print(t.text)
结果:

这样我们就获得了对应网站的源码,完成了爬虫的第一步
Python爬虫的开始——requests库建立请求的更多相关文章
- python爬虫之一:requests库
目录 安装requtests requests库的连接异常 HTTP协议 HTTP协议对资源的操作 requests库的7个主要方法 request方法 get方法 网络爬虫引发的问题 robots协 ...
- PYTHON 爬虫笔记三:Requests库的基本使用
知识点一:Requests的详解及其基本使用方法 什么是requests库 Requests库是用Python编写的,基于urllib,采用Apache2 Licensed开源协议的HTTP库,相比u ...
- 芝麻HTTP: Python爬虫利器之Requests库的用法
前言 之前我们用了 urllib 库,这个作为入门的工具还是不错的,对了解一些爬虫的基本理念,掌握爬虫爬取的流程有所帮助.入门之后,我们就需要学习一些更加高级的内容和工具来方便我们的爬取.那么这一节来 ...
- 【python爬虫】用requests库模拟登陆人人网
说明:以前是selenium登陆取cookie的方法比较复杂,改用这个 """ 用requests库模拟登陆人人网 """ import r ...
- 网络爬虫入门:你的第一个爬虫项目(requests库)
0.采用requests库 虽然urllib库应用也很广泛,而且作为Python自带的库无需安装,但是大部分的现在python爬虫都应用requests库来处理复杂的http请求.requests库语 ...
- Python爬虫入门——使用requests爬取python岗位招聘数据
爬虫目的 使用requests库和BeautifulSoup4库来爬取拉勾网Python相关岗位数据 爬虫工具 使用Requests库发送http请求,然后用BeautifulSoup库解析HTML文 ...
- Python使用urllib,urllib3,requests库+beautifulsoup爬取网页
Python使用urllib/urllib3/requests库+beautifulsoup爬取网页 urllib urllib3 requests 笔者在爬取时遇到的问题 1.结果不全 2.'抓取失 ...
- python爬虫之re正则表达式库
python爬虫之re正则表达式库 正则表达式是用来简洁表达一组字符串的表达式. 编译:将符合正则表达式语法的字符串转换成正则表达式特征 操作符 说明 实例 . 表示任何单个字符 [ ] 字符集,对单 ...
- 从0开始学爬虫9之requests库的学习之环境搭建
从0开始学爬虫9之requests库的学习之环境搭建 Requests库的环境搭建 环境:python2.7.9版本 参考文档:http://2.python-requests.org/zh_CN/l ...
随机推荐
- iOS编译Unity3d文件报错 Permission denied
最近在尝试Unity3d的使用,毕竟Unity可以很好的编译出iOS代码,只用我们正常进行打包就好了. 这里遇到了个问题,分享一下. Archive快结束的时候,报了三个错误,类似于 /Users/s ...
- JavaWeb EL表达式 key为数值 Map取不到值
JavaWeb EL表达式 key为 Map取不到值 因为JSTL会把Integer,Byte,Short,Charactor都转成Long,这样就取不到值. 参见StackOverFlow的回答 ...
- Andriod一段时间未操作页面,系统自动登出
功能描述: APP在公共的设备上运行,出于安全考虑,当登录的用户在超过一定时间内没有做任何操作, 则系统自动登出,用户如需重新操作APP,则需要重新登录 . 第一步:创建一个BaseActivity ...
- SpringBoot整合FastJson(七)
一.Maven依赖 <dependency> <groupId>com.alibaba</groupId> <artifactId>fastjson&l ...
- 使用grep过滤make的输出内容
make的输出内容其实分为两种,有些是到标准输出,有些是到标准错误,由于标准输出和标准错误默认都是屏幕,所以平时区分不出来, 实际上一般是error和warning信息到标准错误,其余的到标准输出. ...
- 虚拟环境:virtualenv与virtualenvwrapper
前言: 在使用 Python 开发的过程中,工程一多,难免会碰到不同的工程依赖不同版本的库的问题: 亦或者是在开发过程中不想让物理环境里充斥各种各样的库,引发未来的依赖灾难. 此时,我们需要对于不同的 ...
- Method Not Allowed (GET): /boxuegos/index/ 错误
1,Method Not Allowed (GET) 请求方法不被允许, 错误原因:我调用的是index这个方法,但是我上面定义了一个空的子路由,所以页面加载不了,控制台出现Method Not Al ...
- Spring Boot 2.X(十五):集成 Swagger2 开发 API 文档(在线+离线)
前言 相信很多后端开发在项目中都会碰到要写 api 文档,不管是给前端.移动端等提供更好的对接,还是以后为了以后交接方便,都会要求写 api 文档. 而手写 api 文档的话有诸多痛点: 文档更新的时 ...
- RTKLib的Manual解读
Key-word: integer ambiguity resolution :整周模糊度解算 navigation:导航 Kinematic:动态,RTK的K rover:漫游 validation ...
- [Spark]Spark-streaming通过Receiver方式实时消费Kafka流程(Yarn-cluster)
1.启动zookeeper 2.启动kafka服务(broker) [root@master kafka_2.11-0.10.2.1]# ./bin/kafka-server-start.sh con ...