
假期学习【十一】Python切词,以及从百度爬取词典
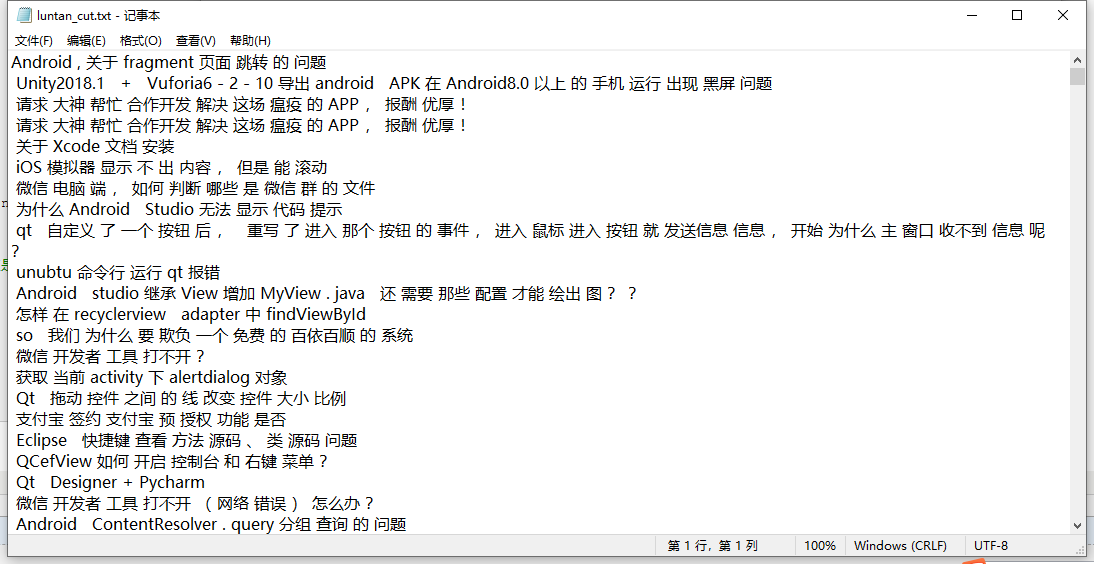
今天主要对从CSDN爬取的标题利用jieba(结巴)进行分词,但在分词过程中发现,如大数据被分成了大/数据,云计算被分隔成了云/计算。
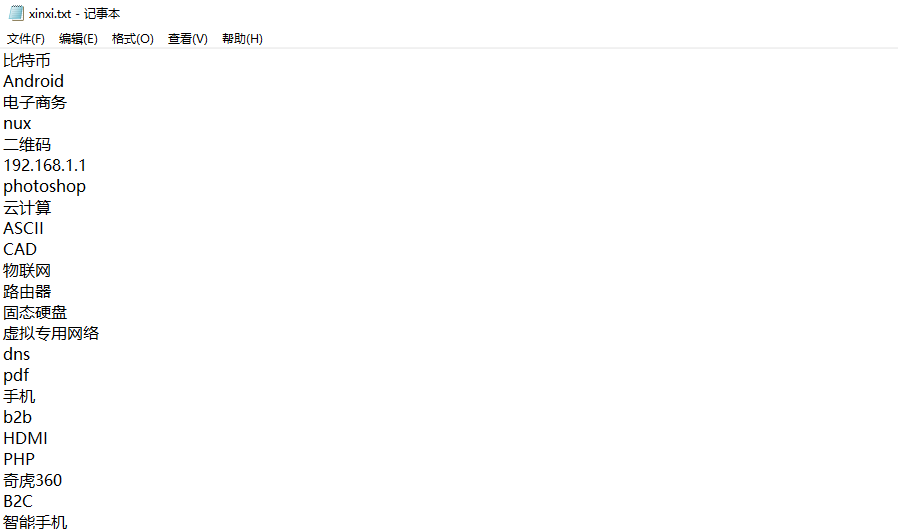
后来又从百度百科---》信息领域爬取了相关词语作为词典,预计今天晚上完成切词任务。
其中分割代码如下:
 import jieba

 import io

 #对句子进行分词

 def cut():

     f=open("E://luntan.txt","r+",encoding="utf-8")

     for line in f:

         seg_list=jieba.cut(line)

         #print(' '.join(seg_list))

         for i in seg_list:

             print(i)

             write(i+" ")

         #write(' '.join(seg_list))

 #分词后写入

 def write(contents):

     f=open("E://luntan_cut.txt","a+",encoding="utf-8")

     f.write(contents)

     print("写入成功!")

     f.close()

 #创建停用词

 def stopwordslist(filepath):

     stopwords = [line.strip() for line in open(filepath, 'r', encoding='utf-8').readlines()]

     return stopwords

 # 对句子进行去除停用词

 def seg_sentence(sentence):

     sentence_seged = jieba.cut(sentence.strip())

     stopwords = stopwordslist('E://stop.txt')  # 这里加载停用词的路径

     outstr = ''

     for word in sentence_seged:

         if word not in stopwords:

             if word != '\t':

                 outstr += word

                 outstr += " "

     return outstr

 #循环去除

 def cut_all():

     inputs = open('E://luntan_cut.txt', 'r', encoding='utf-8')

     outputs = open('E//luntan_stop', 'w')

     for line in inputs:

         line_seg = seg_sentence(line)  # 这里的返回值是字符串

         outputs.write(line_seg + '\n')

     outputs.close()

     inputs.close()

 if __name__=="__main__":

     cut()
分割后的文本
从百度爬取词典要把百度页面 地址:https://baike.baidu.com/wikitag/taglist?tagId=76607
该页拉到最下,并存为本地mhtml格式,在浏览器打开然后右击查看源代码,源代码保存为txt格式文件,
代码如下:
 import io

 import re

 patton=re.compile(r'title=".*"')

 def read():

     f=open("E://mhtml.txt","r+",encoding="utf-8")

     for line in f:

         line=line.rstrip("\n")

         m=patton.findall(line)

         #print(line)

         if len(m)!=0:

             print(m)

             write(str(m).lstrip("['title=\"").rstrip("\"']")+"\r")

 def write(contents):

     f=open("E://xinxi.txt","a+",encoding="utf-8")

     f.write(contents)

     print("写入成功!")

     f.close()

 if __name__=="__main__":

     read()
效果:
假期学习【十一】Python切词,以及从百度爬取词典的更多相关文章
- 【学习笔记】Python 3.6模拟输入并爬取百度前10页密切相关链接
[学习笔记]Python 3.6模拟输入并爬取百度前10页密切相关链接 问题描述 通过模拟网页,实现百度搜索关键词,然后获得网页中链接的文本,与准备的文本进行比较,如果有相似之处则代表相关链接. me ...
- Python爬虫实战二之爬取百度贴吧帖子
大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 前言 亲爱的们,教程比较旧了,百度贴吧页面可能改版,可能代码不 ...
- 转 Python爬虫实战二之爬取百度贴吧帖子
静觅 » Python爬虫实战二之爬取百度贴吧帖子 大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 本篇目标 ...
- python爬虫:了解JS加密爬取网易云音乐
python爬虫:了解JS加密爬取网易云音乐 前言 大家好,我是"持之以恒_liu",之所以起这个名字,就是希望我自己无论做什么事,只要一开始选择了,那么就要坚持到底,不管结果如何 ...
- Python爬虫:为什么你爬取不到网页数据
前言: 之前小编写了一篇关于爬虫为什么爬取不到数据文章(文章链接为:Python爬虫经常爬不到数据,或许你可以看一下小编的这篇文章), 但是当时小编也是胡乱编写的,其实里面有很多问题的,现在小编重新发 ...
- Python网络爬虫与如何爬取段子的项目实例
一.网络爬虫 Python爬虫开发工程师,从网站某一个页面(通常是首页)开始,读取网页的内容,找到在网页中的其它链接地址,然后通过这些链接地址寻找下一个网页,这样一直循环下去,直到把这个网站所有的网页 ...
- Python爬虫实战一之爬取糗事百科段子
大家好,前面入门已经说了那么多基础知识了,下面我们做几个实战项目来挑战一下吧.那么这次为大家带来,Python爬取糗事百科的小段子的例子. 首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把 ...
- 转 Python爬虫实战一之爬取糗事百科段子
静觅 » Python爬虫实战一之爬取糗事百科段子 首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把,这次我们尝试一下用爬虫把他们抓取下来. 友情提示 糗事百科在前一段时间进行了改版,导致 ...
- Python爬虫:通过关键字爬取百度图片
使用工具:Python2.7 点我下载 scrapy框架 sublime text3 一.搭建python(Windows版本) 1.安装python2.7 ---然后在cmd当中输入python,界 ...
随机推荐
- indexedDB 使用
数据库的打开/新增/删除 initDB() { let _this = this; let obj = { id: 1, name: _this.addForm.content } let index ...
- 惊讶!缓存刚Put再Get居然获取不到?
最近一直在老家远程办公,微信突然响了下,有同事说遇到了一个奇怪的问题,让我帮忙看下. 现象就是标题所说的缓存获取不到的问题,我一听感觉这个问题挺有意思的,决定一探究竟. 下面给出部分代码还原下案发现场 ...
- R12客户表结构分析
客户表/联系人/PARTY关联 HZ_PARTIES 客户账户表 HZ_CUST_ACCOUNTS 例子: select hp.party_number --客户注册标识 ...
- GitLab Container Registry
通过将GitLab Container Registry集成到GitLab中,每个项目都可以拥有自己的空间来存储其Docker镜像. 1. 启用Container Registry 如果在你的项目的侧 ...
- MySQL 什么是索引?
该文为< MySQL 实战 45 讲>的学习笔记,感谢查看,如有错误,欢迎指正 一.索引简介 索引就类似书本的目录,作用就是方便我们更加快速的查找到想要的数据. 索引的实现方式比较多,常见 ...
- mongo curd
常用命令 未完待续...
- Python 编程入门(2):复杂数据类型(列表,字典)
以下所有例子都基于最新版本的 Python,为了便于消化,每一篇都尽量短小精悍,希望你能尽力去掌握 Python 编程的「概念」,可以的话去动手试一下这些例子(就算目前还没完全搞懂),加深理解. 在 ...
- rxjs简单的Observable用例
import React from 'react'; import { Observable } from 'rxjs'; const FlowPage = () => { const onSu ...
- GitHook 工具 —— husky介绍及使用
名称 githooks-Git使用的挂钩.(githook在官网的介绍) 描述 如同其他许多的版本控制系统一样,Git 也具有在特定事件发生之前或之后执行特定脚本代码功能(从概念上类比,就与监听事件. ...
- netty 的事件驱动
netty 是事件驱动的,这里面有两个含义,一是 netty 接收到 socket 数据后,会产生事件,事件在 pipeline 上传播,二是事件由特定的线程池处理. NioEventLoop 轮询网 ...